
Главное
- Fable 5.2 подходит для самых сложных задач, GPT-6.1 Sol — для больших объёмов. В Artificial Analysis Intelligence Index на максимальном effort Fable 5.2 набирает 65 баллов, а GPT-6.1 Sol — 55, причём Sol выполняет каждую задачу индекса за малую долю стоимости.
- Официальные цены токенов: $8 / $40 за миллион входных/выходных токенов у Fable 5.2 и $2 / $10 у Sol при коротком контексте — разница в 4 раза.
- Единый тариф в PoYo. OpenAI повышает цену всего запроса Sol до $4 / $15, если во вводе больше 272K токенов. В PoYo GPT-6.1 Sol стоит $1.60 / $8 во всём окне контекста, а Fable 5.2 — $6.40 / $32 во всём окне 1M.
- Fable 5.2 вкладывает в каждую задачу больше рассуждений. Artificial Analysis насчитала $26.54 за задачу индекса у Fable 5.2 на максимальном effort и $1.27 у Sol.
- Fable 5.2 быстро выходит на высокие результаты. На effort
lowона набирает 54 балла — почти как Sol наmax(55) — и выполняет задачу индекса за 5.8 минуты против 23.3. - Ищете «GPT-5.6 Sol vs Fable 5»? Это было противостояние июля 2026 года. С тех пор обе линейки ушли вперёд; старой паре посвящён отдельный раздел ниже.
Claude Fable 5.2 и GPT-6.1 Sol: краткий обзор
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Разработчик | Anthropic | OpenAI |
| ID модели в API | claude-fable-5-2 | gpt-6.1-sol |
| Дата выхода | 9 ноября 2026 | 29 сентября 2026 |
| Позиция | Верхний уровень Anthropic, выше Opus | Уровень Sol у OpenAI, между GPT-6 Astra и GPT-6 Luna |
| Окно контекста | 1M токенов | 1 050 000 токенов (максимум ввода 922 000) |
| Максимальный вывод | 128K токенов | 128K токенов |
| Ввод → вывод | Текст и изображения → текст | Текст и изображения → текст |
| Управление рассуждениями | output_config.effort | reasoning.effort |
| Уровни effort | От low до max, по умолчанию high | От low до max, по умолчанию medium |
| Дата среза знаний | Июнь 2026 | 30 апреля 2026 |
| Официальный ввод / вывод (за 1M) | $8 / $40 | $2 / $10 (ввод ≤272K) $4 / $15 (ввод >272K) |
| Официальное чтение из кэша (за 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| Ввод / вывод в PoYo (за 1M) | $6.40 / $32 | $1.60 / $8 |
| Конечные точки PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol и Fable 5: какие версии вы сравниваете?
Большинство страниц, которые находятся по запросу «GPT-5.6 Sol vs Fable 5», написаны в июле 2026 года, когда эти две модели были самыми новыми. С тех пор в каждой линейке вышли новые версии:
| Модель | Разработчик | Дата выхода | Официальный ввод / вывод на запуске (за 1M, короткий контекст) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9 июня 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9 июля 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1 сентября 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22 сентября 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29 сентября 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9 ноября 2026 | $8 / $40 |
GPT-5.6 Sol и Claude Fable 5: противостояние июля 2026 года
На запуске GPT-5.6 Sol стоил вдвое дешевле Fable 5 за ввод и на 40% дешевле за вывод ($5 / $30 против $10 / $50, кэшированный ввод — $0.50 против $1). Независимые тесты того месяца разошлись в выводах:
| Тест | Условия | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: три плана проектирования систем | Kilo Code CLI, обе модели на максимальном уровне рассуждений, оценка по заранее составленной рубрике | Лучший результат во всех трёх задачах — после того как модель сама проверила и доработала каждый план; в среднем 52 мин 53 с на план; всего $13.57 | Планы, по которым тестировщикам было проще всего вести разработку; в среднем 15 мин 27 с на план; всего $12.02 |
| Composio: Golden Eval, 47 сценариев работы с инструментами в нескольких приложениях | Fable 5 в Claude Code; Sol в Codex CLI на high | Пройдено 45 из 47 (95.7%); в среднем 223 779 токенов и 79.6 с на задачу | Пройдено 47 из 47 (100%); в среднем 276 957 токенов и 84.4 с на задачу |
| Analytics Vidhya: веб-приложение, анализ данных, презентация для инвесторов | Одинаковые промпты, новые чаты, уровень рассуждений по умолчанию | Сопоставимое качество при примерно вдвое большем времени работы | Сопоставимое качество и более быстрые прогоны; выбор автора для длинной сложной работы, которую передают целиком |
Картина в июле была такой: GPT-5.6 Sol подходил для планирования и программирования при более низкой цене токенов и тратил дополнительное время на проверку собственной работы; Fable 5 подходила для длинных сценариев с инструментами и писала планы, по которым было удобно вести разработку.
Эти результаты относятся к июльским моделям — теперь это предыдущее поколение. С тех пор ценовой разрыв вырос в пользу Sol: Fable 5.2 стоит за токен в 4 раза дороже GPT-6.1 Sol, тогда как Fable 5 стоила вдвое дороже GPT-5.6 Sol за ввод и примерно в 1.7 раза за вывод. Дальше в статье сравнивается актуальная пара. В PoYo GPT-5.6 Sol доступен через Responses API для интеграций, которые уже под него настроены.
Что у моделей общего и чем они отличаются
Общее:
- Около 1M токенов контекста и 128K выходных токенов на запрос.
- Ввод текста и изображений, вывод текста.
- Пять уровней effort, от
lowдоmax. Каждый разработчик калибрует свои уровни по-своему, поэтому сравнивайте результаты, а не названия. - Prompt caching, потоковая передача и структурированный вывод.
Различия:
- Effort по умолчанию. У Fable 5.2 по умолчанию
high, у Sol —medium. В сравнительных тестах задавайте effort явно, чтобы обе модели работали на нужном вам уровне. - Управление мышлением. Fable 5.2 всегда думает адаптивно и принимает
tool_choiceсо значениемautoилиnone. Sol настраивается черезreasoning.effort, а его встроенные инструменты (веб-поиск, поиск по файлам, интерпретатор кода, облачная оболочка, применение патчей, управление компьютером, MCP, поиск инструментов) работают через Responses API от OpenAI. - Дата среза знаний. Июнь 2026 года у Fable 5.2; 30 апреля 2026 года у Sol.
- Хранение данных. В API Anthropic Fable 5.2 работает с хранением данных 30 дней.
Цены: в 4 раза дороже за токен, в 2 раза — на длинных промптах
Официальные тарифы (USD за 1M токенов)
| Статья расходов | Claude Fable 5.2 | GPT-6.1 Sol, ввод ≤272K | GPT-6.1 Sol, ввод >272K |
|---|---|---|---|
| Ввод | $8.00 | $2.00 | $4.00 |
| Вывод | $40.00 | $10.00 | $15.00 |
| Чтение из кэша | $0.20 | $0.10 | $0.20 |
| Запись в кэш | $10 (5 мин) / $16 (1 час) | $2.50 (30 мин) / $5.00 (12 часов) | $5.00 (30 мин) / $10.00 (12 часов) |
Для промптов длиннее 272K входных токенов OpenAI применяет к всему запросу двойной тариф на ввод и кэш и полуторный — на вывод. Anthropic тарифицирует всё окно 1M у Fable 5.2 по стандартным ценам. В PoYo обе модели используют единый тариф во всём окне контекста, поэтому GPT-6.1 Sol стоит $1.60 / $8 при любой длине промпта. Цены на все модели Claude — в нашем обзоре цен Claude API.
Стоимость запроса
В этих примерах предполагается, что обе модели расходуют одинаковое количество токенов; в реальности расход у моделей разный (см. следующий раздел). Плата за запись в кэш не учитывается ни для одной из моделей.
| Сценарий | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Ответ в чате: 20K ввода + 4K вывода | Официально: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Официально: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Задача по программированию: 100K ввода + 10K вывода | Официально: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Официально: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Длинный документ: 500K ввода + 20K вывода | Официально: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Официально: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Сессия агента: 2M чтений из кэша + 300K нового ввода + 150K вывода, каждый запрос меньше 272K | Официально: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Официально: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
На промпте в 500K токенов официальный тариф Sol для длинного контекста сокращает разрыв с 4× примерно до 2.1×. В PoYo тот же запрос на GPT-6.1 Sol стоит $0.96, потому что PoYo тарифицирует Sol по единой ставке без множителя за длинный контекст.
Стоимость выполненной задачи
Цена токенов — лишь половина счёта. Artificial Analysis прогоняет обе модели через одни и те же задачи Intelligence Index и публикует их стоимость:
| Максимальный effort | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Стоимость задачи индекса | $26.54 | $1.27 |
| Время на задачу индекса | 45.3 мин | 23.3 мин |
| Результат в индексе | 65 | 55 |
Разница в стоимости — около 21 раза при разнице в цене токенов в 4 раза: Fable 5.2 вкладывает в каждую задачу гораздо больше рассуждений, и именно отсюда её более высокие результаты, а Sol выполняет задачи, расходуя намного меньше токенов. На реальных нагрузках сравнивайте общий счёт за одну принятую задачу вместе с ценой токенов.
Бенчмарки
Одинаковые условия: Artificial Analysis Intelligence Index
Artificial Analysis оценивает обе модели на одних и тех же задачах в одной и той же среде, поэтому её цифры можно сравнивать напрямую. Intelligence Index v5.0.1, данные на 14 ноября 2026 года:
| Effort | Результат Fable 5.2 | Результат GPT-6.1 Sol | Время на задачу у Fable 5.2 | Время на задачу у Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 мин | 2.0 мин |
medium | 56 | 46 | 7.7 мин | 4.6 мин |
high | 62 | 50 | 16.2 мин | 7.9 мин |
xhigh | 62 | 52 | 27.9 мин | 10.7 мин |
max | 65 | 55 | 45.3 мин | 23.3 мин |
Как читать таблицу:
- Fable 5.2 набирает больше на каждом уровне — на 10–19 баллов, что подходит для задач, где важнее всего качество ответа.
- Fable 5.2 на
lowпочти догоняет Sol наmax(54 против 55) за четверть времени. - Sol показывает свои результаты при низкой стоимости: $1.27 за задачу индекса на максимальном effort — это подходит для больших объёмов и работы с ограниченным бюджетом.
- Fable генерирует токены быстрее: около 94–102 выходных токенов в секунду против 47–49 у Sol.
- Artificial Analysis помечает прогоны Fable 5.2 как «Default Fallback»: это значит, что во время тестирования был включён резервный механизм Anthropic на случай отказов.
Результаты Anthropic к запуску
В таблице Anthropic к запуску Fable 5.2 модель сравнивается с GPT-6 Astra — верхним уровнем OpenAI. Каждая модель работала на максимальном доступном уровне effort, если не указано иное:
| Бенчмарк | Что измеряет | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Агентное программирование | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Разработка ПО | 69.9% | 65.5% |
| AutomationBench | Бизнес-процессы | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Агентные научные задачи | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Управление компьютером | 89.3% | 79.5% |
| Remote Labor Index | Реальные оплачиваемые заказы | 41.3% (high) | 20.8% |
| Humanity's Last Exam (с инструментами) | Сложные рассуждения | 74.2% | 57.2% |
| Chartography (без инструментов) | Анализ графиков | 73.4% | 71.0% |

Результат в FrontierCode 2.0 относительно стоимости задачи на каждом уровне effort. График из материалов Anthropic к запуску Claude Fable 5.2.
Результаты OpenAI к запуску
OpenAI выпустила GPT-6.1 Sol 29 сентября 2026 года, за шесть недель до Fable 5.2, и сравнивала его со своими моделями GPT-6. OpenAI позиционирует его для сложного программирования, управления компьютером и профессиональной работы: по возможностям он приближается к GPT-6 Astra при цене токенов в пять раз ниже ($2 / $10 против $10 / $50). Оценки OpenAI к запуску охватывают разработку ПО, понимание документов, автоматизацию бизнес-процессов и управление компьютером.
Каждый разработчик запускает бенчмарки в своей среде и на своей версии теста, поэтому сравнивайте результаты в пределах таблицы одного разработчика, а для прямого сравнения используйте приведённый выше индекс Artificial Analysis.
Какую модель выбрать?
| Ваша нагрузка | С чего начать | Почему |
|---|---|---|
| Высоконагруженный чат, извлечение данных, маршрутизация | GPT-6.1 Sol на medium (или модель поменьше) | Справляется с короткими задачами за четверть цены токенов Fable |
| Повседневное программирование и агентные циклы при ограниченном бюджете | GPT-6.1 Sol | Создан для программирования и агентной работы, $2 / $10 официально и $1.60 / $8 в PoYo |
| Самые сложные рассуждения, исследования, долгие автономные прогоны | Fable 5.2 | 65 против 55 в Intelligence Index; опережает GPT-6 Astra по всей таблице Anthropic |
| Сложные задачи, где ожидание обходится дорого | Fable 5.2 на low или medium | Результаты близки к максимуму Sol за четверть времени |
| Управление компьютером, графики, насыщенные визуальные документы | Fable 5.2 | 89.3% в OSWorld 2.1 и 73.4% в Chartography в таблице Anthropic |
| Промпты, регулярно превышающие 272K токенов | GPT-6.1 Sol в PoYo ради стоимости, Fable 5.2 ради глубины | В PoYo у обеих моделей единый тариф во всём окне: $1.60 / $8 у Sol, $6.40 / $32 у Fable |
| Решения на встроенных инструментах OpenAI (оболочка, веб-поиск, MCP) | GPT-6.1 Sol | Эти инструменты работают нативно через Responses API |
| Нужно качество Claude по более низкой цене | Claude Opus 5.5 | $4 / $20; см. Claude Fable 5.2 и Opus 5.5 |
Долгие автономные прогоны — сильная сторона Fable 5.2: её агенты создали этот прототип операционной системы, запущенный на ноутбуке. Видео из материалов Anthropic к запуску Claude Fable 5.2.
Практичная схема маршрутизации: отправляйте рутинный трафик в GPT-6.1 Sol на medium, отмечайте, каким типам задач нужны более глубокие рассуждения, и перенаправляйте их в Fable 5.2 на medium. Через неделю сравните стоимость одной принятой задачи, а не цены токенов. Сравнение Sol с Claude среднего ценового уровня — в статье GPT-6.1 Sol и Claude Opus 5.5.
Обе модели в PoYo
В PoYo легко работать с обеими моделями:
- Один API-ключ для Fable 5.2, GPT-6.1 Sol и всех остальных моделей для чата, изображений, видео и аудио.
- Оплата по факту использования: кредиты списываются за токены, без подписки.
- Оба формата API: Anthropic Messages, а также OpenAI Chat Completions и Responses.
- Единый тариф для каждой модели во всём окне контекста, на 20% ниже официального тарифа для короткого контекста:
| Статья расходов (за 1M токенов) | Claude Fable 5.2 в PoYo | GPT-6.1 Sol в PoYo |
|---|---|---|
| Ввод | $6.40 | $1.60 |
| Вывод | $32.00 | $8.00 |
| Чтение из кэша | $0.16 | $0.08 |
| Запись в кэш | $8.00 (5 мин) / $12.80 (1 час) | $2.00 |
Fable 5.2 в формате Anthropic Messages:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Проверь этот diff на ошибки конкурентного доступа: ..."}]
  }'
GPT-6.1 Sol через Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Проверь этот diff на ошибки конкурентного доступа: ..."
  }'
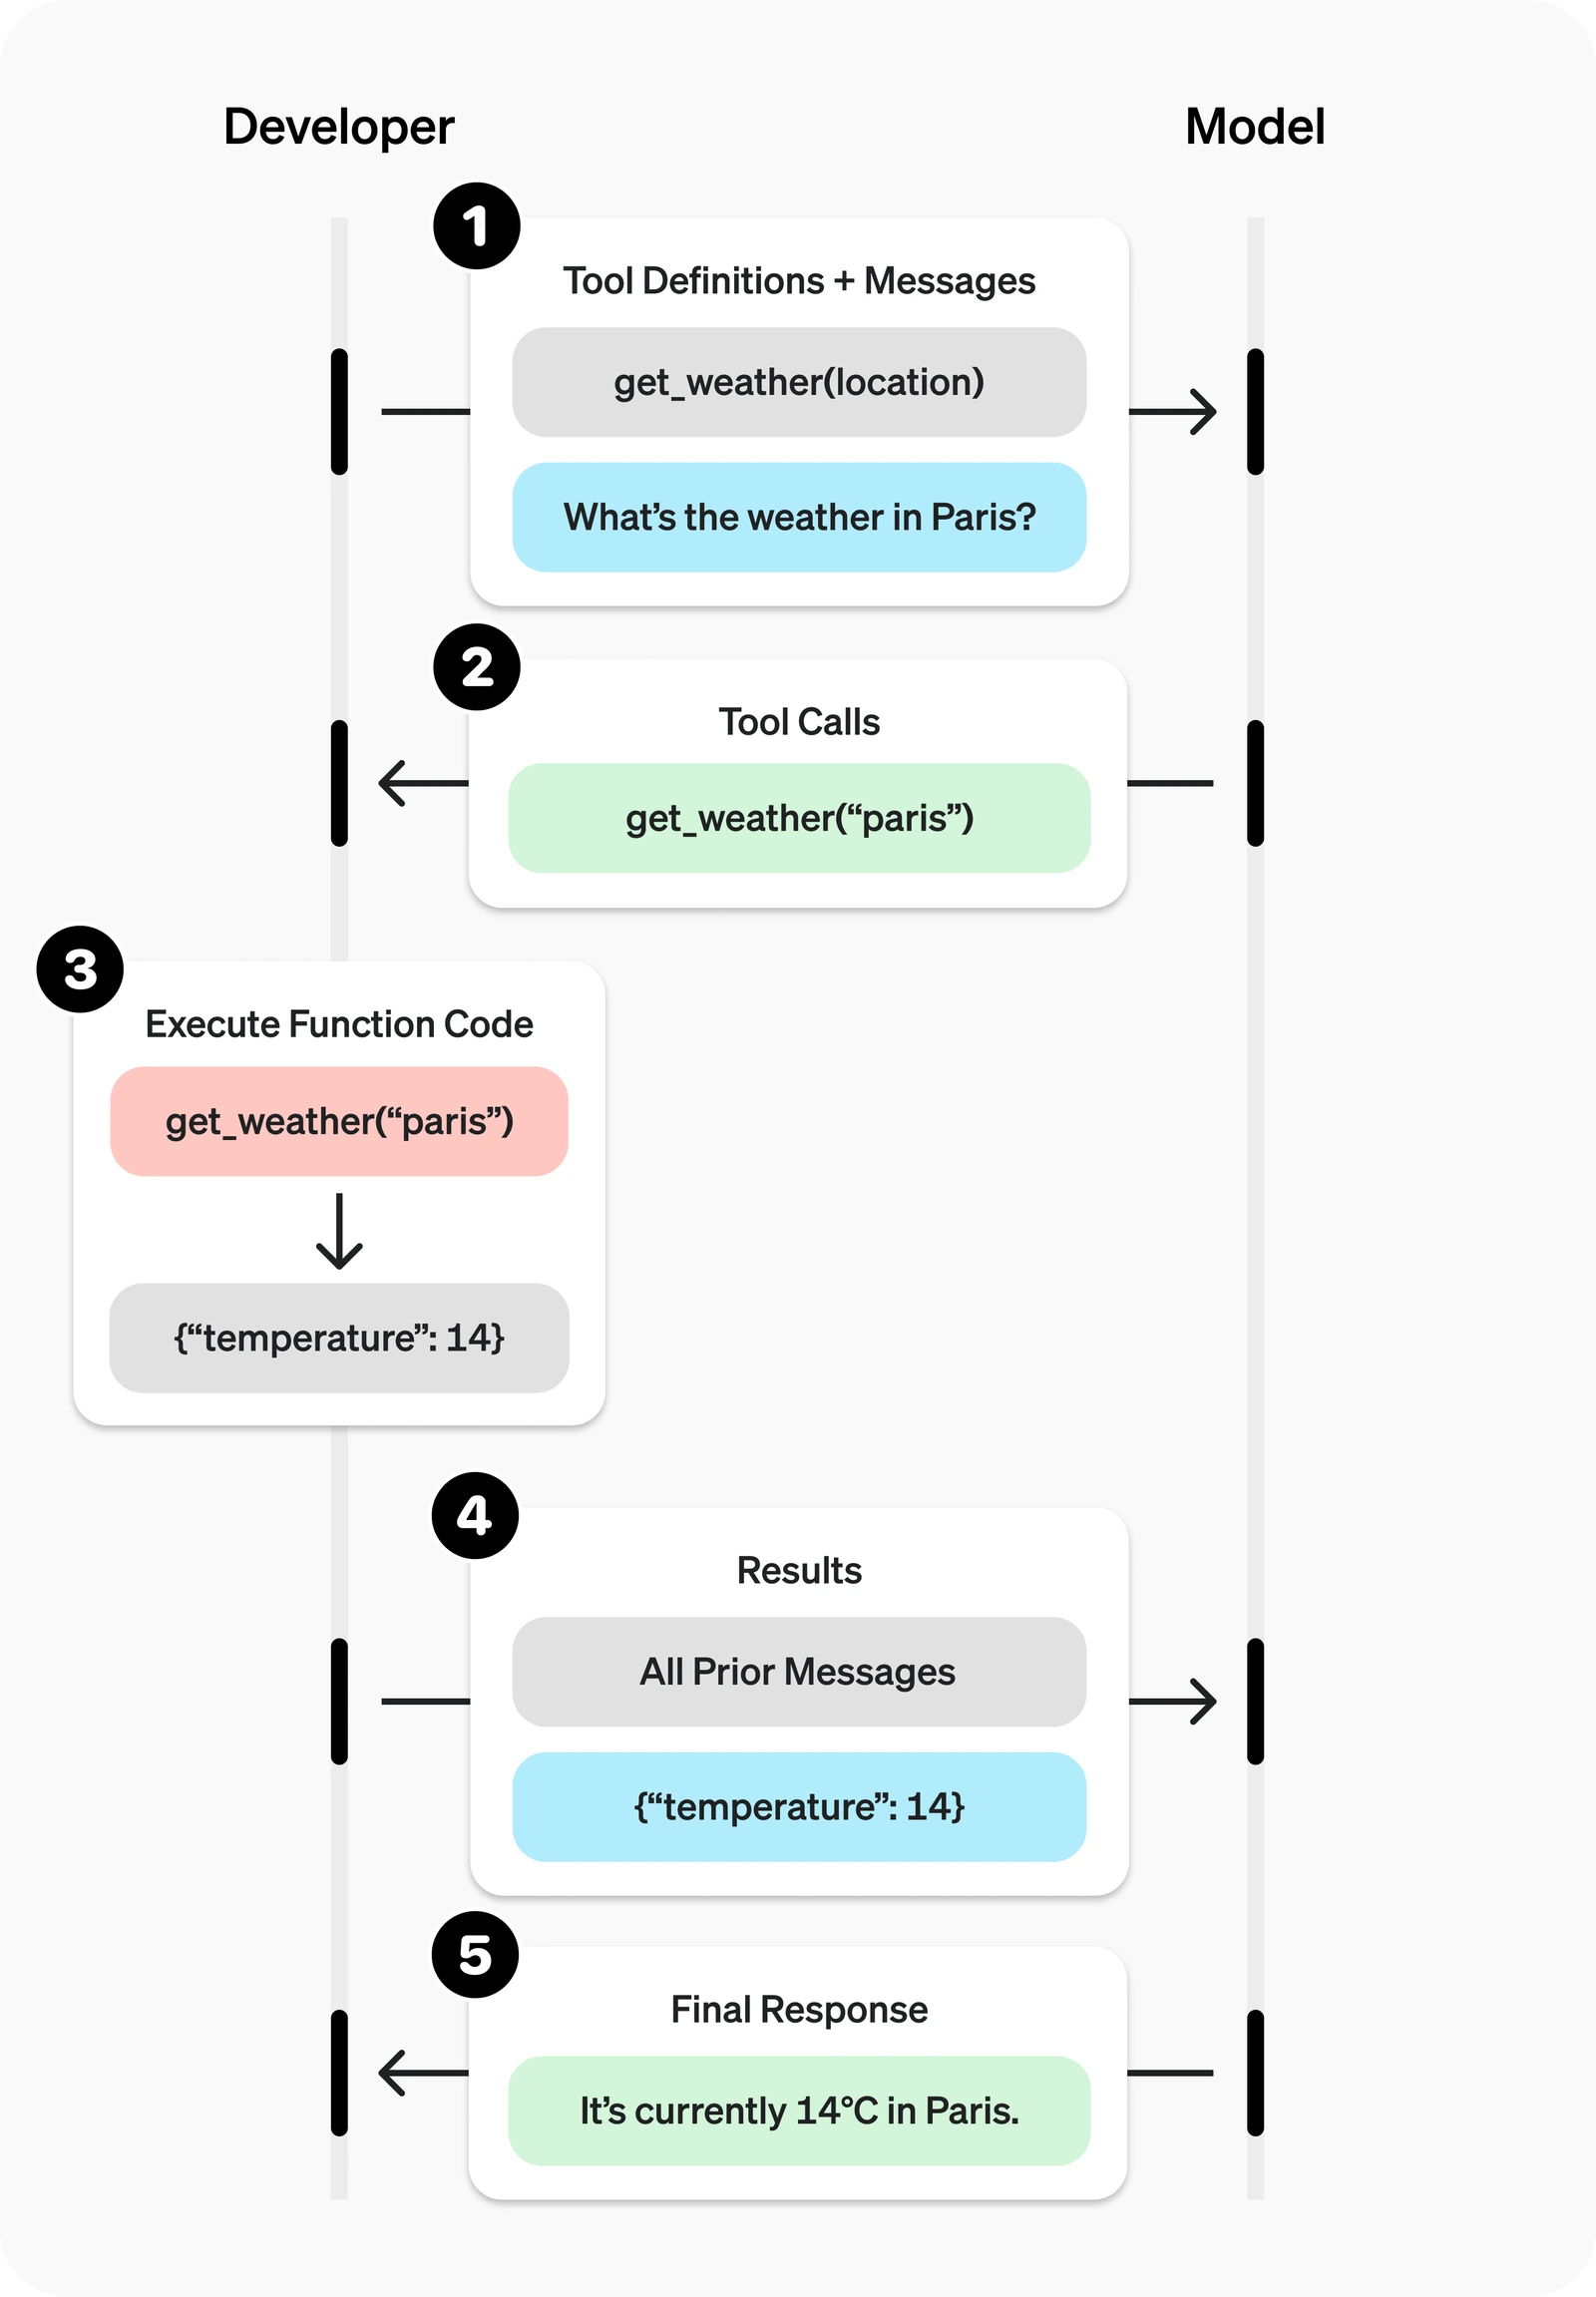
Цикл вызова функций, который GPT-6.1 Sol использует при работе с инструментами. Схема из официальной документации OpenAI.
Чтобы провести A/B-тест обеих моделей в одном коде, отправляйте claude-fable-5-2 и gpt-6.1-sol на /v1/chat/completions, меняя только поле model. Настройка SDK, effort и кэша для Fable описана в нашем руководстве по Claude Fable 5.2 API; лимиты и инструменты Sol — в обзоре возможностей GPT-6.1 Sol.
Страницы моделей: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Часто задаваемые вопросы
Fable 5 лучше, чем GPT-5.6 Sol?
Каждая модель подходила для своих задач. В тестах июля 2026 года Fable 5 прошла все 47 сценариев работы с инструментами в нескольких приложениях от Composio (GPT-5.6 Sol прошёл 45), а GPT-5.6 Sol набрал лучший результат во всех трёх задачах Kilo на планирование систем при более низкой цене токенов. В нынешнем поколении Fable 5.2 набирает 65 баллов, а GPT-6.1 Sol — 55 в Artificial Analysis Intelligence Index, причём Sol обходится в малую долю стоимости задачи.
Будет ли GPT Astra лучше, чем Fable?
GPT-6 Astra уже доступна по цене $10 / $50 за миллион токенов. В таблице Anthropic к запуску Fable 5.2 эта модель набирает больше GPT-6 Astra во всех бенчмарках, где тестировались обе, например 74.6% против 68.1% в Terminal-Bench-Science 0.1 и 89.3% против 79.5% в OSWorld 2.1. Это собственные прогоны Anthropic, поэтому перед решением проверьте обе модели на своих задачах.
GPT-5.6 Luna лучше?
Luna — самый компактный и доступный уровень GPT-5.6, созданный для быстрой работы с большими объёмами, а Sol подходит для более сложных задач. Выбирайте Luna ради пропускной способности и стоимости, Sol — ради глубины. В нынешнем поколении прайсовая цена GPT-6 Luna — $0.10 / $0.50 за миллион токенов.
Стоит ли использовать GPT-5.6 Sol?
GPT-5.6 Sol — предыдущее поколение. Для новых проектов актуальная модель Sol от OpenAI — GPT-6.1 Sol: $2 / $10 за миллион токенов при коротком контексте или $1.60 / $8 в PoYo во всём окне контекста. GPT-5.6 Sol по-прежнему хорошо подходит для интеграций, которые уже под него настроены.
Claude Fable 5.2 лучше, чем GPT-6.1 Sol?
Если нужны максимальные возможности, выбирайте Fable 5.2: в Artificial Analysis Intelligence Index она набирает на 10–19 баллов больше на каждом уровне effort. Если важна стоимость, выбирайте GPT-6.1 Sol: за токен он стоит вчетверо дешевле, а на максимальном effort одна задача индекса обходится примерно в двадцать раз дешевле.
Что дешевле: Fable 5.2 или GPT-6.1 Sol?
GPT-6.1 Sol. Официальные цены — $2 / $10 за миллион входных/выходных токенов против $8 / $40 у Fable 5.2. Если во вводе больше 272K токенов, OpenAI повышает цену всего запроса Sol до $4 / $15, а Fable остаётся по $8 / $40. В PoYo Sol стоит $1.60 / $8 при любой длине промпта.
Какая модель лучше для программирования?
Разработчики публикуют результаты по программированию на разных бенчмарках. По данным Anthropic, Fable 5.2 набирает 49.1% в FrontierCode 2.0 и опережает GPT-6 Astra, а OpenAI создала GPT-6.1 Sol для сложного программирования при цене токенов в пять раз ниже, чем у Astra. Разумный вариант по умолчанию — Sol для рутинного программирования в больших объёмах и Fable 5.2 для крупных долгих изменений. Прогоните обе модели на выборке своих задач.
У обеих моделей окно контекста 1M?
Да, примерно. У Fable 5.2 окно на 1M токенов. У GPT-6.1 Sol окно на 1 050 000 токенов, из которых до 922 000 — входные. Обе модели выдают до 128K выходных токенов на запрос.