
Principais pontos
- O Fable 5.2 é indicado para o trabalho mais difícil; o GPT-6.1 Sol, para o trabalho de grande volume. No Artificial Analysis Intelligence Index, com esforço máximo, o Fable 5.2 marca 65 e o GPT-6.1 Sol marca 55, e o Sol conclui cada tarefa do índice por uma fração do custo.
- Preços oficiais por token: US$ 8 / US$ 40 por milhão de tokens de entrada/saída para o Fable 5.2 e US$ 2 / US$ 10 para o Sol em contexto curto, uma diferença de 4×.
- Uma tarifa única na PoYo. A OpenAI eleva a solicitação inteira do Sol para US$ 4 / US$ 15 acima de 272K tokens de entrada. Na PoYo, o GPT-6.1 Sol custa US$ 1,60 / US$ 8 em toda a janela de contexto, e o Fable 5.2 custa US$ 6,40 / US$ 32 em toda a janela de 1M.
- O Fable 5.2 dedica mais raciocínio a cada tarefa. A Artificial Analysis mediu US$ 26,54 por tarefa do índice para o Fable 5.2 com esforço máximo e US$ 1,27 para o Sol.
- O Fable 5.2 chega rápido a pontuações fortes. Com esforço
low, ele marca 54, perto dos 55 do Sol emmax, e conclui uma tarefa do índice em 5,8 minutos, contra 23,3. - Procurando “GPT-5.6 Sol vs Fable 5”? Esse foi o confronto de julho de 2026. As duas linhas evoluíram desde então; a seção abaixo trata do par antigo separadamente.
Claude Fable 5.2 vs. GPT-6.1 Sol em resumo
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Desenvolvedor | Anthropic | OpenAI |
| ID do modelo na API | claude-fable-5-2 | gpt-6.1-sol |
| Lançamento | 9 de novembro de 2026 | 29 de setembro de 2026 |
| Posicionamento | Categoria mais alta da Anthropic, acima do Opus | Categoria Sol da OpenAI, entre o GPT-6 Astra e o GPT-6 Luna |
| Janela de contexto | 1M tokens | 1.050.000 tokens (entrada máxima de 922.000) |
| Saída máxima | 128K tokens | 128K tokens |
| Entrada → saída | Texto e imagens → texto | Texto e imagens → texto |
| Controle de raciocínio | output_config.effort | reasoning.effort |
| Níveis de esforço | De low a max, padrão high | De low a max, padrão medium |
| Data de corte do conhecimento | junho de 2026 | 30 de abril de 2026 |
| Entrada / saída oficial (por 1M) | $8 / $40 | $2 / $10 (entrada ≤272K) $4 / $15 (entrada >272K) |
| Leitura do cache oficial (por 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| Entrada / saída na PoYo (por 1M) | $6.40 / $32 | $1.60 / $8 |
| Endpoints da PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs. Fable 5: quais versões você está comparando?
A maioria das páginas bem posicionadas para “GPT-5.6 Sol vs Fable 5” foi escrita em julho de 2026, quando esses dois eram os modelos mais novos. Desde então, cada linha lançou versões mais recentes:
| Modelo | Desenvolvedor | Lançamento | Entrada / saída oficial no lançamento (por 1M, contexto curto) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9 de junho de 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9 de julho de 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1º de setembro de 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22 de setembro de 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29 de setembro de 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9 de novembro de 2026 | $8 / $40 |
GPT-5.6 Sol vs. Claude Fable 5: o confronto de julho de 2026
No lançamento, o GPT-5.6 Sol custava metade do Fable 5 na entrada e 40% menos na saída (US$ 5 / US$ 30 vs. US$ 10 / US$ 50, com entrada em cache a US$ 0,50 vs. US$ 1). Os testes independentes daquele mês dividiram o veredito:
| Teste | Configuração | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: três planos de design de sistemas | Kilo Code CLI, os dois em raciocínio Max, avaliados por uma rubrica escrita com antecedência | Maior pontuação nas três tarefas, depois de revisar e reescrever cada plano por conta própria; 52 min 53 s por plano em média; $13.57 no total | Planos que os testadores acharam mais fáceis de pôr em prática; 15 min 27 s por plano em média; $12.02 no total |
| Composio: Golden Eval, 47 fluxos de ferramentas com vários apps | Fable 5 no Claude Code; Sol no Codex CLI em high | 45 de 47 aprovados (95.7%); 223.779 tokens e 79.6 s por tarefa em média | 47 de 47 aprovados (100%); 276.957 tokens e 84.4 s por tarefa em média |
| Analytics Vidhya: app web, análise de dados, apresentação para investidores | Mesmos prompts, chats novos, raciocínio padrão | Qualidade comparável, com cerca do dobro do tempo de execução | Qualidade comparável e execuções mais rápidas; a escolha do autor para trabalhos longos e complexos entregues de uma só vez |
O padrão em julho: o GPT-5.6 Sol se saía bem em planejamento e programação, com preço por token menor, e dedicava tempo extra a conferir o próprio trabalho; o Fable 5 se saía bem em fluxos longos com ferramentas e escrevia planos fáceis de pôr em prática.
Esses resultados descrevem os modelos de julho, que agora são a geração anterior. Desde então, a diferença de preço aumentou a favor do Sol: o Fable 5.2 custa 4× o GPT-6.1 Sol por token, enquanto o Fable 5 custava 2× o GPT-5.6 Sol na entrada e cerca de 1,7× na saída. O restante deste artigo compara a dupla atual. Na PoYo, o GPT-5.6 Sol está disponível pela Responses API para integrações já ajustadas a ele.
O que os dois modelos têm em comum e onde diferem
Em comum:
- Cerca de 1M tokens de contexto e 128K tokens de saída por solicitação.
- Entrada de texto e imagem, saída de texto.
- Cinco níveis de esforço, de
lowamax. Cada fornecedor calibra os próprios níveis, então compare resultados, e não rótulos. - Prompt caching, streaming e saídas estruturadas.
Diferenças:
- Esforço padrão. O Fable 5.2 usa
highpor padrão; o Sol usamedium. Defina o esforço explicitamente em testes lado a lado para que os dois rodem no nível que você pretende. - Controles de pensamento. O Fable 5.2 sempre pensa de forma adaptativa e aceita
tool_choicecomautoounone. O Sol é configurado porreasoning.effort, e as ferramentas hospedadas dele (busca na web, busca em arquivos, interpretador de código, shell hospedado, aplicação de patches, uso do computador, MCP, busca de ferramentas) rodam pela Responses API da OpenAI. - Data de corte do conhecimento. Junho de 2026 para o Fable 5.2; 30 de abril de 2026 para o Sol.
- Retenção de dados. O Fable 5.2 roda com retenção de dados por 30 dias na API da Anthropic.
Preços: 4× por token, 2× em prompts longos
Tarifas oficiais (USD por 1M tokens)
| Cobrança | Claude Fable 5.2 | GPT-6.1 Sol, entrada ≤272K | GPT-6.1 Sol, entrada >272K |
|---|---|---|---|
| Entrada | $8.00 | $2.00 | $4.00 |
| Saída | $40.00 | $10.00 | $15.00 |
| Leitura do cache | $0.20 | $0.10 | $0.20 |
| Gravação no cache | $10 (5 min) / $16 (1 hora) | $2.50 (30 min) / $5.00 (12 horas) | $5.00 (30 min) / $10.00 (12 horas) |
A OpenAI cobra os prompts com mais de 272K tokens de entrada a 2× as tarifas de entrada e de cache e a 1,5× a tarifa de saída, na solicitação inteira. A Anthropic cobra toda a janela de 1M do Fable 5.2 pelas tarifas padrão. Na PoYo, os dois modelos usam uma única tarifa em toda a janela de contexto, então o GPT-6.1 Sol fica em US$ 1,60 / US$ 8, qualquer que seja o tamanho do prompt. Para os preços de todos os modelos Claude, veja nosso guia de preços da API Claude.
Custo por solicitação
Estes exemplos supõem que os dois modelos usam a mesma quantidade de tokens; o uso real varia de um modelo para outro (veja a próxima seção). As cobranças de gravação no cache ficam de fora nos dois casos.
| Cenário | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Resposta de chat: 20K de entrada + 4K de saída | Oficial: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Oficial: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Tarefa de programação: 100K de entrada + 10K de saída | Oficial: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Oficial: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Documento longo: 500K de entrada + 20K de saída | Oficial: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Oficial: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Sessão de agente: 2M de leituras do cache + 300K de entrada nova + 150K de saída, todas as solicitações abaixo de 272K | Oficial: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Oficial: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
Em um prompt de 500K tokens, a tarifa oficial de contexto longo do Sol reduz a diferença de 4× para cerca de 2,1×. Na PoYo, a mesma solicitação custa US$ 0,96 no GPT-6.1 Sol, porque a PoYo cobra o Sol por uma tarifa única, sem multiplicador de contexto longo.
Custo por tarefa concluída
O preço do token é só metade da conta. A Artificial Analysis roda os dois modelos nas mesmas tarefas do Intelligence Index e publica o custo:
| Esforço máximo | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Custo por tarefa do índice | $26.54 | $1.27 |
| Tempo por tarefa do índice | 45.3 min | 23.3 min |
| Pontuação no índice | 65 | 55 |
A diferença de custo é de cerca de 21×, contra uma diferença de preço de 4×: o Fable 5.2 dedica muito mais raciocínio a cada tarefa, e é daí que vêm as pontuações mais altas, enquanto o Sol conclui as tarefas com bem menos tokens. Em cargas de trabalho reais, compare a conta total por tarefa aceita junto com a tarifa por token.
Benchmarks
Mesma configuração: Artificial Analysis Intelligence Index
A Artificial Analysis avalia os dois modelos com as mesmas tarefas e o mesmo ambiente de testes, então os números podem ser comparados diretamente. Intelligence Index v5.0.1, consultado em 14 de novembro de 2026:
| Esforço | Pontuação do Fable 5.2 | Pontuação do GPT-6.1 Sol | Tempo por tarefa do Fable 5.2 | Tempo por tarefa do Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 min | 2.0 min |
medium | 56 | 46 | 7.7 min | 4.6 min |
high | 62 | 50 | 16.2 min | 7.9 min |
xhigh | 62 | 52 | 27.9 min | 10.7 min |
max | 65 | 55 | 45.3 min | 23.3 min |
Como ler a tabela:
- O Fable 5.2 pontua mais em todos os níveis, de 10 a 19 pontos, o que o torna indicado para trabalhos em que a qualidade da resposta é o que mais importa.
- O Fable 5.2 em
lowpontua perto do Sol emmax(54 vs. 55), em um quarto do tempo. - O Sol entrega as suas pontuações a baixo custo: US$ 1,27 por tarefa do índice com esforço máximo, o que o torna indicado para trabalho de grande volume e sensível a orçamento.
- O Fable gera tokens mais rápido: cerca de 94–102 tokens de saída por segundo, contra 47–49 do Sol.
- A Artificial Analysis identifica as execuções do Fable 5.2 como “Default Fallback”, o que significa que o fallback de recusa da Anthropic estava ativado durante os testes.
Resultados de lançamento da Anthropic
A tabela do Fable 5.2 da Anthropic o compara com o GPT-6 Astra, a categoria mais alta da OpenAI. Cada modelo rodou no maior nível de esforço disponível, salvo indicação em contrário:
| Benchmark | O que mede | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Programação agêntica | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Engenharia de software | 69.9% | 65.5% |
| AutomationBench | Fluxos de trabalho empresariais | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Ciência agêntica | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Uso do computador | 89.3% | 79.5% |
| Remote Labor Index | Tarefas pagas reais | 41.3% (high) | 20.8% |
| Humanity's Last Exam (com ferramentas) | Raciocínio difícil | 74.2% | 57.2% |
| Chartography (sem ferramentas) | Raciocínio sobre gráficos | 73.4% | 71.0% |

Pontuação no FrontierCode 2.0 em relação ao custo por tarefa em cada nível de esforço. Gráfico dos materiais de lançamento do Claude Fable 5.2 da Anthropic.
Resultados de lançamento da OpenAI
A OpenAI lançou o GPT-6.1 Sol em 29 de setembro de 2026, seis semanas antes do Fable 5.2, e o comparou com os próprios modelos GPT-6. A OpenAI o posiciona para programação complexa, uso do computador e trabalho profissional, com capacidade próxima à do GPT-6 Astra por um quinto do preço por token do Astra (US$ 2 / US$ 10 contra US$ 10 / US$ 50). As avaliações de lançamento cobrem engenharia de software, compreensão de documentos, automação de negócios e uso do computador.
Cada fornecedor roda os benchmarks no próprio ambiente e na própria versão de teste, então compare as pontuações dentro da tabela de um mesmo fornecedor e use o índice da Artificial Analysis acima para uma comparação direta.
Qual escolher?
| Sua carga de trabalho | Comece com | Por quê |
|---|---|---|
| Chat em grande volume, extração, roteamento | GPT-6.1 Sol em medium (ou um modelo menor) | Resolve tarefas curtas por um quarto do preço por token do Fable |
| Programação do dia a dia e loops de agente com orçamento limitado | GPT-6.1 Sol | Feito para programação e trabalho de agentes, a $2 / $10 no preço oficial e $1.60 / $8 na PoYo |
| Raciocínio mais difícil, pesquisa, execuções autônomas longas | Fable 5.2 | 65 vs. 55 no Intelligence Index; lidera o GPT-6 Astra em toda a tabela da Anthropic |
| Problemas difíceis em que esperar sai caro | Fable 5.2 em low ou medium | Pontua perto do máximo do Sol em um quarto do tempo |
| Uso do computador, gráficos, documentos visuais densos | Fable 5.2 | 89.3% no OSWorld 2.1 e 73.4% no Chartography na tabela da Anthropic |
| Prompts que costumam passar de 272K tokens | GPT-6.1 Sol na PoYo pelo custo, Fable 5.2 pela profundidade | Na PoYo, os dois mantêm uma única tarifa em toda a janela: $1.60 / $8 para o Sol, $6.40 / $32 para o Fable |
| Integrações com as ferramentas hospedadas da OpenAI (shell, busca na web, MCP) | GPT-6.1 Sol | Essas ferramentas rodam de forma nativa pela Responses API |
| Qualidade Claude por um preço menor | Claude Opus 5.5 | $4 / $20; veja Claude Fable 5.2 vs. Opus 5.5 |
Execuções autônomas longas combinam com o Fable 5.2: os agentes dele construíram este protótipo de sistema operacional, mostrado rodando em um notebook. Vídeo dos materiais de lançamento do Claude Fable 5.2 da Anthropic.
Uma configuração de roteamento prática: envie o tráfego rotineiro para o GPT-6.1 Sol em medium, anote quais tipos de tarefa se beneficiam de um raciocínio mais profundo e direcione esses tipos para o Fable 5.2 em medium. Depois de uma semana, compare o custo por tarefa aceita, em vez dos preços de token. Para a opção Claude de preço intermediário contra o Sol, veja GPT-6.1 Sol vs. Claude Opus 5.5.
Use os dois na PoYo
A PoYo facilita rodar os dois:
- Uma chave de API para o Fable 5.2, o GPT-6.1 Sol e todos os outros modelos de chat, imagem, vídeo e áudio.
- Pagamento conforme o uso, cobrado por token em créditos, sem assinatura.
- Os dois formatos de API: Anthropic Messages e OpenAI Chat Completions e Responses.
- Uma tarifa por modelo em toda a janela de contexto, 20% abaixo de cada tarifa oficial de contexto curto:
| Cobrança (por 1M tokens) | Claude Fable 5.2 na PoYo | GPT-6.1 Sol na PoYo |
|---|---|---|
| Entrada | $6.40 | $1.60 |
| Saída | $32.00 | $8.00 |
| Leitura do cache | $0.16 | $0.08 |
| Gravação no cache | $8.00 (5 min) / $12.80 (1 hora) | $2.00 |
O Fable 5.2 pelo formato Anthropic Messages:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Revise este diff em busca de bugs de concorrência: ..."}]
  }'
O GPT-6.1 Sol pela Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Revise este diff em busca de bugs de concorrência: ..."
  }'
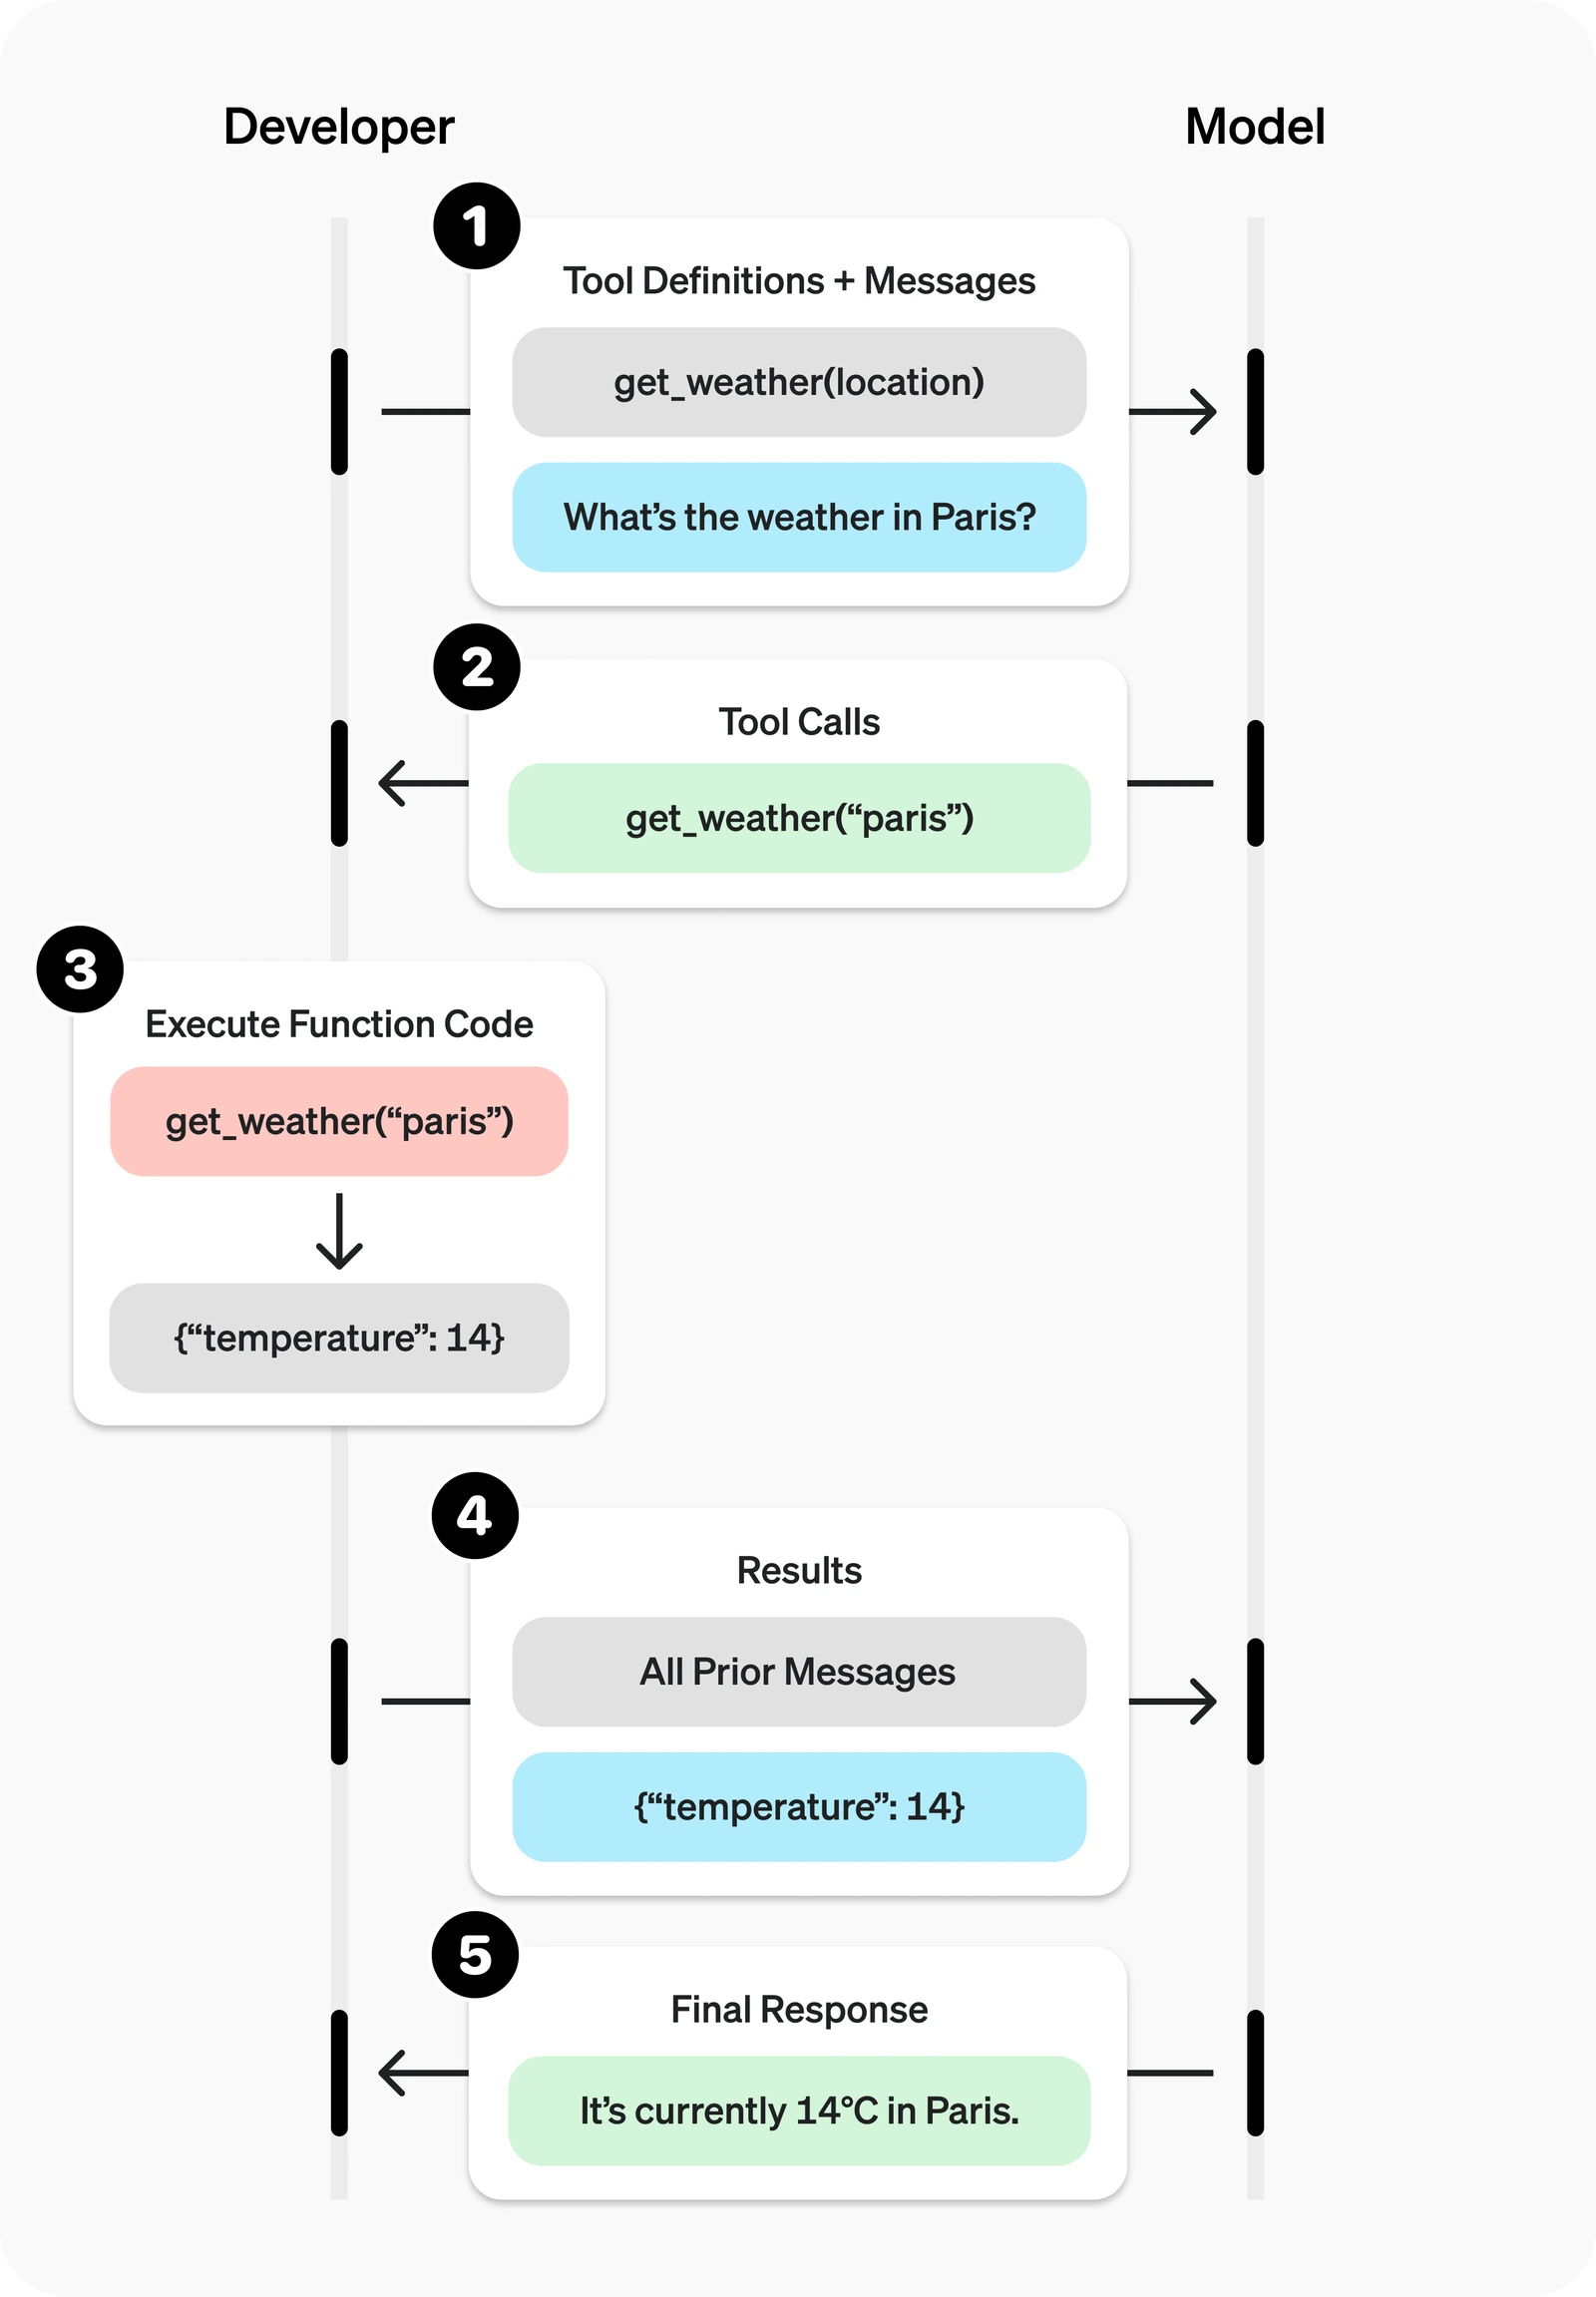
O loop de chamada de funções que o GPT-6.1 Sol usa no trabalho com ferramentas. Diagrama da documentação oficial da OpenAI.
Para fazer um teste A/B dos dois no mesmo caminho de código, envie claude-fable-5-2 e gpt-6.1-sol para /v1/chat/completions e mude só o campo model. Para configuração do SDK, esforço e cache no Fable, veja nosso guia da API do Claude Fable 5.2; para os limites e as ferramentas do Sol, veja o guia de recursos do GPT-6.1 Sol.
Páginas dos modelos: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Perguntas frequentes
O Fable 5 é melhor que o GPT-5.6 Sol?
Cada um se saía melhor em um tipo de trabalho. Nos testes de julho de 2026, o Fable 5 passou nos 47 fluxos de ferramentas com vários apps da Composio (o GPT-5.6 Sol passou em 45), enquanto o GPT-5.6 Sol teve a maior pontuação nas três tarefas de planejamento de design de sistemas da Kilo, com preço por token menor. Na geração atual, o Fable 5.2 marca 65 e o GPT-6.1 Sol marca 55 no Artificial Analysis Intelligence Index, com o Sol custando uma fração por tarefa.
O GPT Astra vai ser melhor que o Fable?
O GPT-6 Astra já está disponível, a US$ 10 / US$ 50 por milhão de tokens. Na tabela de lançamento do Fable 5.2 da Anthropic, o Fable 5.2 pontua mais que o GPT-6 Astra em todos os benchmarks em que os dois foram testados, por exemplo 74,6% vs. 68,1% no Terminal-Bench-Science 0.1 e 89,3% vs. 79,5% no OSWorld 2.1. São execuções da própria Anthropic; teste os dois nas suas tarefas antes de decidir.
O GPT-5.6 Luna é melhor?
O Luna é a categoria menor e mais acessível do GPT-5.6, feita para trabalho rápido e de grande volume, enquanto o Sol é indicado para tarefas mais difíceis. Escolha o Luna pela vazão e pelo custo, e o Sol pela profundidade. Na geração atual, o preço de tabela do GPT-6 Luna é US$ 0,10 / US$ 0,50 por milhão de tokens.
O GPT-5.6 Sol vale a pena?
O GPT-5.6 Sol é da geração anterior. Para projetos novos, o GPT-6.1 Sol é o modelo Sol atual da OpenAI, a US$ 2 / US$ 10 por milhão de tokens em contexto curto, ou US$ 1,60 / US$ 8 na PoYo em toda a janela de contexto. O GPT-5.6 Sol continua sendo uma boa opção para integrações já ajustadas a ele.
O Claude Fable 5.2 é melhor que o GPT-6.1 Sol?
Para capacidade máxima, a escolha é o Fable 5.2: ele pontua de 10 a 19 pontos a mais em todos os níveis de esforço no Artificial Analysis Intelligence Index. Pelo custo, a escolha é o GPT-6.1 Sol: ele custa um quarto por token e, com esforço máximo, cerca de um vigésimo por tarefa do índice.
Qual é mais barato, o Fable 5.2 ou o GPT-6.1 Sol?
O GPT-6.1 Sol. Os preços oficiais são US$ 2 / US$ 10 por milhão de tokens de entrada/saída, contra US$ 8 / US$ 40 do Fable 5.2. Acima de 272K tokens de entrada, a OpenAI eleva o Sol para US$ 4 / US$ 15 na solicitação inteira, enquanto o Fable continua a US$ 8 / US$ 40. Na PoYo, o Sol fica em US$ 1,60 / US$ 8 em qualquer tamanho de prompt.
Qual é melhor para programação?
Os dois fornecedores divulgam resultados de programação em benchmarks diferentes. A Anthropic informa 49,1% para o Fable 5.2 no FrontierCode 2.0, à frente do GPT-6 Astra, e a OpenAI criou o GPT-6.1 Sol para programação complexa por um quinto do preço por token do Astra. Um bom padrão é o Sol para programação rotineira em volume e o Fable 5.2 para mudanças grandes e de longa duração. Rode os dois em uma amostra dos seus próprios tickets.
Os dois modelos têm janela de contexto de 1M?
Sim, aproximadamente. O Fable 5.2 tem uma janela de 1M tokens. O GPT-6.1 Sol tem uma janela de 1.050.000 tokens, com até 922.000 tokens de entrada. Os dois geram até 128K tokens de saída por solicitação.