
Öne çıkanlar
- Fable 5.2 en zor işlere, GPT-6.1 Sol yüksek hacimli işlere uygun. Artificial Analysis Intelligence Index’te en yüksek eforda Fable 5.2 65, GPT-6.1 Sol 55 puan alıyor; Sol ise her endeks görevini maliyetin küçük bir kısmıyla tamamlıyor.
- Resmî token fiyatları: Fable 5.2 için milyon girdi/çıktı tokenı başına $8 / $40, kısa bağlamda Sol için $2 / $10; yani 4 kat fark.
- PoYo’da tek ve sabit ücret. OpenAI, 272K girdi tokenının üzerindeki isteklerin tamamını $4 / $15’ten ücretlendiriyor. PoYo’da GPT-6.1 Sol, bağlam penceresinin tamamında $1.60 / $8; Fable 5.2 ise 1M penceresinin tamamında $6.40 / $32.
- Fable 5.2 her göreve daha fazla akıl yürütme ayırıyor. Artificial Analysis, en yüksek eforda endeks görevi başına Fable 5.2 için $26.54, Sol için $1.27 ölçtü.
- Fable 5.2 güçlü skorlara hızla ulaşıyor.
loweforda 54 alıyor; bu, Sol’unmaxdüzeyindeki 55 puanına yakın. Bir endeks görevini de 23.3 dakikaya karşı 5.8 dakikada bitiriyor. - “GPT-5.6 Sol vs Fable 5” mi arıyorsunuz? O, Temmuz 2026’daki karşılaşmaydı. İki seri de o zamandan beri ilerledi; eski ikiliyi aşağıdaki bölümde ayrıca ele alıyoruz.
Bir bakışta Claude Fable 5.2 ve GPT-6.1 Sol
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Geliştirici | Anthropic | OpenAI |
| API model kimliği | claude-fable-5-2 | gpt-6.1-sol |
| Çıkış tarihi | 9 Kasım 2026 | 29 Eylül 2026 |
| Konum | Anthropic’in en üst kademesi, Opus’un üstünde | OpenAI’ın Sol kademesi, GPT-6 Astra ile GPT-6 Luna arasında |
| Bağlam penceresi | 1M token | 1.050.000 token (en fazla 922.000 girdi) |
| Maksimum çıktı | 128K token | 128K token |
| Girdi → çıktı | Metin ve görüntüler → metin | Metin ve görüntüler → metin |
| Akıl yürütme kontrolü | output_config.effort | reasoning.effort |
| Efor düzeyleri | low ile max arası, varsayılan high | low ile max arası, varsayılan medium |
| Bilgi kesim tarihi | Haziran 2026 | 30 Nisan 2026 |
| Resmî girdi / çıktı (1M başına) | $8 / $40 | $2 / $10 (girdi ≤272K) $4 / $15 (girdi >272K) |
| Resmî önbellek okuma (1M başına) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| PoYo girdi / çıktı (1M başına) | $6.40 / $32 | $1.60 / $8 |
| PoYo uç noktaları | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol ve Fable 5: Hangi sürümleri karşılaştırıyorsunuz?
“GPT-5.6 Sol vs Fable 5” aramasında üst sıralarda çıkan sayfaların çoğu, bu iki modelin en yeni modeller olduğu Temmuz 2026’da yazıldı. O zamandan beri iki seri de yeni sürümler çıkardı:
| Model | Geliştirici | Çıkış tarihi | Lansmandaki resmî girdi / çıktı (1M başına, kısa bağlam) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9 Haziran 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9 Temmuz 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1 Eylül 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22 Eylül 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29 Eylül 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9 Kasım 2026 | $8 / $40 |
GPT-5.6 Sol ve Claude Fable 5: Temmuz 2026 karşılaşması
Lansmanda GPT-5.6 Sol, girdide Fable 5’in yarı fiyatına, çıktıda ise %40 daha ucuza sunuluyordu ($10 / $50’ye karşı $5 / $30; önbellekteki girdi $1’a karşı $0.50). O ayın bağımsız testleri farklı sonuçlara ulaştı:
| Test | Kurulum | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: üç sistem tasarımı planı | Kilo Code CLI, ikisi de Max akıl yürütmede, önceden yazılmış bir rubrikle puanlama | Her planı kendisi gözden geçirip düzelttikten sonra üç görevin hepsinde en yüksek skor; plan başına ortalama 52 dk 53 sn; toplam $13.57 | Test yapanların üzerine inşa etmeyi en kolay bulduğu planlar; plan başına ortalama 15 dk 27 sn; toplam $12.02 |
| Composio: Golden Eval, 47 çok uygulamalı araç iş akışı | Fable 5 Claude Code’da; Sol, high düzeyinde Codex CLI’da | 47’den 45’i geçti (95.7%); görev başına ortalama 223.779 token ve 79.6 sn | 47’den 47’si geçti (100%); görev başına ortalama 276.957 token ve 84.4 sn |
| Analytics Vidhya: web uygulaması, veri analizi, yatırımcı sunumu | Aynı istemler, yeni sohbetler, varsayılan akıl yürütme | Benzer kalite, yaklaşık iki kat çalışma süresi | Benzer kalite ve daha hızlı çalıştırmalar; yazarın tek seferde devredilen uzun ve karmaşık işler için tercihi |
Temmuz’daki örüntü şuydu: GPT-5.6 Sol daha düşük token fiyatıyla planlama ve kodlamaya uygundu ve kendi işini kontrol etmek için ek zaman harcıyordu; Fable 5 ise uzun araç iş akışlarına uygundu ve üzerine inşa etmesi kolay planlar yazıyordu.
Bu sonuçlar, artık bir önceki nesil olan Temmuz modellerini anlatıyor. O zamandan beri fiyat farkı Sol lehine açıldı: Fable 5 girdide GPT-5.6 Sol’un 2 katı, çıktıda yaklaşık 1.7 katıyken Fable 5.2 token başına GPT-6.1 Sol’un 4 katı tutuyor. Makalenin geri kalanında güncel ikiliyi karşılaştırıyoruz. PoYo’da GPT-5.6 Sol, bu modele göre ayarlanmış mevcut entegrasyonlar için Responses API üzerinden kullanılabilir.
İki modelin ortak yönleri ve farkları
Ortak yönler:
- İstek başına yaklaşık 1M token bağlam ve 128K çıktı tokenı.
- Metin ve görüntü girdisi, metin çıktısı.
lowilemaxarasında beş efor düzeyi. Her sağlayıcı kendi düzeylerini kalibre ettiğinden etiketleri değil sonuçları karşılaştırın.- İstem önbelleğe alma, akış ve yapılandırılmış çıktılar.
Farklar:
- Varsayılan efor. Fable 5.2’nin varsayılanı
high, Sol’unkimedium. Yan yana testlerde ikisinin de istediğiniz düzeyde çalışması için eforu açıkça belirtin. - Düşünme kontrolleri. Fable 5.2 her zaman uyarlamalı olarak düşünür ve
autoveyanonedeğerlitool_choicekabul eder. Sol,reasoning.effortile yapılandırılır; barındırılan araçları (web araması, dosya araması, kod yorumlayıcı, barındırılan shell, yama uygulama, bilgisayar kullanımı, MCP, araç araması) OpenAI’ın Responses API’si üzerinden çalışır. - Bilgi kesim tarihi. Fable 5.2 için Haziran 2026; Sol için 30 Nisan 2026.
- Veri saklama. Fable 5.2, Anthropic API’sinde 30 günlük veri saklamayla çalışır.
Fiyatlandırma: Token başına 4 kat, uzun istemlerde 2 kat
Resmî ücretler (1M token başına USD)
| Ücret kalemi | Claude Fable 5.2 | GPT-6.1 Sol, girdi ≤272K | GPT-6.1 Sol, girdi >272K |
|---|---|---|---|
| Girdi | $8.00 | $2.00 | $4.00 |
| Çıktı | $40.00 | $10.00 | $15.00 |
| Önbellek okuma | $0.20 | $0.10 | $0.20 |
| Önbellek yazma | $10 (5 dk) / $16 (1 saat) | $2.50 (30 dk) / $5.00 (12 saat) | $5.00 (30 dk) / $10.00 (12 saat) |
OpenAI, 272K’dan fazla girdi tokenı içeren istemlerde isteğin tamamı için girdi ve önbellek ücretlerini 2 katına, çıktı ücretini 1.5 katına çıkarıyor. Anthropic ise Fable 5.2’nin 1M penceresinin tamamını standart ücretlerle faturalandırıyor. PoYo’da iki model de bağlam penceresinin tamamında tek bir ücret kullanır; bu yüzden GPT-6.1 Sol, istem ne kadar uzun olursa olsun $1.60 / $8’de kalır. Tüm Claude modellerinin fiyatları için Claude API fiyatlandırma rehberimize göz atın.
İstek başına maliyet
Bu örnekler, iki modelin aynı sayıda token kullandığını varsayıyor; gerçek kullanım modele göre değişir (bir sonraki bölüme bakın). Önbellek yazma ücretleri iki model için de hesaba katılmamıştır.
| Senaryo | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Sohbet yanıtı: 20K girdi + 4K çıktı | Resmî: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Resmî: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Kodlama görevi: 100K girdi + 10K çıktı | Resmî: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Resmî: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Uzun belge: 500K girdi + 20K çıktı | Resmî: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Resmî: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Ajan oturumu: 2M önbellek okuma + 300K yeni girdi + 150K çıktı, her istek 272K’nın altında | Resmî: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Resmî: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
500K tokenlık bir istemde Sol’un resmî uzun bağlam ücreti, farkı 4 kattan yaklaşık 2.1 kata indiriyor. PoYo’da ise aynı istek GPT-6.1 Sol’da $0.96 tutuyor; çünkü PoYo, Sol’u uzun bağlam çarpanı olmadan tek bir ücretle faturalandırıyor.
Tamamlanan görev başına maliyet
Token fiyatları faturanın yalnızca yarısı. Artificial Analysis, iki modeli de aynı Intelligence Index görevlerinden geçiriyor ve maliyeti yayımlıyor:
| En yüksek efor | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Endeks görevi başına maliyet | $26.54 | $1.27 |
| Endeks görevi başına süre | 45.3 dk | 23.3 dk |
| Endeks skoru | 65 | 55 |
Fiyat farkı 4 katken maliyet farkı yaklaşık 21 kat: Fable 5.2 her göreve çok daha fazla akıl yürütme ayırıyor ve yüksek skorları da buradan geliyor; Sol ise görevleri çok daha az tokenla bitiriyor. Gerçek iş yüklerinde token ücretinin yanında, kabul edilen görev başına toplam faturayı da karşılaştırın.
Kıyaslamalar
Aynı kurulum: Artificial Analysis Intelligence Index
Artificial Analysis iki modeli de aynı görevler ve aynı test düzeneğiyle değerlendiriyor; bu yüzden sayıları doğrudan karşılaştırılabilir. 14 Kasım 2026’da okunan Intelligence Index v5.0.1:
| Efor | Fable 5.2 skoru | GPT-6.1 Sol skoru | Fable 5.2 görev başına süre | Sol görev başına süre |
|---|---|---|---|---|
low | 54 | 35 | 5.8 dk | 2.0 dk |
medium | 56 | 46 | 7.7 dk | 4.6 dk |
high | 62 | 50 | 16.2 dk | 7.9 dk |
xhigh | 62 | 52 | 27.9 dk | 10.7 dk |
max | 65 | 55 | 45.3 dk | 23.3 dk |
Tablo nasıl okunmalı:
- Fable 5.2 her düzeyde 10 ila 19 puan daha yüksek skor alıyor; bu, yanıt kalitesinin en önemli olduğu işlere uygun.
lowdüzeyindeki Fable 5.2,maxdüzeyindeki Sol’a yakın skor alıyor (54’e karşı 55) ve bunu dörtte bir sürede yapıyor.- Sol skorlarını düşük maliyetle sunuyor: en yüksek eforda endeks görevi başına $1.27; bu da yüksek hacimli ve bütçeye duyarlı işlere uygun.
- Fable tokenları daha hızlı üretiyor: saniyede yaklaşık 94–102 çıktı tokenı; Sol’da ise 47–49.
- Artificial Analysis, Fable 5.2 çalıştırmalarını “Default Fallback” olarak etiketliyor; yani test sırasında Anthropic’in ret yedeği (refusal fallback) etkindi.
Anthropic’in lansman sonuçları
Anthropic’in Fable 5.2 tablosu, modeli OpenAI’ın en üst kademesi GPT-6 Astra ile karşılaştırıyor. Aksi belirtilmedikçe her model kendi en yüksek efor düzeyinde çalıştırıldı:
| Kıyaslama | Neyi ölçer | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Ajan tabanlı kodlama | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Yazılım mühendisliği | 69.9% | 65.5% |
| AutomationBench | İş akışları | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Ajan tabanlı bilim | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Bilgisayar kullanımı | 89.3% | 79.5% |
| Remote Labor Index | Gerçek ücretli işler | 41.3% (high) | 20.8% |
| Humanity's Last Exam (araçlarla) | Zor akıl yürütme | 74.2% | 57.2% |
| Chartography (araçsız) | Grafik akıl yürütme | 73.4% | 71.0% |

Her efor düzeyinde görev başına maliyete göre FrontierCode 2.0 skoru. Grafik, Anthropic’in Claude Fable 5.2 lansman materyallerinden.
OpenAI’ın lansman sonuçları
OpenAI, GPT-6.1 Sol’u Fable 5.2’den altı hafta önce, 29 Eylül 2026’da piyasaya sürdü ve kendi GPT-6 modelleriyle karşılaştırdı. OpenAI, modeli karmaşık kodlama, bilgisayar kullanımı ve profesyonel işler için konumluyor; yeteneği GPT-6 Astra’ya yaklaşırken token fiyatı Astra’nın beşte biri ($10 / $50’ye karşı $2 / $10). Lansman değerlendirmeleri yazılım mühendisliği, belge anlama, iş otomasyonu ve bilgisayar kullanımını kapsıyor.
Her sağlayıcı kıyaslamaları kendi test düzeneğinde ve kendi test sürümüyle çalıştırıyor; bu yüzden skorları tek bir sağlayıcının tablosu içinde karşılaştırın, doğrudan karşılaştırma için ise yukarıdaki Artificial Analysis endeksini kullanın.
Hangisini seçmelisiniz?
| İş yükünüz | Başlangıç modeli | Neden |
|---|---|---|
| Yüksek hacimli sohbet, veri çıkarma, yönlendirme | medium düzeyinde GPT-6.1 Sol (veya daha küçük bir model) | Kısa görevleri Fable’ın token fiyatının dörtte birine halleder |
| Bütçeli günlük kodlama ve ajan döngüleri | GPT-6.1 Sol | Kodlama ve ajan işleri için tasarlandı; resmî fiyatı $2 / $10, PoYo’da $1.60 / $8 |
| En zor akıl yürütme, araştırma, uzun otonom çalıştırmalar | Fable 5.2 | Intelligence Index’te 65’e karşı 55; Anthropic’in tablosunda GPT-6 Astra’nın her alanda önünde |
| Beklemenin pahalıya patladığı zor problemler | low veya medium düzeyinde Fable 5.2 | Dörtte bir sürede Sol’un en yüksek skoruna yakın sonuç |
| Bilgisayar kullanımı, grafikler, yoğun görsel belgeler | Fable 5.2 | Anthropic’in tablosunda OSWorld 2.1’de 89.3%, Chartography’de 73.4% |
| Düzenli olarak 272K tokenı aşan istemler | Maliyet için PoYo’da GPT-6.1 Sol, derinlik için Fable 5.2 | PoYo’da ikisi de pencerenin tamamında tek ücret uygular: Sol için $1.60 / $8, Fable için $6.40 / $32 |
| OpenAI’ın barındırılan araçları (shell, web araması, MCP) üzerine kurulu altyapı | GPT-6.1 Sol | Bu araçlar Responses API üzerinden yerel olarak çalışır |
| Daha düşük fiyata Claude kalitesi | Claude Opus 5.5 | $4 / $20; Claude Fable 5.2 ve Opus 5.5 yazımıza bakın |
Uzun otonom çalıştırmalar Fable 5.2’ye uygun: bir dizüstü bilgisayarda çalışırken görülen bu prototip işletim sistemini onun ajanları geliştirdi. Video, Anthropic’in Claude Fable 5.2 lansman materyallerinden.
Pratik bir yönlendirme kurgusu: Rutin trafiği medium düzeyindeki GPT-6.1 Sol’a gönderin, hangi görev türlerinin daha derin akıl yürütmeden fayda gördüğünü not edin ve bunları medium düzeyindeki Fable 5.2’ye yönlendirin. Bir hafta sonra token fiyatları yerine kabul edilen görev başına maliyeti karşılaştırın. Sol’a karşı orta fiyatlı Claude seçeneği için GPT-6.1 Sol ve Claude Opus 5.5 yazımıza bakın.
İkisini de PoYo’da kullanın
PoYo, iki modeli birlikte çalıştırmayı kolaylaştırır:
- Fable 5.2, GPT-6.1 Sol ve diğer tüm sohbet, görüntü, video ve ses modelleri için tek API anahtarı.
- Kullandıkça öde: token başına kredi üzerinden faturalandırma, abonelik gerekmez.
- İki API formatı: Anthropic Messages ile OpenAI Chat Completions ve Responses.
- Her model için bağlam penceresinin tamamında tek ücret; her modelin resmî kısa bağlam ücretinin %20 altında:
| Ücret kalemi (1M token başına) | PoYo’da Claude Fable 5.2 | PoYo’da GPT-6.1 Sol |
|---|---|---|
| Girdi | $6.40 | $1.60 |
| Çıktı | $32.00 | $8.00 |
| Önbellek okuma | $0.16 | $0.08 |
| Önbellek yazma | $8.00 (5 dk) / $12.80 (1 saat) | $2.00 |
Anthropic Messages formatıyla Fable 5.2:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Bu diff’i eşzamanlılık hataları açısından incele: ..."}]
  }'
Responses API ile GPT-6.1 Sol:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Bu diff’i eşzamanlılık hataları açısından incele: ..."
  }'
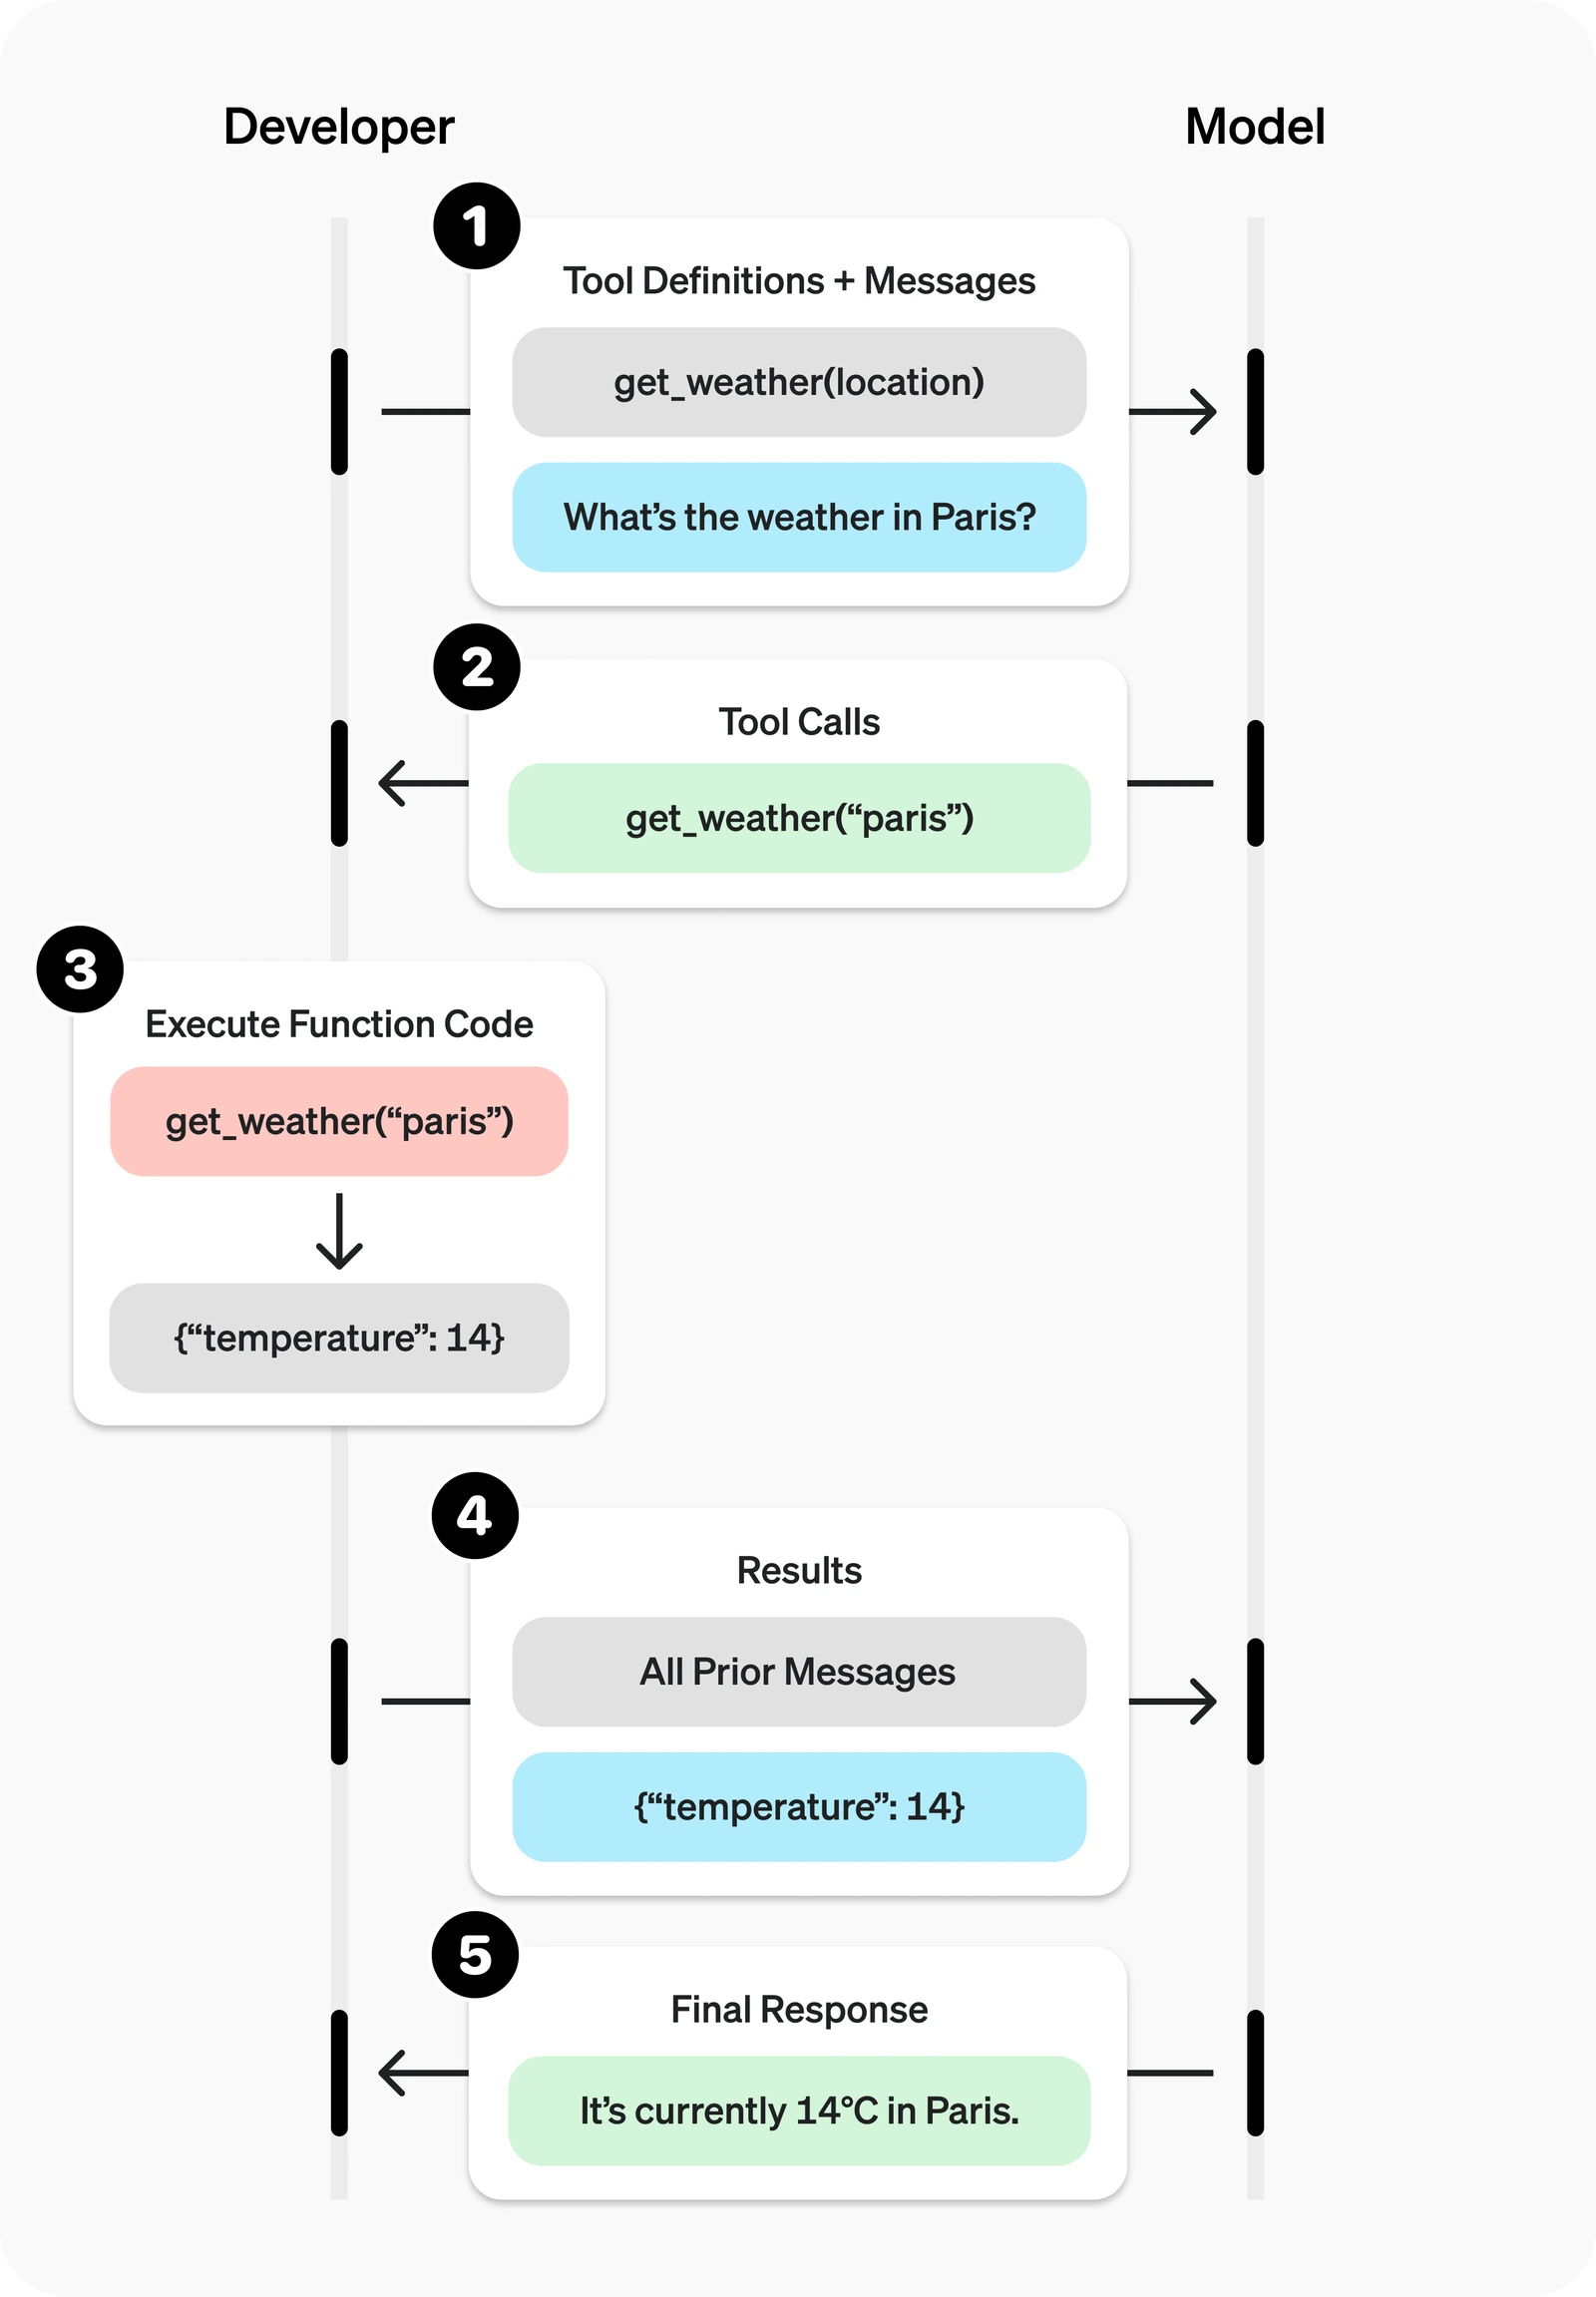
GPT-6.1 Sol’un araç işlerinde kullandığı fonksiyon çağırma döngüsü. Diyagram, OpenAI’ın resmî dokümantasyonundan.
İkisini tek bir kod yolunda A/B testine tabi tutmak için claude-fable-5-2 ve gpt-6.1-sol modellerini /v1/chat/completions adresine gönderin ve yalnızca model alanını değiştirin. Fable’da SDK kurulumu, efor ve önbellek için Claude Fable 5.2 API rehberimize; Sol’un sınırları ve araçları için GPT-6.1 Sol özellikler rehberine bakın.
Model sayfaları: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Sıkça sorulan sorular
Fable 5, GPT-5.6 Sol’dan daha mı iyi?
Her biri farklı işlere uygundu. Temmuz 2026 testlerinde Fable 5, Composio’nun 47 çok uygulamalı araç iş akışının tamamını geçti (GPT-5.6 Sol 45’ini geçti); GPT-5.6 Sol ise Kilo’nun üç sistem tasarımı planlama görevinin hepsinde, daha düşük token fiyatıyla en yüksek skoru aldı. Güncel nesilde Artificial Analysis Intelligence Index’te Fable 5.2 65, GPT-6.1 Sol 55 puan alıyor; Sol’un görev başına maliyeti ise bunun küçük bir kısmı.
GPT Astra, Fable’dan daha iyi olacak mı?
GPT-6 Astra zaten milyon token başına $10 / $50 fiyatla kullanılabiliyor. Anthropic’in Fable 5.2 lansman tablosunda Fable 5.2, iki modelin de çalıştırıldığı her kıyaslamada GPT-6 Astra’dan yüksek skor alıyor; örneğin Terminal-Bench-Science 0.1’de %74.6’ya karşı %68.1, OSWorld 2.1’de %89.3’e karşı %79.5. Bunlar Anthropic’in kendi çalıştırmaları; karar vermeden önce ikisini de kendi görevlerinizde test edin.
GPT-5.6 Luna daha mı iyi?
Luna, hızlı ve yüksek hacimli işler için tasarlanmış, GPT-5.6’nın en küçük ve en uygun fiyatlı kademesi; Sol ise daha zor görevlere uygun. İşlem hacmi ve maliyet için Luna’yı, derinlik için Sol’u seçin. Güncel nesilde GPT-6 Luna’nın liste fiyatı milyon token başına $0.10 / $0.50.
GPT-5.6 Sol buna değer mi?
GPT-5.6 Sol bir önceki nesil. Yeni projeler için OpenAI’ın güncel Sol modeli GPT-6.1 Sol; kısa bağlamda milyon token başına $2 / $10, PoYo’da ise bağlam penceresinin tamamında $1.60 / $8. GPT-5.6 Sol, bu modele göre ayarlanmış mevcut entegrasyonlar için iyi bir seçenek olmaya devam ediyor.
Claude Fable 5.2, GPT-6.1 Sol’dan daha mı iyi?
En yüksek yetenek için seçim Fable 5.2: Artificial Analysis Intelligence Index’te her efor düzeyinde 10 ila 19 puan daha yüksek skor alıyor. Maliyet için seçim GPT-6.1 Sol: token başına dörtte bir fiyatına, en yüksek eforda ise endeks görevi başına yaklaşık yirmide bir maliyetine geliyor.
Hangisi daha ucuz, Fable 5.2 mi GPT-6.1 Sol mu?
GPT-6.1 Sol. Resmî fiyatlar milyon girdi/çıktı tokenı başına $2 / $10; Fable 5.2’de ise $8 / $40. 272K girdi tokenının üzerinde OpenAI, isteğin tamamı için Sol’u $4 / $15’e çıkarırken Fable $8 / $40’ta kalıyor. PoYo’da Sol, istem uzunluğu ne olursa olsun $1.60 / $8’de kalıyor.
Kodlama için hangisi daha iyi?
İki sağlayıcı kodlama sonuçlarını farklı kıyaslamalarla raporluyor. Anthropic, Fable 5.2’nin FrontierCode 2.0’da %49.1 alarak GPT-6 Astra’nın önünde olduğunu bildiriyor; OpenAI ise GPT-6.1 Sol’u, Astra’nın token fiyatının beşte birine karmaşık kodlama için tasarladı. Mantıklı bir varsayılan: yüksek hacimli rutin kodlama için Sol, büyük ve uzun süren değişiklikler için Fable 5.2. İkisini de kendi iş kayıtlarınızdan bir örneklem üzerinde çalıştırın.
İki modelin de 1M bağlam penceresi var mı?
Evet, kabaca. Fable 5.2’nin 1M tokenlık bir penceresi var. GPT-6.1 Sol’un penceresi 1.050.000 token ve en fazla 922.000 girdi tokenı alıyor. İkisi de istek başına 128K’ya kadar çıktı tokenı yazıyor.