
Những điểm chính
- Fable 5.2 phù hợp với công việc khó nhất; GPT-6.1 Sol phù hợp với công việc khối lượng lớn. Trên Artificial Analysis Intelligence Index, Fable 5.2 đạt 65 điểm và GPT-6.1 Sol đạt 55 điểm ở effort tối đa, trong khi Sol hoàn thành mỗi tác vụ của bộ chỉ số với chi phí chỉ bằng một phần nhỏ.
- Giá token chính thức: $8 / $40 cho mỗi triệu token đầu vào/đầu ra với Fable 5.2 và $2 / $10 với Sol ở ngữ cảnh ngắn, chênh lệch 4 lần.
- Một mức giá đồng nhất trên PoYo. OpenAI nâng giá toàn bộ yêu cầu của Sol lên $4 / $15 khi đầu vào vượt 272K token. Trên PoYo, GPT-6.1 Sol có giá $1.60 / $8 trên toàn bộ cửa sổ ngữ cảnh, còn Fable 5.2 có giá $6.40 / $32 trên toàn bộ cửa sổ 1M.
- Fable 5.2 dồn nhiều suy luận hơn vào mỗi tác vụ. Artificial Analysis đo được $26.54 cho mỗi tác vụ của bộ chỉ số với Fable 5.2 ở effort tối đa và $1.27 với Sol.
- Fable 5.2 nhanh chóng đạt điểm cao. Ở effort
low, model này đạt 54 điểm, sát với 55 điểm của Sol ởmax, và hoàn thành một tác vụ của bộ chỉ số trong 5.8 phút so với 23.3 phút. - Bạn đang tìm "GPT-5.6 Sol vs Fable 5"? Đó là cặp đối đầu tháng 7/2026. Cả hai dòng model đều đã có phiên bản mới; phần bên dưới trình bày riêng về cặp cũ.
Tổng quan Claude Fable 5.2 và GPT-6.1 Sol
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Nhà phát triển | Anthropic | OpenAI |
| ID model trên API | claude-fable-5-2 | gpt-6.1-sol |
| Ngày phát hành | 9/11/2026 | 29/9/2026 |
| Vị trí | Hạng cao nhất của Anthropic, trên Opus | Hạng Sol của OpenAI, giữa GPT-6 Astra và GPT-6 Luna |
| Cửa sổ ngữ cảnh | 1M token | 1.050.000 token (đầu vào tối đa 922.000) |
| Đầu ra tối đa | 128K token | 128K token |
| Đầu vào → đầu ra | Văn bản và hình ảnh → văn bản | Văn bản và hình ảnh → văn bản |
| Điều chỉnh suy luận | output_config.effort | reasoning.effort |
| Các mức effort | low đến max, mặc định high | low đến max, mặc định medium |
| Mốc kiến thức | 6/2026 | 30/4/2026 |
| Đầu vào / đầu ra chính thức (mỗi 1M) | $8 / $40 | $2 / $10 (đầu vào ≤272K) $4 / $15 (đầu vào >272K) |
| Đọc bộ nhớ đệm chính thức (mỗi 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| Đầu vào / đầu ra trên PoYo (mỗi 1M) | $6.40 / $32 | $1.60 / $8 |
| Endpoint trên PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol và Fable 5: bạn đang so sánh những phiên bản nào?
Phần lớn các trang xếp hạng cho cụm "GPT-5.6 Sol vs Fable 5" được viết vào tháng 7/2026, khi hai model này là mới nhất. Từ đó đến nay, mỗi dòng đã ra mắt các phiên bản mới hơn:
| Model | Nhà phát triển | Ngày phát hành | Giá chính thức đầu vào / đầu ra lúc ra mắt (mỗi 1M, ngữ cảnh ngắn) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9/6/2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9/7/2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1/9/2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22/9/2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29/9/2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9/11/2026 | $8 / $40 |
GPT-5.6 Sol và Claude Fable 5: cuộc đối đầu tháng 7/2026
Lúc ra mắt, GPT-5.6 Sol có giá đầu vào chỉ bằng một nửa Fable 5 và giá đầu ra thấp hơn 40% ($5 / $30 so với $10 / $50, với đầu vào từ bộ nhớ đệm $0.50 so với $1). Các bài kiểm thử độc lập trong tháng đó cho kết luận chia đôi:
| Bài kiểm thử | Thiết lập | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: ba bản kế hoạch thiết kế hệ thống | Kilo Code CLI, cả hai ở mức suy luận Max, chấm theo rubric soạn sẵn từ trước | Điểm cao nhất ở cả ba tác vụ, sau khi tự review và chỉnh sửa từng bản kế hoạch; trung bình 52 phút 53 giây mỗi bản; tổng $13.57 | Những bản kế hoạch mà người kiểm thử thấy dễ triển khai nhất; trung bình 15 phút 27 giây mỗi bản; tổng $12.02 |
| Composio: Golden Eval, 47 quy trình công cụ đa ứng dụng | Fable 5 trong Claude Code; Sol trong Codex CLI ở mức high | Đạt 45/47 (95.7%); trung bình 223.779 token và 79.6 giây mỗi tác vụ | Đạt 47/47 (100%); trung bình 276.957 token và 84.4 giây mỗi tác vụ |
| Analytics Vidhya: ứng dụng web, phân tích dữ liệu, bộ slide gọi vốn | Cùng prompt, cuộc trò chuyện mới, mức suy luận mặc định | Chất lượng tương đương, thời gian chạy gấp khoảng hai lần | Chất lượng tương đương và chạy nhanh hơn; lựa chọn của tác giả cho công việc dài, phức tạp được giao trọn trong một lần |
Quy luật của tháng 7: GPT-5.6 Sol phù hợp với lập kế hoạch và lập trình ở giá token thấp hơn, đồng thời dành thêm thời gian tự kiểm tra công việc; Fable 5 phù hợp với các quy trình công cụ dài và viết ra những bản kế hoạch dễ triển khai.
Những kết quả đó mô tả các model tháng 7, nay đã là thế hệ trước. Từ đó, khoảng cách giá đã nới rộng theo hướng có lợi cho Sol: Fable 5.2 đắt gấp 4 lần GPT-6.1 Sol tính theo token, trong khi Fable 5 từng đắt gấp 2 lần GPT-5.6 Sol ở đầu vào và khoảng 1.7 lần ở đầu ra. Phần còn lại của bài viết so sánh cặp model hiện tại. Trên PoYo, GPT-5.6 Sol vẫn có qua Responses API cho các tích hợp đã được tinh chỉnh cho model này.
Hai model có gì giống và khác nhau
Điểm chung:
- Khoảng 1M token ngữ cảnh và 128K token đầu ra cho mỗi yêu cầu.
- Đầu vào văn bản và hình ảnh, đầu ra văn bản.
- Năm mức effort, từ
lowđếnmax. Mỗi nhà cung cấp tự hiệu chỉnh các mức của mình, vì vậy hãy so sánh kết quả thay vì so sánh tên mức. - Prompt caching, streaming và structured output.
Điểm khác biệt:
- Effort mặc định. Fable 5.2 mặc định là
high; Sol mặc định làmedium. Hãy đặt effort tường minh trong các bài kiểm thử song song để cả hai chạy đúng mức bạn mong muốn. - Cách điều chỉnh suy nghĩ. Fable 5.2 luôn suy nghĩ thích ứng và chấp nhận
tool_choicelàautohoặcnone. Sol được cấu hình quareasoning.effort, và các công cụ được lưu trữ sẵn của model này (tìm kiếm web, tìm kiếm tệp, code interpreter, hosted shell, apply patch, sử dụng máy tính, MCP, tìm kiếm công cụ) chạy qua Responses API của OpenAI. - Mốc kiến thức. Tháng 6/2026 với Fable 5.2; 30/4/2026 với Sol.
- Lưu giữ dữ liệu. Fable 5.2 chạy với chế độ lưu giữ dữ liệu 30 ngày trên API của Anthropic.
Giá: gấp 4 lần mỗi token, gấp 2 lần với prompt dài
Giá chính thức (USD cho mỗi 1M token)
| Khoản phí | Claude Fable 5.2 | GPT-6.1 Sol, đầu vào ≤272K | GPT-6.1 Sol, đầu vào >272K |
|---|---|---|---|
| Đầu vào | $8.00 | $2.00 | $4.00 |
| Đầu ra | $40.00 | $10.00 | $15.00 |
| Đọc bộ nhớ đệm | $0.20 | $0.10 | $0.20 |
| Ghi bộ nhớ đệm | $10 (5 phút) / $16 (1 giờ) | $2.50 (30 phút) / $5.00 (12 giờ) | $5.00 (30 phút) / $10.00 (12 giờ) |
Với prompt có hơn 272K token đầu vào, OpenAI tính giá đầu vào và bộ nhớ đệm gấp 2 lần, giá đầu ra gấp 1.5 lần, áp dụng cho toàn bộ yêu cầu. Anthropic tính toàn bộ cửa sổ 1M của Fable 5.2 theo giá tiêu chuẩn. Trên PoYo, cả hai model dùng một mức giá trên toàn bộ cửa sổ ngữ cảnh, nên GPT-6.1 Sol luôn giữ mức $1.60 / $8 dù prompt dài đến đâu. Để xem giá của mọi model Claude, hãy đọc hướng dẫn giá Claude API của chúng tôi.
Chi phí mỗi yêu cầu
Các ví dụ này giả định hai model dùng cùng số token; mức sử dụng thực tế khác nhau tùy model (xem phần tiếp theo). Phép tính ở cả hai bên chưa bao gồm phí ghi bộ nhớ đệm.
| Tình huống | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Trả lời chat: 20K đầu vào + 4K đầu ra | Chính thức: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Chính thức: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Tác vụ lập trình: 100K đầu vào + 10K đầu ra | Chính thức: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Chính thức: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Tài liệu dài: 500K đầu vào + 20K đầu ra | Chính thức: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Chính thức: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Phiên tác tử: 2M token đọc từ bộ nhớ đệm + 300K đầu vào mới + 150K đầu ra, mọi yêu cầu dưới 272K | Chính thức: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Chính thức: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
Với prompt 500K token, giá ngữ cảnh dài chính thức của Sol thu hẹp khoảng cách từ 4 lần xuống còn khoảng 2.1 lần. Trên PoYo, cùng yêu cầu đó chỉ tốn $0.96 với GPT-6.1 Sol, vì PoYo tính giá Sol theo một mức duy nhất, không áp hệ số ngữ cảnh dài.
Chi phí cho mỗi tác vụ hoàn thành
Giá token mới chỉ là một nửa hóa đơn. Artificial Analysis chạy cả hai model trên cùng các tác vụ của Intelligence Index và công bố chi phí:
| Effort tối đa | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Chi phí mỗi tác vụ của bộ chỉ số | $26.54 | $1.27 |
| Thời gian mỗi tác vụ của bộ chỉ số | 45.3 phút | 23.3 phút |
| Điểm bộ chỉ số | 65 | 55 |
Khoảng cách chi phí là khoảng 21 lần, so với khoảng cách giá 4 lần: Fable 5.2 dồn nhiều suy luận hơn hẳn vào mỗi tác vụ, đó cũng là nguồn gốc của điểm số cao hơn, còn Sol hoàn thành tác vụ với ít token hơn nhiều. Với khối lượng công việc thực tế, hãy so sánh tổng hóa đơn cho mỗi tác vụ được chấp nhận song song với giá token.
Benchmark
Cùng một thiết lập: Artificial Analysis Intelligence Index
Artificial Analysis đánh giá cả hai model với cùng tác vụ và cùng bộ khung kiểm thử, nên các con số có thể so sánh trực tiếp. Intelligence Index v5.0.1, số liệu xem ngày 14/11/2026:
| Effort | Điểm Fable 5.2 | Điểm GPT-6.1 Sol | Thời gian mỗi tác vụ của Fable 5.2 | Thời gian mỗi tác vụ của Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 phút | 2.0 phút |
medium | 56 | 46 | 7.7 phút | 4.6 phút |
high | 62 | 50 | 16.2 phút | 7.9 phút |
xhigh | 62 | 52 | 27.9 phút | 10.7 phút |
max | 65 | 55 | 45.3 phút | 23.3 phút |
Cách đọc bảng:
- Fable 5.2 đạt điểm cao hơn ở mọi mức, hơn từ 10 đến 19 điểm, phù hợp với công việc mà chất lượng câu trả lời quan trọng nhất.
- Fable 5.2 ở
lowđạt điểm sát với Sol ởmax(54 so với 55) chỉ trong một phần tư thời gian. - Sol mang lại điểm số với chi phí thấp: $1.27 cho mỗi tác vụ của bộ chỉ số ở effort tối đa, phù hợp với công việc khối lượng lớn và nhạy cảm về ngân sách.
- Fable tạo token nhanh hơn: khoảng 94–102 token đầu ra mỗi giây so với 47–49 của Sol.
- Artificial Analysis gắn nhãn các lượt chạy Fable 5.2 là "Default Fallback", nghĩa là cơ chế dự phòng khi từ chối của Anthropic được bật trong quá trình kiểm thử.
Kết quả ra mắt của Anthropic
Bảng số liệu Fable 5.2 của Anthropic so sánh model này với GPT-6 Astra, hạng cao nhất của OpenAI. Mỗi model chạy ở mức effort cao nhất hiện có, trừ khi có ghi chú:
| Benchmark | Đo lường điều gì | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Lập trình dạng tác tử | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Kỹ thuật phần mềm | 69.9% | 65.5% |
| AutomationBench | Quy trình nghiệp vụ | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Khoa học dạng tác tử | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Sử dụng máy tính | 89.3% | 79.5% |
| Remote Labor Index | Tác vụ trả phí thực tế | 41.3% (high) | 20.8% |
| Humanity's Last Exam (có công cụ) | Suy luận khó | 74.2% | 57.2% |
| Chartography (không công cụ) | Suy luận biểu đồ | 73.4% | 71.0% |

Điểm FrontierCode 2.0 so với chi phí mỗi tác vụ ở từng mức effort. Biểu đồ từ tài liệu ra mắt Claude Fable 5.2 của Anthropic.
Kết quả ra mắt của OpenAI
OpenAI ra mắt GPT-6.1 Sol vào ngày 29/9/2026, sáu tuần trước Fable 5.2, và so sánh model này với các model GPT-6 của chính mình. OpenAI định vị Sol cho lập trình phức tạp, sử dụng máy tính và công việc chuyên môn, với năng lực tiệm cận GPT-6 Astra ở mức giá token chỉ bằng một phần năm Astra ($2 / $10 so với $10 / $50). Các bài đánh giá lúc ra mắt bao gồm kỹ thuật phần mềm, hiểu tài liệu, tự động hóa nghiệp vụ và sử dụng máy tính.
Mỗi nhà cung cấp chạy benchmark trên bộ khung và phiên bản kiểm thử riêng, vì vậy hãy so sánh điểm trong cùng một bảng của một nhà cung cấp, và dùng bộ chỉ số Artificial Analysis ở trên để so sánh trực tiếp.
Bạn nên chọn model nào?
| Khối lượng công việc | Bắt đầu với | Lý do |
|---|---|---|
| Chat, trích xuất, định tuyến với khối lượng lớn | GPT-6.1 Sol ở medium (hoặc một model nhỏ hơn) | Xử lý tác vụ ngắn với giá token chỉ bằng một phần tư Fable |
| Lập trình hằng ngày và vòng lặp tác tử với ngân sách hạn chế | GPT-6.1 Sol | Được xây dựng cho lập trình và công việc tác tử, giá $2 / $10 chính thức và $1.60 / $8 trên PoYo |
| Suy luận khó nhất, nghiên cứu, các lượt chạy tự hành dài | Fable 5.2 | 65 so với 55 trên Intelligence Index; dẫn trước GPT-6 Astra trong toàn bộ bảng của Anthropic |
| Bài toán khó mà thời gian chờ là chi phí lớn | Fable 5.2 ở low hoặc medium | Đạt điểm sát mức tối đa của Sol chỉ trong một phần tư thời gian |
| Sử dụng máy tính, biểu đồ, tài liệu dày đặc hình ảnh | Fable 5.2 | 89.3% trên OSWorld 2.1 và 73.4% trên Chartography trong bảng của Anthropic |
| Prompt thường xuyên vượt 272K token | GPT-6.1 Sol trên PoYo để tối ưu chi phí, Fable 5.2 để có chiều sâu | Trên PoYo, cả hai giữ một mức giá trên toàn bộ cửa sổ: $1.60 / $8 với Sol, $6.40 / $32 với Fable |
| Hệ thống xây trên các công cụ được lưu trữ sẵn của OpenAI (shell, tìm kiếm web, MCP) | GPT-6.1 Sol | Các công cụ đó chạy trực tiếp qua Responses API |
| Cần chất lượng Claude với giá thấp hơn | Claude Opus 5.5 | $4 / $20; xem Claude Fable 5.2 và Opus 5.5 |
Các lượt chạy tự hành dài là thế mạnh của Fable 5.2: các tác tử của model này đã xây dựng hệ điều hành nguyên mẫu đang chạy trên laptop trong video. Video từ tài liệu ra mắt Claude Fable 5.2 của Anthropic.
Một cách định tuyến thực tế: gửi lưu lượng thông thường đến GPT-6.1 Sol ở medium, ghi lại những loại tác vụ được lợi từ suy luận sâu hơn, rồi định tuyến chúng sang Fable 5.2 ở medium. Sau một tuần, hãy so sánh chi phí cho mỗi tác vụ được chấp nhận thay vì so sánh giá token. Để xem lựa chọn Claude tầm giá trung bình khi đặt cạnh Sol, hãy đọc GPT-6.1 Sol và Claude Opus 5.5.
Dùng cả hai trên PoYo
PoYo giúp bạn chạy cả hai model thật đơn giản:
- Một API key cho Fable 5.2, GPT-6.1 Sol và mọi model chat, hình ảnh, video và âm thanh khác.
- Trả theo mức sử dụng, tính phí theo từng token bằng credit, không cần gói đăng ký.
- Cả hai định dạng API: Anthropic Messages, cùng OpenAI Chat Completions và Responses.
- Một mức giá cho mỗi model trên toàn bộ cửa sổ ngữ cảnh, thấp hơn 20% so với giá ngữ cảnh ngắn chính thức của từng model:
| Khoản phí (mỗi 1M token) | Claude Fable 5.2 trên PoYo | GPT-6.1 Sol trên PoYo |
|---|---|---|
| Đầu vào | $6.40 | $1.60 |
| Đầu ra | $32.00 | $8.00 |
| Đọc bộ nhớ đệm | $0.16 | $0.08 |
| Ghi bộ nhớ đệm | $8.00 (5 phút) / $12.80 (1 giờ) | $2.00 |
Gọi Fable 5.2 qua định dạng Anthropic Messages:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Hãy review diff này để tìm lỗi xử lý đồng thời: ..."}]
  }'
Gọi GPT-6.1 Sol qua Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Hãy review diff này để tìm lỗi xử lý đồng thời: ..."
  }'
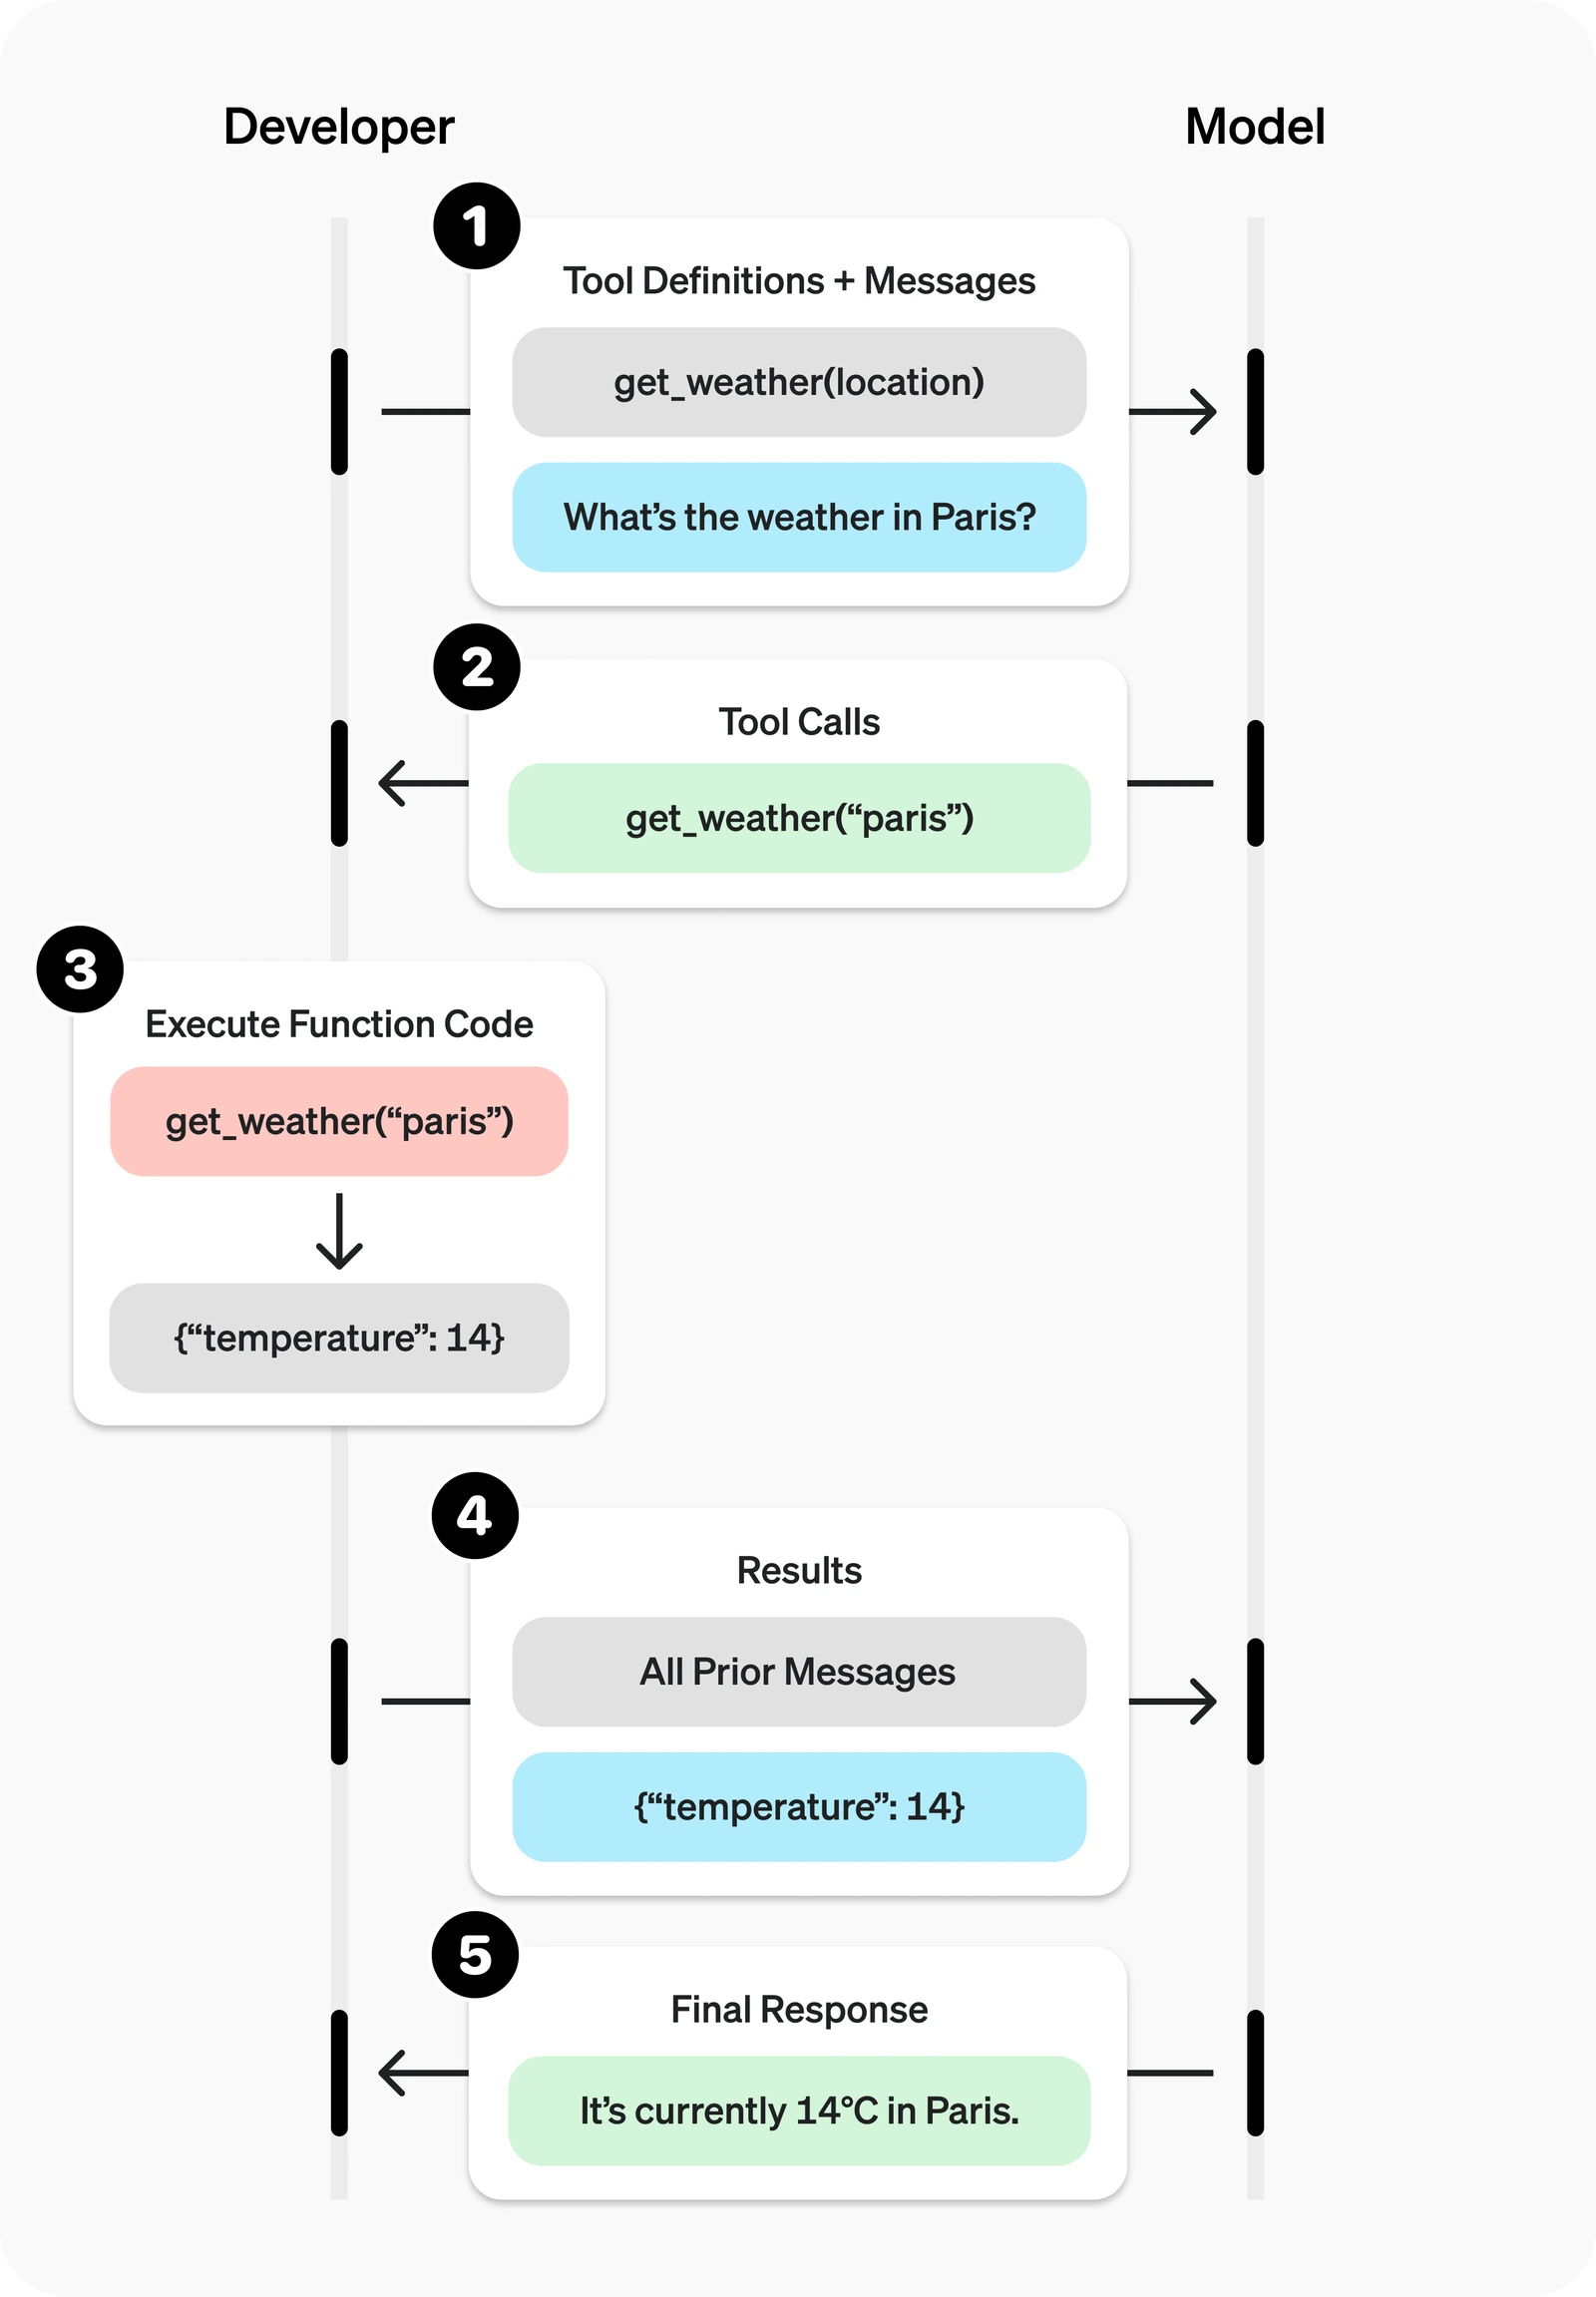
Vòng lặp gọi hàm mà GPT-6.1 Sol dùng khi làm việc với công cụ. Sơ đồ từ tài liệu chính thức của OpenAI.
Để A/B test cả hai trên cùng một luồng code, hãy gửi claude-fable-5-2 và gpt-6.1-sol đến /v1/chat/completions và chỉ thay đổi trường model. Về cách thiết lập SDK, effort và bộ nhớ đệm với Fable, hãy xem hướng dẫn Claude Fable 5.2 API của chúng tôi; về giới hạn và công cụ của Sol, hãy xem hướng dẫn tính năng GPT-6.1 Sol.
Trang model: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Câu hỏi thường gặp
Fable 5 có tốt hơn GPT-5.6 Sol không?
Mỗi model phù hợp với một loại công việc khác nhau. Trong các bài kiểm thử tháng 7/2026, Fable 5 vượt qua cả 47 quy trình công cụ đa ứng dụng của Composio (GPT-5.6 Sol vượt qua 45), trong khi GPT-5.6 Sol đạt điểm cao nhất ở cả ba tác vụ lập kế hoạch thiết kế hệ thống của Kilo với giá token thấp hơn. Ở thế hệ hiện tại, Fable 5.2 đạt 65 điểm và GPT-6.1 Sol đạt 55 điểm trên Artificial Analysis Intelligence Index, với chi phí mỗi tác vụ của Sol chỉ bằng một phần nhỏ.
GPT Astra có mạnh hơn Fable không?
GPT-6 Astra đã có mặt, với giá $10 / $50 cho mỗi triệu token. Trong bảng số liệu ra mắt Fable 5.2 của Anthropic, Fable 5.2 đạt điểm cao hơn GPT-6 Astra ở mọi benchmark mà cả hai cùng được chạy, ví dụ 74.6% so với 68.1% trên Terminal-Bench-Science 0.1 và 89.3% so với 79.5% trên OSWorld 2.1. Đây là các lượt chạy của chính Anthropic; hãy thử cả hai trên tác vụ của bạn trước khi quyết định.
GPT-5.6 Luna có tốt hơn không?
Luna là hạng nhỏ nhất và tiết kiệm nhất của GPT-5.6, được xây dựng cho công việc nhanh, khối lượng lớn, còn Sol phù hợp với tác vụ khó hơn. Hãy chọn Luna khi cần thông lượng và chi phí thấp, chọn Sol khi cần chiều sâu. Ở thế hệ hiện tại, GPT-6 Luna có giá niêm yết $0.10 / $0.50 cho mỗi triệu token.
GPT-5.6 Sol có đáng dùng không?
GPT-5.6 Sol thuộc thế hệ trước. Với dự án mới, GPT-6.1 Sol là model Sol hiện tại của OpenAI, giá $2 / $10 cho mỗi triệu token ở ngữ cảnh ngắn, hoặc $1.60 / $8 trên PoYo trên toàn bộ cửa sổ ngữ cảnh. GPT-5.6 Sol vẫn là lựa chọn phù hợp cho các tích hợp đã được tinh chỉnh cho model này.
Claude Fable 5.2 có tốt hơn GPT-6.1 Sol không?
Nếu cần năng lực tối đa, hãy chọn Fable 5.2: model này đạt điểm cao hơn từ 10 đến 19 điểm ở mọi mức effort trên Artificial Analysis Intelligence Index. Nếu ưu tiên chi phí, hãy chọn GPT-6.1 Sol: giá mỗi token chỉ bằng một phần tư, và ở effort tối đa, chi phí mỗi tác vụ của bộ chỉ số chỉ khoảng một phần hai mươi.
Fable 5.2 hay GPT-6.1 Sol rẻ hơn?
GPT-6.1 Sol. Giá chính thức là $2 / $10 cho mỗi triệu token đầu vào/đầu ra, so với $8 / $40 của Fable 5.2. Khi đầu vào vượt 272K token, OpenAI nâng giá Sol lên $4 / $15 cho toàn bộ yêu cầu, còn Fable giữ nguyên $8 / $40. Trên PoYo, Sol luôn giữ mức $1.60 / $8 với mọi độ dài prompt.
Model nào tốt hơn cho lập trình?
Hai nhà cung cấp công bố kết quả lập trình trên các benchmark khác nhau. Anthropic công bố Fable 5.2 đạt 49.1% trên FrontierCode 2.0, dẫn trước GPT-6 Astra, còn OpenAI xây dựng GPT-6.1 Sol cho lập trình phức tạp với giá token chỉ bằng một phần năm Astra. Một mặc định hợp lý là dùng Sol cho lập trình thông thường ở khối lượng lớn và Fable 5.2 cho các thay đổi lớn, chạy dài. Hãy chạy thử cả hai trên một tập ticket mẫu của chính bạn.
Cả hai model đều có cửa sổ ngữ cảnh 1M phải không?
Đúng, xấp xỉ như vậy. Fable 5.2 có cửa sổ 1M token. GPT-6.1 Sol có cửa sổ 1.050.000 token với tối đa 922.000 token đầu vào. Cả hai viết tối đa 128K token đầu ra cho mỗi yêu cầu.