
核心要点
- Fable 5.2 适合最难的工作,GPT-6.1 Sol 适合大批量的工作。 在 Artificial Analysis 智能指数上,两者都开到 max effort 时,Fable 5.2 得 65 分,GPT-6.1 Sol 得 55 分,而 Sol 完成每个指数任务的成本只是一个零头。
- 官方 Token 价格: 短上下文下,每百万输入/输出 Token,Fable 5.2 是 $8 / $40,Sol 是 $2 / $10,相差 4 倍。
- PoYo 上一价到底。 输入超过 272K Token 时,OpenAI 会把 Sol 整个请求的价格提到 $4 / $15。在 PoYo 上,GPT-6.1 Sol 整个上下文窗口都是 $1.60 / $8,Fable 5.2 整个 1M 窗口都是 $6.40 / $32。
- Fable 5.2 在每个任务上投入更多推理。 Artificial Analysis 测得,max effort 下 Fable 5.2 每个指数任务花费 $26.54,Sol 为 $1.27。
- Fable 5.2 很快就能拿到高分。 开
low时它得 54 分,接近 Sol 开max的 55 分,完成一个指数任务只要 5.8 分钟,Sol 要 23.3 分钟。 - 在搜 "GPT-5.6 Sol vs Fable 5"? 那是 2026 年 7 月的那一对。两条产品线后来都更新了,下文单独有一节讲旧的那一对。
Claude Fable 5.2 vs GPT-6.1 Sol 一览
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| 开发商 | Anthropic | OpenAI |
| API 模型 ID | claude-fable-5-2 | gpt-6.1-sol |
| 发布日期 | 2026 年 11 月 9 日 | 2026 年 9 月 29 日 |
| 定位 | Anthropic 顶级档,高于 Opus | OpenAI 的 Sol 档,介于 GPT-6 Astra 和 GPT-6 Luna 之间 |
| 上下文窗口 | 1M Token | 1,050,000 Token(输入最多 922,000) |
| 最大输出 | 128K Token | 128K Token |
| 输入 → 输出 | 文本和图片 → 文本 | 文本和图片 → 文本 |
| 推理控制参数 | output_config.effort | reasoning.effort |
| effort 档位 | low 到 max,默认 high | low 到 max,默认 medium |
| 知识截止 | 2026 年 6 月 | 2026 年 4 月 30 日 |
| 官方输入 / 输出(每百万 Token) | $8 / $40 | $2 / $10(输入 ≤272K) $4 / $15(输入 >272K) |
| 官方缓存读取(每百万 Token) | $0.20 | $0.10(≤272K)/ $0.20(>272K) |
| PoYo 输入 / 输出(每百万 Token) | $6.40 / $32 | $1.60 / $8 |
| PoYo 接口 | /v1/messages、/v1/chat/completions | /v1/responses、/v1/chat/completions |
GPT-5.6 Sol vs Fable 5:你要比的是哪两个版本?
"GPT-5.6 Sol vs Fable 5" 排在前面的文章,大多写于 2026 年 7 月,那时这两个还是最新模型。之后两条产品线都发布了新版本:
| 模型 | 开发商 | 发布日期 | 发布时官方输入 / 输出(每百万 Token,短上下文) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 2026 年 6 月 9 日 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 2026 年 7 月 9 日 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 2026 年 9 月 1 日 | $10 / $50 |
| GPT-6 Sol | OpenAI | 2026 年 9 月 22 日 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 2026 年 9 月 29 日 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 2026 年 11 月 9 日 | $8 / $40 |
GPT-5.6 Sol vs Claude Fable 5:2026 年 7 月的那次对比
刚发布时,GPT-5.6 Sol 的输入价只有 Fable 5 的一半,输出价低 40%($5 / $30 对 $10 / $50,缓存输入是 $0.50 对 $1)。当月的第三方实测结论并不一致:
| 测试 | 测试方式 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo:三个系统设计方案 | Kilo Code CLI,两者都开 Max 推理,按事先写好的评分细则打分 | 三个任务都拿到最高分,每份方案都经过自我审查和修改;平均每份方案 52 分 53 秒;总花费 $13.57 | 测试方认为它的方案最容易直接照着实现;平均每份方案 15 分 27 秒;总花费 $12.02 |
| Composio:Golden Eval,47 个跨应用工具流程 | Fable 5 跑在 Claude Code 里;Sol 跑在 Codex CLI 里,用 high | 通过 45/47(95.7%);平均每个任务 223,779 Token、79.6 秒 | 通过 47/47(100%);平均每个任务 276,957 Token、84.4 秒 |
| Analytics Vidhya:网页应用、数据分析、投资人路演稿 | 相同提示词、新开对话、默认推理设置 | 质量相当,运行时间约为对方的两倍 | 质量相当,运行更快;作者推荐用于一次性交出去的长而复杂的工作 |
7 月那一代的规律是:GPT-5.6 Sol 适合规划和编程,Token 单价更低,还会花额外时间检查自己的成果;Fable 5 适合长工具流程,写出的方案容易直接照着实现。
这些结果说的是 7 月的模型,它们现在已经是上一代。之后价差进一步向 Sol 倾斜:Fable 5.2 的 Token 单价是 GPT-6.1 Sol 的 4 倍,而当时 Fable 5 的输入价是 GPT-5.6 Sol 的 2 倍、输出价约 1.7 倍。本文下面都比较当前这一对。已经针对 GPT-5.6 Sol 调好的集成,在 PoYo 上可以继续通过 Responses API 调用它。
两个模型的共同点和区别
共同点:
- 单次请求约 1M Token 上下文、128K Token 输出。
- 文本和图片输入,文本输出。
- 五个 effort 档位,从
low到max。两家各自校准自己的档位,所以请比较结果,而不是比较档位名称。 - 都支持提示缓存、流式输出和结构化输出。
区别:
- 默认 effort。 Fable 5.2 默认
high,Sol 默认medium。对比测试时请显式设置 effort,让两者都跑在你想要的档位上。 - 思考控制。 Fable 5.2 始终自适应思考,
tool_choice支持auto和none。Sol 用reasoning.effort配置,它的托管工具(网页搜索、文件搜索、代码解释器、托管 shell、apply patch、电脑操作、MCP、工具搜索)通过 OpenAI 的 Responses API 运行。 - 知识截止。 Fable 5.2 是 2026 年 6 月,Sol 是 2026 年 4 月 30 日。
- 数据保留。 在 Anthropic 的 API 上,Fable 5.2 采用 30 天数据保留。
价格:Token 单价差 4 倍,长提示词差 2 倍
官方价格(美元 / 每百万 Token)
| 计费项 | Claude Fable 5.2 | GPT-6.1 Sol,输入 ≤272K | GPT-6.1 Sol,输入 >272K |
|---|---|---|---|
| 输入 | $8.00 | $2.00 | $4.00 |
| 输出 | $40.00 | $10.00 | $15.00 |
| 缓存读取 | $0.20 | $0.10 | $0.20 |
| 缓存写入 | $10(5 分钟)/ $16(1 小时) | $2.50(30 分钟)/ $5.00(12 小时) | $5.00(30 分钟)/ $10.00(12 小时) |
OpenAI 对输入超过 272K Token 的提示词,整个请求的输入价和缓存价按 2 倍、输出价按 1.5 倍计算。Anthropic 对 Fable 5.2 的整个 1M 窗口都按标准价计费。在 PoYo 上,两个模型在整个上下文窗口内都是同一个价格,所以无论提示词多长,GPT-6.1 Sol 都是 $1.60 / $8。所有 Claude 模型的价格,请看我们的 Claude API 价格指南。
每次请求的成本
下面的示例假设两个模型消耗的 Token 数相同;实际用量因模型而异(见下一节)。两边都不计缓存写入费用。
| 场景 | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| 一次对话回复: 20K 输入 + 4K 输出 | 官方:0.02×8 + 0.004×40 = $0.32PoYo:$0.256 | 官方:0.02×2 + 0.004×10 = $0.08PoYo:$0.064 |
| 一个编程任务: 100K 输入 + 10K 输出 | 官方:0.1×8 + 0.01×40 = $1.20PoYo:$0.96 | 官方:0.1×2 + 0.01×10 = $0.30PoYo:$0.24 |
| 一份长文档: 500K 输入 + 20K 输出 | 官方:0.5×8 + 0.02×40 = $4.80PoYo:$3.84 | 官方:0.5×4 + 0.02×15 = $2.30PoYo:$0.96 |
| 一次智能体会话: 2M 缓存读取 + 300K 新输入 + 150K 输出,每个请求都低于 272K | 官方:2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo:$7.04 | 官方:2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo:$1.84 |
在 50 万 Token 的提示词上,Sol 的官方长上下文价格把价差从 4 倍缩小到约 2.1 倍。同样的请求在 PoYo 上用 GPT-6.1 Sol 只要 $0.96,因为 PoYo 对 Sol 统一按一个价格计费,没有长上下文倍率。
每个完成任务的成本
Token 单价只是账单的一半。Artificial Analysis 用同一套智能指数任务测试两个模型,并公布了成本:
| max effort | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| 每个指数任务的成本 | $26.54 | $1.27 |
| 每个指数任务的耗时 | 45.3 分钟 | 23.3 分钟 |
| 指数得分 | 65 | 55 |
成本相差约 21 倍,单价相差 4 倍:Fable 5.2 在每个任务上投入了多得多的推理,这也是它得分更高的来源;Sol 则用少得多的 Token 完成任务。在真实业务里,除了 Token 单价,也请比较每个合格任务的总花费。
基准测试
同一套测试:Artificial Analysis 智能指数
Artificial Analysis 用相同的任务和测试框架评估两个模型,所以它的数据可以直接对比。以下为智能指数 v5.0.1,读取于 2026 年 11 月 14 日:
| effort | Fable 5.2 得分 | GPT-6.1 Sol 得分 | Fable 5.2 每任务耗时 | Sol 每任务耗时 |
|---|---|---|---|---|
low | 54 | 35 | 5.8 分钟 | 2.0 分钟 |
medium | 56 | 46 | 7.7 分钟 | 4.6 分钟 |
high | 62 | 50 | 16.2 分钟 | 7.9 分钟 |
xhigh | 62 | 52 | 27.9 分钟 | 10.7 分钟 |
max | 65 | 55 | 45.3 分钟 | 23.3 分钟 |
怎么看这张表:
- 每个档位都是 Fable 5.2 得分更高,高出 10 到 19 分,适合最看重答案质量的工作。
- Fable 5.2 开
low的得分接近 Sol 开max(54 对 55),用时只有四分之一。 - Sol 以很低的成本拿到这些分数: max effort 下每个指数任务 $1.27,适合大批量和预算敏感的工作。
- Fable 生成 Token 更快: 每秒约 94–102 个输出 Token,Sol 是 47–49 个。
- Artificial Analysis 把 Fable 5.2 的测试结果标注为 "Default Fallback",意思是测试时开启了 Anthropic 的拒答回退。
Anthropic 公布的发布数据
Anthropic 的 Fable 5.2 发布表格对比的是 OpenAI 的顶级档 GPT-6 Astra。除特别标注外,各模型均为其可用的最高 effort:
| 基准测试 | 测什么 | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | 智能体编程 | 49.1%(xhigh) | 42.8% |
| FrontierSWE v2 | 软件工程 | 69.9% | 65.5% |
| AutomationBench | 业务流程 | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | 智能体科研 | 74.6% | 68.1% |
| OSWorld 2.1(offline set, partial) | 电脑操作 | 89.3% | 79.5% |
| Remote Labor Index | 真实付费任务 | 41.3%(high) | 20.8% |
| Humanity's Last Exam(带工具) | 高难度推理 | 74.2% | 57.2% |
| Chartography(不带工具) | 图表推理 | 73.4% | 71.0% |

FrontierCode 2.0 上各 effort 档位的得分与每任务成本。图表来自 Anthropic 的 Claude Fable 5.2 发布资料。
OpenAI 公布的发布数据
OpenAI 于 2026 年 9 月 29 日发布 GPT-6.1 Sol,比 Fable 5.2 早六周,发布时对比的是自家的 GPT-6 系列。OpenAI 把它定位为面向复杂编程、电脑操作和专业工作的模型,能力接近 GPT-6 Astra,Token 价格只有 Astra 的五分之一($2 / $10 对 $10 / $50)。它的发布评测覆盖软件工程、文档理解、业务自动化和电脑操作。
两家都在自己的测试框架和测试版本下跑基准,所以请在同一家的表格内比较分数;需要直接对比时,参考上面的 Artificial Analysis 指数。
怎么选?
| 你的工作 | 先用 | 原因 |
|---|---|---|
| 大批量对话、信息抽取、路由分发 | GPT-6.1 Sol,用 medium(或更小的模型) | 用 Fable 四分之一的 Token 单价处理短任务 |
| 预算有限的日常编程和智能体循环 | GPT-6.1 Sol | 专为编程和智能体工作打造,官方价 $2 / $10,PoYo 上 $1.60 / $8 |
| 最难的推理、科研、长时间自主运行 | Fable 5.2 | 智能指数 65 对 55;在 Anthropic 的表格里全面领先 GPT-6 Astra |
| 等待成本很高的难题 | Fable 5.2,用 low 或 medium | 用四分之一的时间拿到接近 Sol max 档的成绩 |
| 电脑操作、图表、复杂的视觉文档 | Fable 5.2 | Anthropic 表格中 OSWorld 2.1 为 89.3%,Chartography 为 73.4% |
| 提示词经常超过 272K Token | 看成本选 PoYo 上的 GPT-6.1 Sol,看深度选 Fable 5.2 | 在 PoYo 上两者整个窗口都是同一个价格:Sol $1.60 / $8,Fable $6.40 / $32 |
| 基于 OpenAI 托管工具(shell、网页搜索、MCP)构建 | GPT-6.1 Sol | 这些工具通过 Responses API 原生运行 |
| 想要 Claude 的质量,但预算更低 | Claude Opus 5.5 | $4 / $20;详见 Claude Fable 5.2 vs Opus 5.5 |
长时间自主运行正是 Fable 5.2 擅长的:画面中在笔记本电脑上运行的原型操作系统,就是由它的智能体打造的。视频来自 Anthropic 的 Claude Fable 5.2 发布资料。
一个实用的路由方案:日常流量发给 medium 档的 GPT-6.1 Sol,记录哪些类型的任务能从更深的推理中受益,再把这类任务交给 medium 档的 Fable 5.2。一周后按每个合格任务的成本重新评估,而不是只比较 Token 单价。中间价位的 Claude 选项和 Sol 怎么比,可以看 GPT-6.1 Sol vs Claude Opus 5.5。
在 PoYo 上同时使用两个模型
在 PoYo 上同时使用两个模型很简单:
- 一个 API Key 调用 Fable 5.2、GPT-6.1 Sol 以及所有其他对话、图像、视频、音频模型。
- 即用即付,按 Token 扣积分,无需订阅。
- 两种 API 格式都支持: Anthropic Messages,以及 OpenAI 的 Chat Completions 和 Responses。
- 每个模型在整个上下文窗口内一个价格,比各自的官方短上下文价格低 20%:
| 计费项(每百万 Token) | PoYo 上的 Claude Fable 5.2 | PoYo 上的 GPT-6.1 Sol |
|---|---|---|
| 输入 | $6.40 | $1.60 |
| 输出 | $32.00 | $8.00 |
| 缓存读取 | $0.16 | $0.08 |
| 缓存写入 | $8.00(5 分钟)/ $12.80(1 小时) | $2.00 |
通过 Anthropic Messages 格式调用 Fable 5.2:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "检查这段 diff 里的并发问题:..."}]
  }'
通过 Responses API 调用 GPT-6.1 Sol:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "检查这段 diff 里的并发问题:..."
  }'
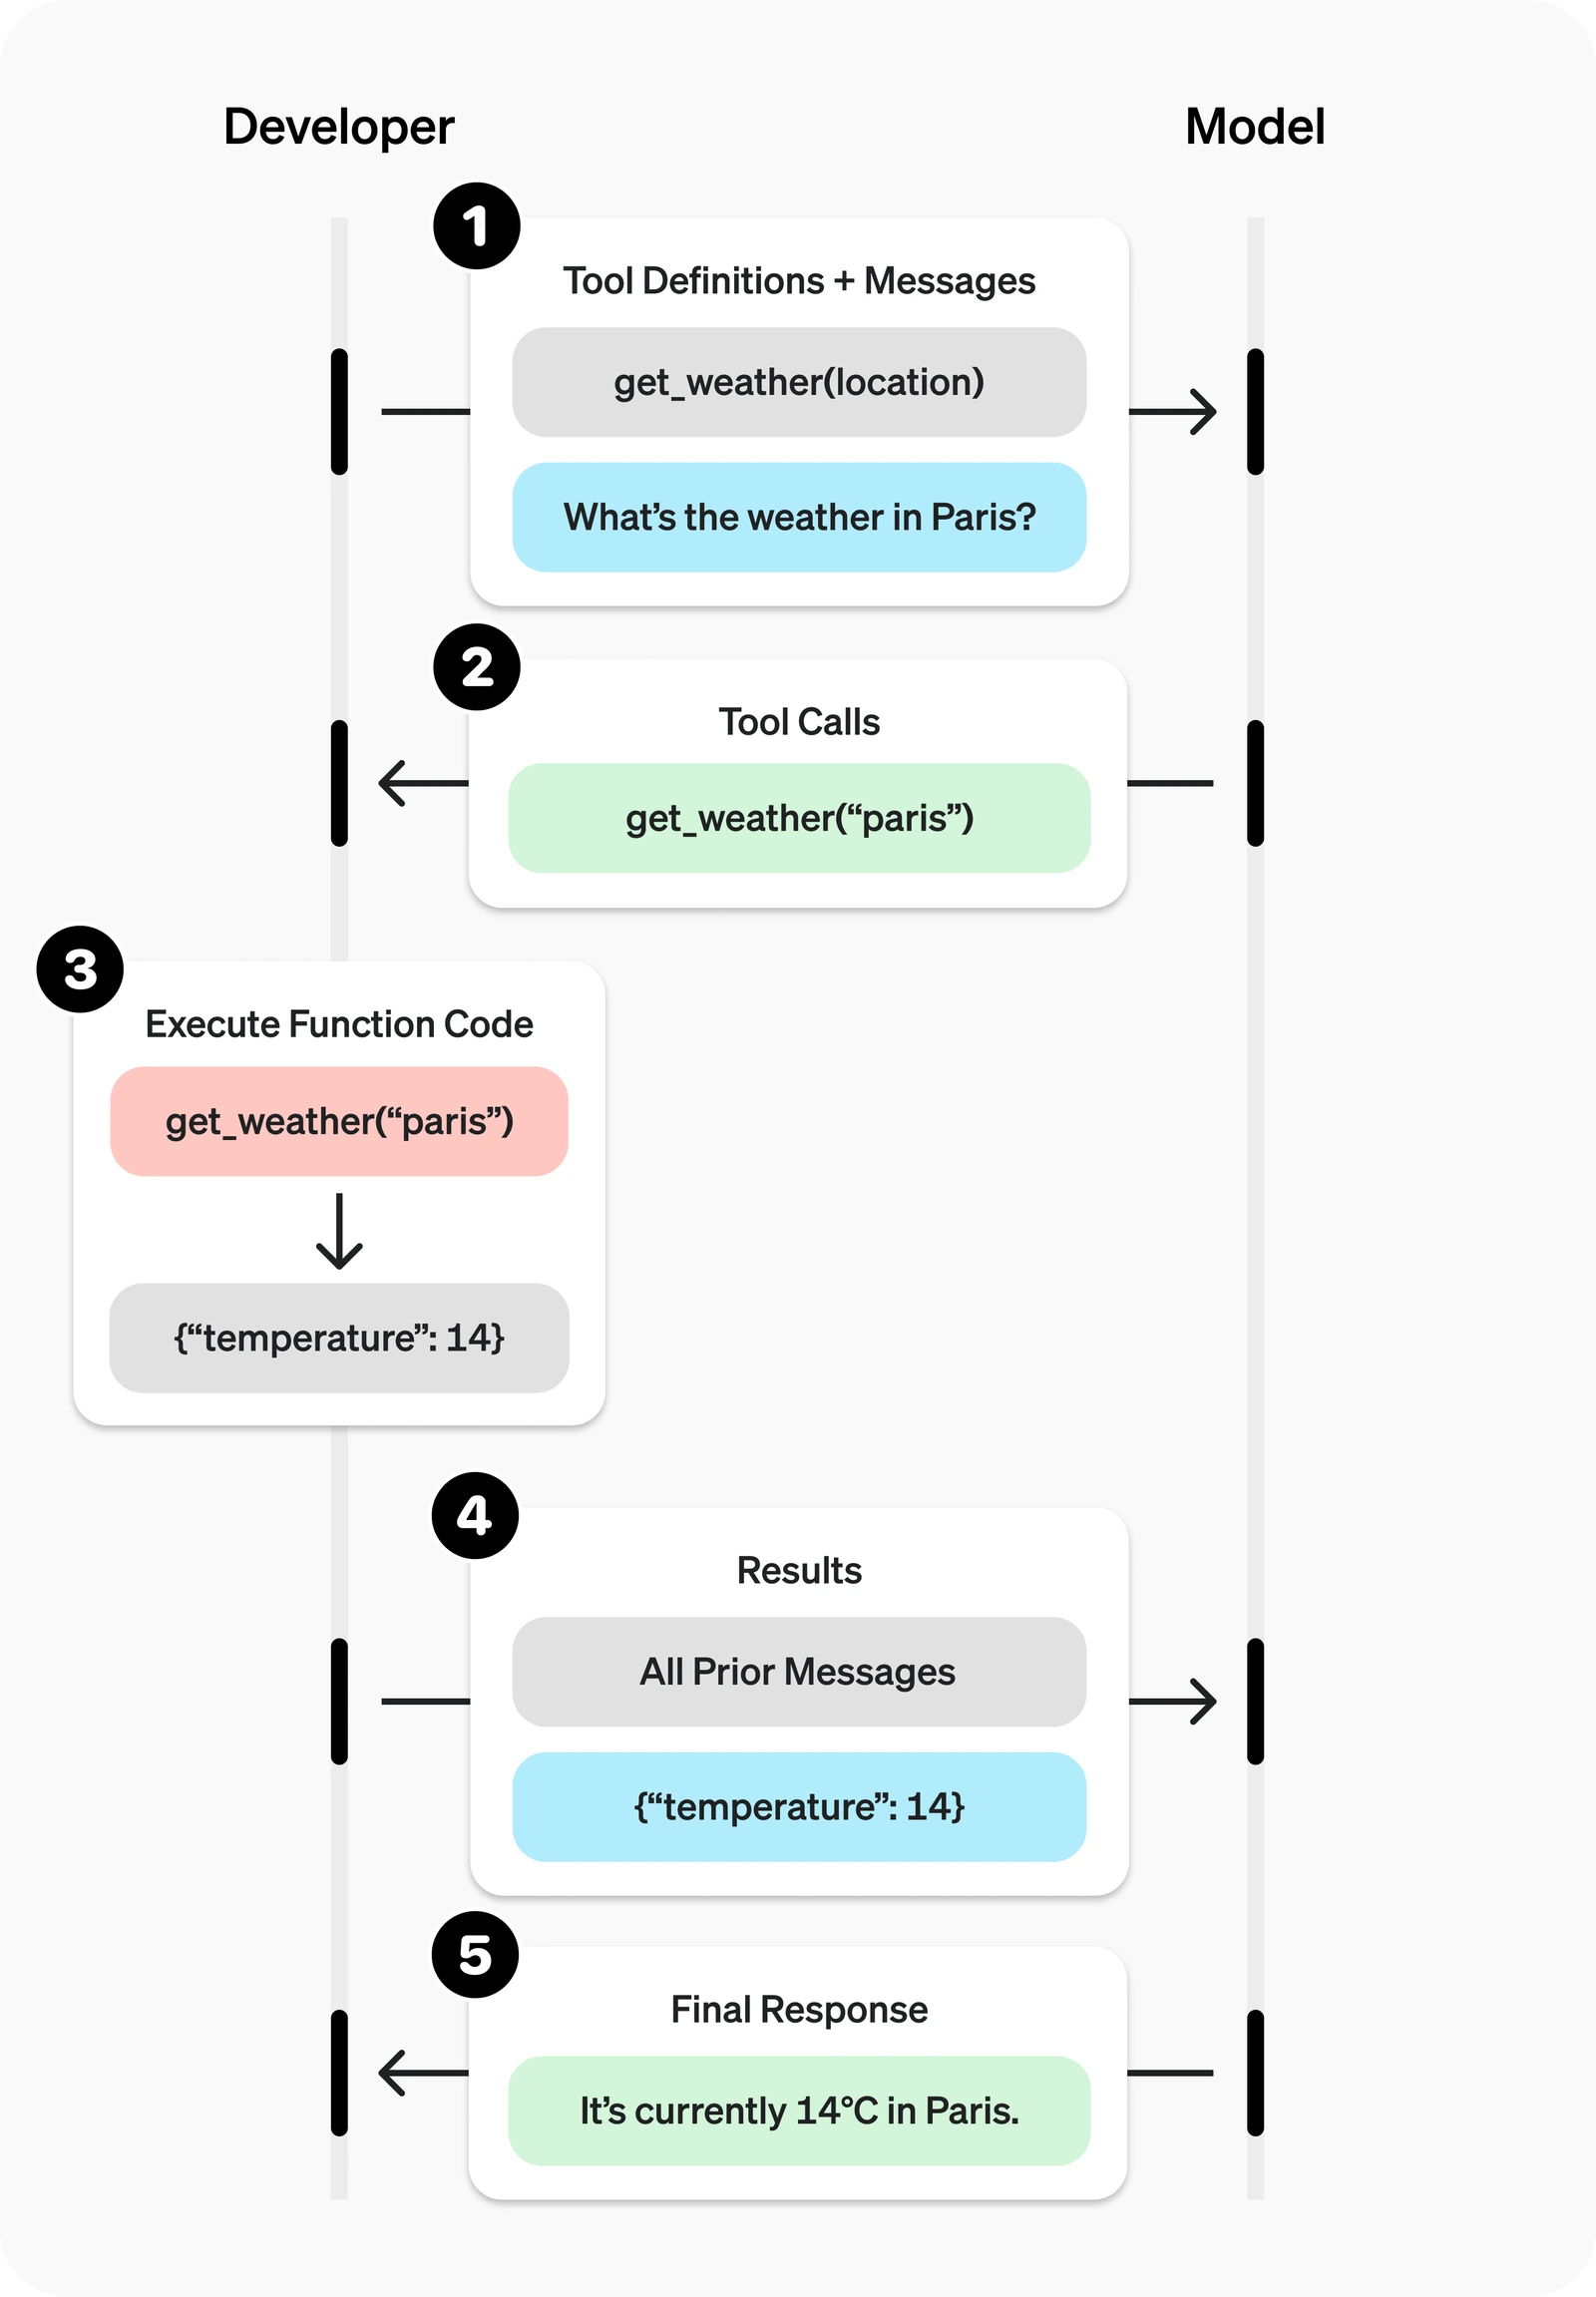
GPT-6.1 Sol 执行工具任务时使用的函数调用流程。示意图来自 OpenAI 官方文档。
想在同一套代码里做 A/B 测试,可以把 claude-fable-5-2 和 gpt-6.1-sol 都发到 /v1/chat/completions,只改 model 字段。Fable 的 SDK 配置、effort 和缓存用法,请看我们的 Claude Fable 5.2 API 接入指南;Sol 的限制和工具,请看 GPT-6.1 Sol 功能指南。
模型页面:Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6。
常见问题
Fable 5 比 GPT-5.6 Sol 更好吗?
两者各有所长。2026 年 7 月的实测中,Fable 5 通过了 Composio 全部 47 个跨应用工具流程(GPT-5.6 Sol 通过 45 个);而在 Kilo 的三个系统设计规划任务上,GPT-5.6 Sol 都拿到最高分,Token 单价也更低。到了当前这一代,在 Artificial Analysis 智能指数上,Fable 5.2 得 65 分,GPT-6.1 Sol 得 55 分,Sol 每个任务的成本只是一个零头。
GPT Astra 会比 Fable 更强吗?
GPT-6 Astra 已经发布,每百万 Token $10 / $50。在 Anthropic 的 Fable 5.2 发布表格里,凡是两者都参测的基准,Fable 5.2 都高于 GPT-6 Astra,比如 Terminal-Bench-Science 0.1 是 74.6% 对 68.1%,OSWorld 2.1 是 89.3% 对 79.5%。这些是 Anthropic 自己跑的数据,做决定之前请用你自己的任务测一下两者。
GPT-5.6 Luna 更好吗?
Luna 是 GPT-5.6 里最小、最实惠的一档,面向快速、大批量的工作;Sol 适合更难的任务。看重吞吐量和成本选 Luna,看重深度选 Sol。当前这一代的 GPT-6 Luna 标价为每百万 Token $0.10 / $0.50。
GPT-5.6 Sol 还值得用吗?
GPT-5.6 Sol 是上一代模型。新项目推荐用 OpenAI 当前的 Sol 模型 GPT-6.1 Sol:短上下文官方价每百万 Token $2 / $10,在 PoYo 上整个上下文窗口都是 $1.60 / $8。已经针对 GPT-5.6 Sol 调好的集成,继续用它也很合适。
Claude Fable 5.2 比 GPT-6.1 Sol 更好吗?
追求最强能力,选 Fable 5.2:在 Artificial Analysis 智能指数上,它在每个 effort 档位都高出 10 到 19 分。看重成本,选 GPT-6.1 Sol:它的 Token 单价只有四分之一,max effort 下每个指数任务的成本约为 Fable 的二十分之一。
Fable 5.2 和 GPT-6.1 Sol 哪个更便宜?
GPT-6.1 Sol。官方价格是每百万输入/输出 Token $2 / $10,Fable 5.2 是 $8 / $40。输入超过 272K Token 时,OpenAI 会把 Sol 整个请求提到 $4 / $15,而 Fable 仍是 $8 / $40。在 PoYo 上,无论提示词多长,Sol 都是 $1.60 / $8。
编程用哪个更好?
两家公布编程成绩用的是不同的基准。Anthropic 称 Fable 5.2 在 FrontierCode 2.0 上达到 49.1%,高于 GPT-6 Astra;OpenAI 则把 GPT-6.1 Sol 打造成面向复杂编程的模型,Token 价格只有 Astra 的五分之一。比较稳妥的默认做法是:大批量的常规编程用 Sol,大型、长时间运行的改动用 Fable 5.2。最好拿自己的一批真实工单把两者都跑一遍。
两个模型都有 1M 上下文窗口吗?
基本都有。Fable 5.2 的窗口是 1M Token。GPT-6.1 Sol 的窗口是 1,050,000 Token,其中输入最多 922,000 Token。两者单次请求都最多输出 128K Token。