Model icon
gemini-3-1-flash-tts
Text to Speech
模型:
Google Gemini 3.1 Flash TTS 可生成自然多语种语音,支持音频标签精细控制、自然风格指令和双人对话。
Input
270/50000
Two speakers
Speaker 1
Speaker 2
1.0
Output

示例输出

这是示例数据。生成新结果后可查看真实输出。

任务 ID:ZVT5QJYOGL1MQ2LW创建时间:2026-06-25 15:14:42
状态:finished进度:100%
Examples
定价详情

透明定价,无隐藏费用。按量付费,用多少付多少。

Googlegemini-3-1-flash-tts
Text to speech
PoYo价格
$0.120
24 积分
官方价格
$0.150
Reference
为你节省
20%

* 实际费用以最终输出为准。

介绍

使用 高性价比的 Gemini 3.1 Flash TTS API,音频标签精准控声表现 的完整指南

高性价比的 Gemini 3.1 Flash TTS API,音频标签精准控声表现

在 PoYo 使用 Gemini 3.1 Flash TTS 构建自然的文本转语音流程。通过一个异步 API 使用音频标签、自然语言风格指令、Gemini 语音预设、双人对话和标准任务状态查询。适合生成播客对白、应用语音、课程旁白、本地化语音和角色音频。

PoYo 上可用的 Gemini 3.1 Flash TTS API 模型

01

gemini-3-1-flash-tts

富有表现力的 Google TTS 模型,PoYo 价格为每 1000 字符 24 credits,即每 1000 字符 $0.12,支持 text、style_instructions、voice、language_code、speakers、temperature 和 output_format 控制。
体验 Playground

Gemini 3.1 Flash TTS 的核心优势

Gemini 3.1 Flash TTS 适合需要可控表达、多语种语音和对话音频的产品,不需要复杂的语音流水线即可完成高质量生成。

01
音频标签精细控制

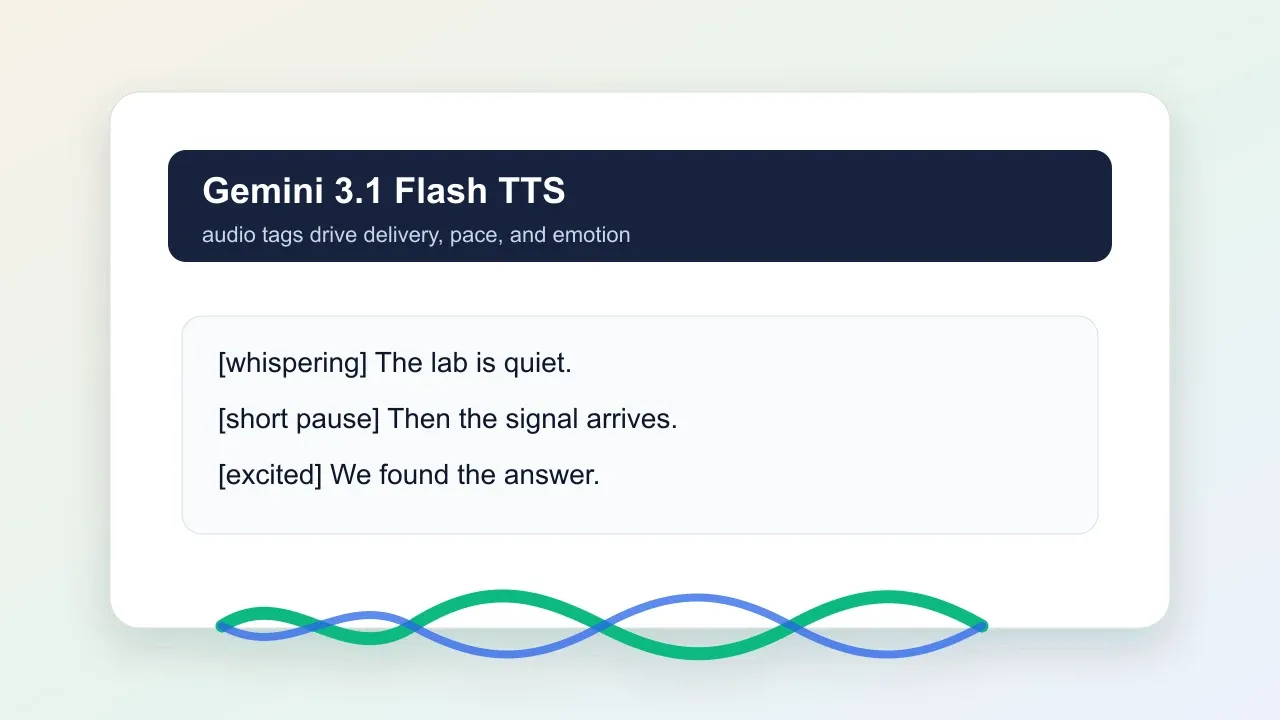
在脚本中直接加入 [sigh]、[laughing]、[whispering]、[short pause] 等标签,引导情绪、停顿、语速和非语言表达,让一个 text 字段同时承载台词和表演方向。
  • 控制情绪、节奏、停顿和非语言表达。
  • 适合故事、产品视频、播客和角色台词。
  • 让语音表现指令与脚本保持在同一处。
Gemini 3.1 Flash TTS 音频标签控制

02

双人对话语音

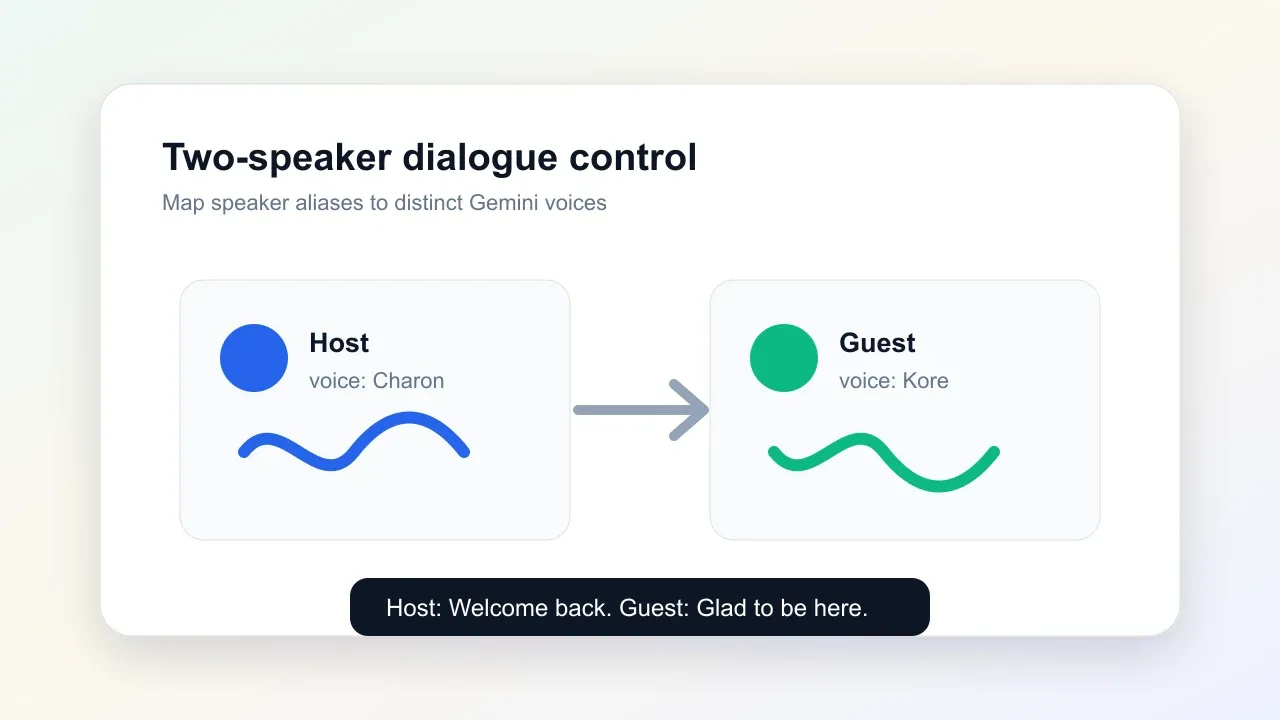
为两个 speaker_id 分配不同 Gemini voice,并在 text 中用相同别名前缀标注台词。这样可以快速生成播客访谈、角色对话和助手对话。
  • 创建主持人与嘉宾播客片段。
  • 原型验证角色对白和助手对话。
  • 为每个对话角色配置说话人别名和 voice。
Gemini 3.1 Flash TTS 双人对话

你可以构建什么

01

播客与旁白

生成主持人口播、开场片段、有声书旁白和内容解说,并通过风格指令控制表达。

02

学习内容

将课程脚本、入门教程和培训材料转换成清晰的多语种语音。

03

角色对白

快速原型验证游戏台词、角色扮演流程、故事场景和双人对话。

04

产品本地化语音

为应用提示、客服消息、产品演示和无障碍体验生成多语言语音资产。

Gemini 3.1 Flash TTS 价格:PoYo vs fal.ai

PoYo 通过统一异步生成流程提供 Gemini 3.1 Flash TTS,和其它 PoYo 音频模型保持一致的提交、轮询和结果获取方式,并提供清晰的Fal.ai对比。
对比项PoYoFal.ai
公开模型 IDgemini-3-1-flash-tts不对外暴露
Fal.ai$0.12 / 1000 字符$0.15 / 1000 字符
PoYo credits24 credits / 1000 字符N/A
核心参数text, style_instructions, voice, language_code, speakers, temperature, output_format文本输入、风格、语音、语言、说话人、temperature 和格式控制
工作流提交任务、查询标准状态、下载音频文件参考队列工作流

PoYo 定价为每 1000 字符 24 credits。一个 credit 按 $0.005 计价。

如何在 PoYo 使用 Gemini 3.1 Flash TTS

  1. 获取 API Key:注册 PoYo 并在控制台创建 API Key。获取 API Key ->
  2. 编写 text:输入要朗读的 text,并按需加入 [laughing]、[sigh]、[whispering]、[short pause] 等音频标签。
  3. 选择语音设置:选择 Gemini voice,可选 language_code、style_instructions、temperature、output_format,或配置正好两个包含 speaker_id 和 voice 的 speakers。
  4. 提交并获取结果:通过 PoYo generate API 提交任务,再使用标准任务状态接口获取音频输出。查看 API 文档 ->

Gemini 3.1 Flash TTS 常见问题

Gemini 3.1 Flash TTS 是什么?

Gemini 3.1 Flash TTS 是 Google 的表现力文本转语音模型,可从文本生成自然的多语种音频,支持音频标签、自然语言风格指令、Gemini voice preset 和双人对话。

text 字段应该填写什么?

text 填写需要朗读的内容,也可以包含 [laughing]、[sigh]、[whispering]、[short pause] 等内联音频标签。使用多说话人配置时,在台词前加 Host:、Guest: 这类 speaker_id 前缀。

style_instructions 如何使用?

style_instructions 用于描述整段语音的风格,例如温暖缓慢、新闻播报、英式口音、欢快语气或神秘低语,适合把全局表达要求与正文分开。

Gemini 3.1 Flash TTS 支持音频标签吗?

支持。音频标签是该模型的核心优势,可在脚本中控制情绪、停顿、笑声、低语、节奏和其它表达细节。

支持哪些 voice 和语言?

API 暴露 30 个 Gemini voice preset,例如 Kore、Puck、Charon、Zephyr 和 Aoede。模型支持 70+ 语言,并可通过 language_code 进行语言引导。

可以生成多人对话吗?

可以。当前 PoYo API 支持配置正好两个 speakers,每个 speaker 包含 speaker_id 和 voice。text 中使用相同 speaker_id 前缀,模型会把对应台词分配给对应 voice。配置 speakers 时,顶层 voice 会被忽略。

支持哪些输出格式?

PoYo 对 Gemini 3.1 Flash TTS 支持 mp3、wav 和 ogg_opus。mp3 是默认格式,适合网页和应用播放时控制文件体积。

如何计费并获取结果?

PoYo 按每 1000 字符 24 credits 计费,即 $0.12 / 1000 字符。提交生成请求后,使用返回的 task_id 调用 PoYo 标准任务状态接口获取音频文件。

为什么使用 PoYo

01

清晰的按字符计费

以每 1000 字符 $0.12 使用 Gemini 3.1 Flash TTS,credit 账单清晰可预期。

02

统一模型访问

在同一个 PoYo 账户中统一使用文本、图像、视频和音频模型,复用计费、状态查询和 callback 流程。

03

生产级异步流程

提交异步任务、查询稳定任务状态,并通过同一个 API surface 获取最终语音文件。

04

表达控制完整

提供 text、style、voice、language、speakers、temperature 和 output_format 等生产常用控制。