Model icon
grok-4.7
Model:
Grok 4.7 er tilgængelig på PoYo via /v1/chat/completions. Brug model-ID'et grok-4.7. Pr. million tokens: input $1.6, output $4.8, cache-læsninger $0.4. Basepriserne er 80 % af de officielle standardpriser.
Chat

Denne Playground er kun til demonstration. Data er kun gyldige i det aktuelle vindue og ryddes, når du opdaterer siden.

Skriv en besked...

Konfiguration
1.0
1.0
Prisdetaljer

Betal efter forbrug. Intet abonnement og ingen skjulte gebyrer.

1 kredit = $0.005
ModelInput /1M tokensCache-læsning /1M tokensOutput /1M tokens
Grok 4.7
100K input- + 20K output-tokens: $0.256
$1.60/1M tokens
320 kreditter/1M tokens
$2.00/1M tokensSpar 20 %
$0.400/1M tokens
80 kreditter/1M tokens
$0.500/1M tokensSpar 20 %
$4.80/1M tokens
960 kreditter/1M tokens
$6.00/1M tokensSpar 20 %
Sådan afregnes det: Input- og output-tokens afregnes hver for sig pr. 1M tokens.

Prisen beregnes ud fra det endelige output.

GROK 4.7 · TILGÆNGELIG NU

Førende agentbaseret kodning, vidensworkflows over flere timer og ræsonnering over lang kontekst på 256K

Grok 4.7 API: førende agentbaseret kodning og vidensarbejde

Grok 4.7 er SpaceXAI's (xAI) næste generation af førende intelligens, udviklet specielt til agentbaseret kodning, terminalautomatisering og professionelt vidensarbejde over lange tidshorisonter. Modellen er bygget på en ny, markant større grundarkitektur med omfattende reinforcement learning på komplekse opgaver over flere timer, og den bevæger sig fra evalueringer med enkelte prompts mod pålidelig udførelse gennem lange udviklersessioner.

Grok 4.7 er tilgængelig på PoYo via /v1/chat/completions. Brug model-ID'et grok-4.7. Pr. million tokens: input $1.6, output $4.8, cache-læsninger $0.4. Basepriserne er 80 % af de officielle standardpriser.

Vigtigste funktioner i Grok 4.7 API

Selvstændig terminalkodning, indbygget selvverificering og ræsonnering over lang kontekst på 256K giver pålidelig agentydelse i udviklingsopgaver, der varer flere timer.

01

Grok 4.7 API til selvstændig terminal- og agentbaseret kodning

Selvstændige kodeagenter støder ofte på problemer med kommandolinjeværktøjer, testmiljøer og komplekse build-fejl i flere trin. Grok 4.7 tager et stort spring på benchmarks for agentbaseret kodning med 38,0 % på Terminal-Bench 4.0 (+17,7 point i forhold til Grok 4.6) og 71,0 % på DeepSWE v1.1. Udviklere og udviklingsteams kan automatisere indviklede migreringer på tværs af mange filer, køre testsuiter fra ende til anden og løse problemer i hele repositories med vedvarende præcision.

  • 38,0 % på Terminal-Bench 4.0 (+17,7 point forbedring)
  • 71,0 % på DeepSWE v1.1 for kodning i hele repositories
  • Driv vedvarende kommandolinje- og kodeudførelse i flere trin
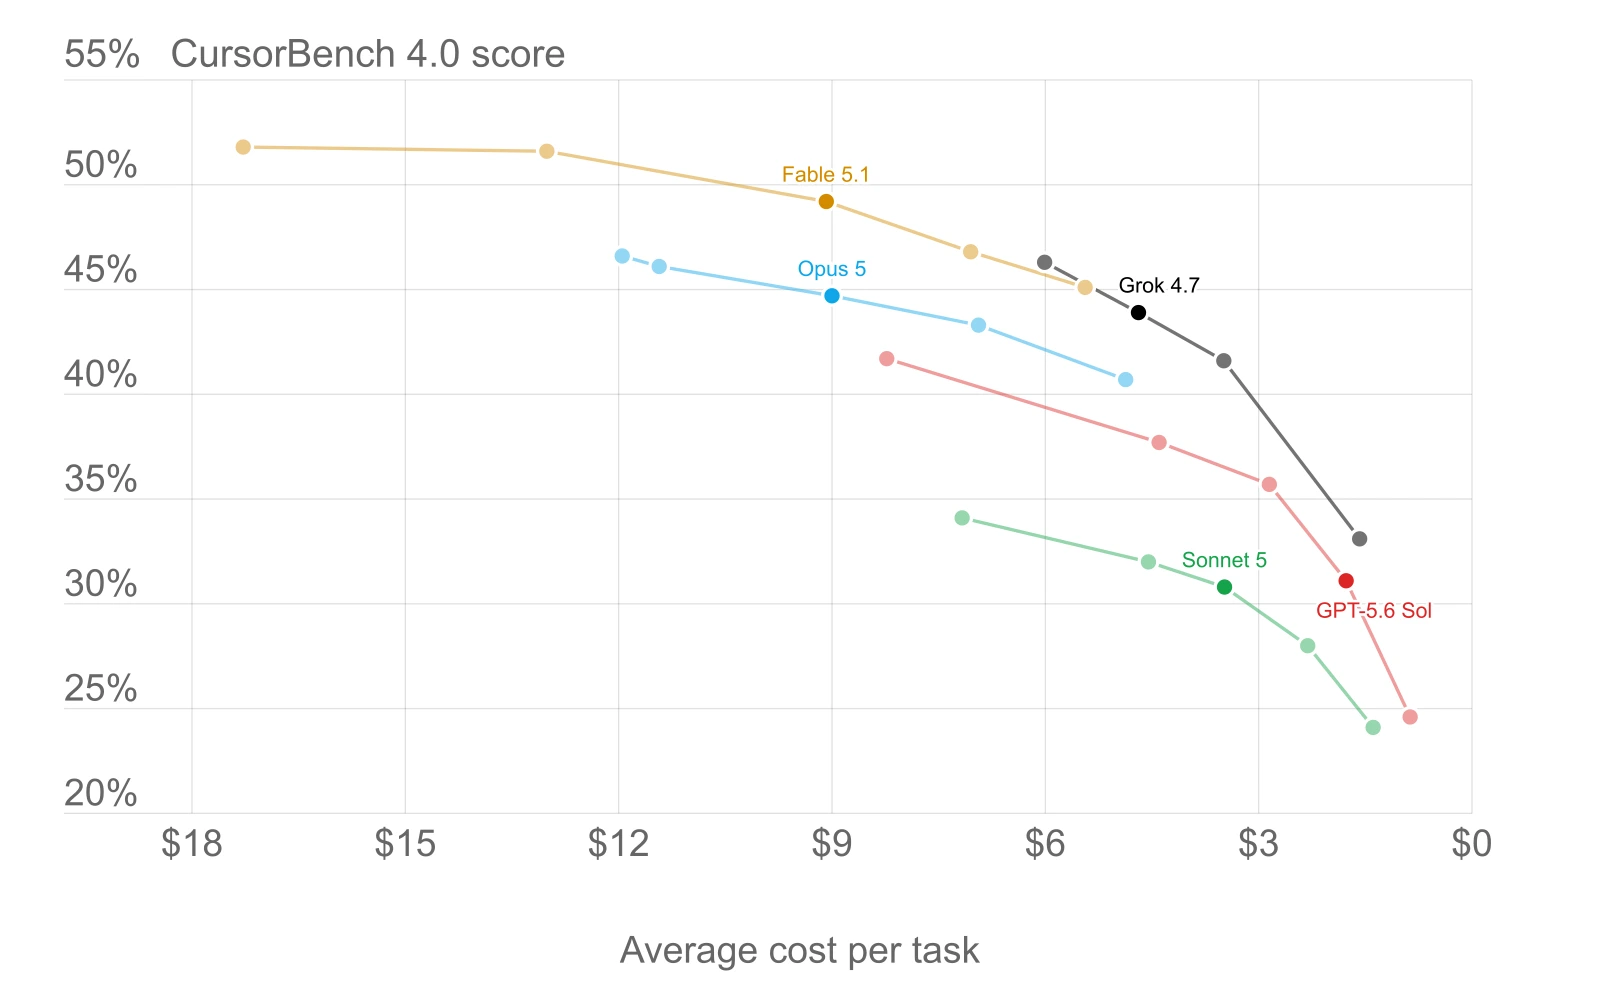
Officielt xAI-diagram over CursorBench 4.0-benchmarken

02

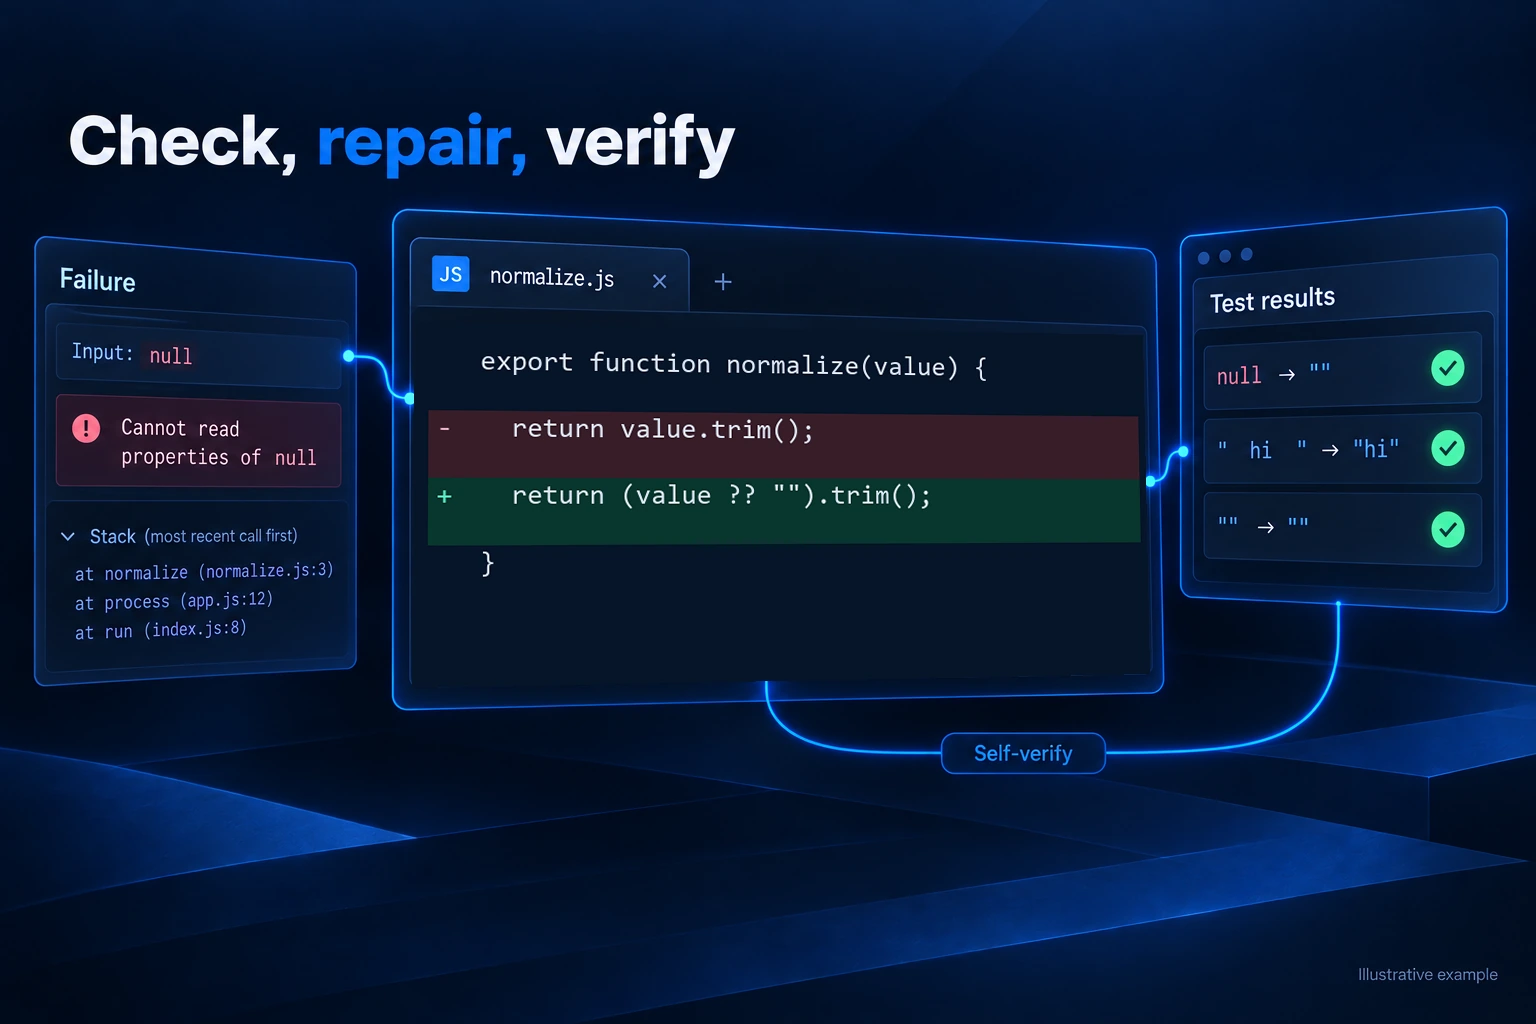
Grok 4.7 API til selvverificering i realtid og pålidelige opgaver

Komplekse ræsonneringsforløb forringes ofte i lange samtaler med mange ture på grund af ophobede fejl og hallucinationer. Grok 4.7 har indbyggede selvverificeringsmekanismer, som er trænet direkte ind i modellens reinforcement learning-forløb, så den opdager og retter sine egne logiske fejl i realtid. Det giver pålidelig kodegenerering og stabil udførelse af opgaver over flere timer uden manuelt tilsyn.

  • Indbyggede selvverificeringsløkker fanger fejl under genereringen
  • Reducerer logisk afdrift og ophobede fejl markant
  • Bevarer ensartet nøjagtighed gennem professionelle sessioner over flere timer
Opdagelse af en fejl ved tomt input, tilføjelse af en kontrol og ny kørsel af de relaterede tjek

03

Grok 4.7 API til analyse af hele kodebaser og vidensarbejde

Fragmenterede retrievalforløb mister ofte afhængigheder mellem filer i arkitekturen, når de skal håndtere store virksomhedskodebaser eller tæt teknisk litteratur. Grok 4.7 har et standardkontekstvindue på 256K tokens med understøttelse af op til 500K tokens, kombineret med indbygget multimodal forståelse af tekst, diagrammer og kode. Teams kan gennemgå hele repositories, sammenfatte omfattende dokumentation og bevare hele projektets tilstand i en enkelt prompt.

  • Behandl op til 256.000 tokens som standard, udvidelig til 500K
  • Bevar dyb genkaldelse på tværs af filer i store repositories
  • Analysér kompleks teknisk dokumentation og diagrammer problemfrit
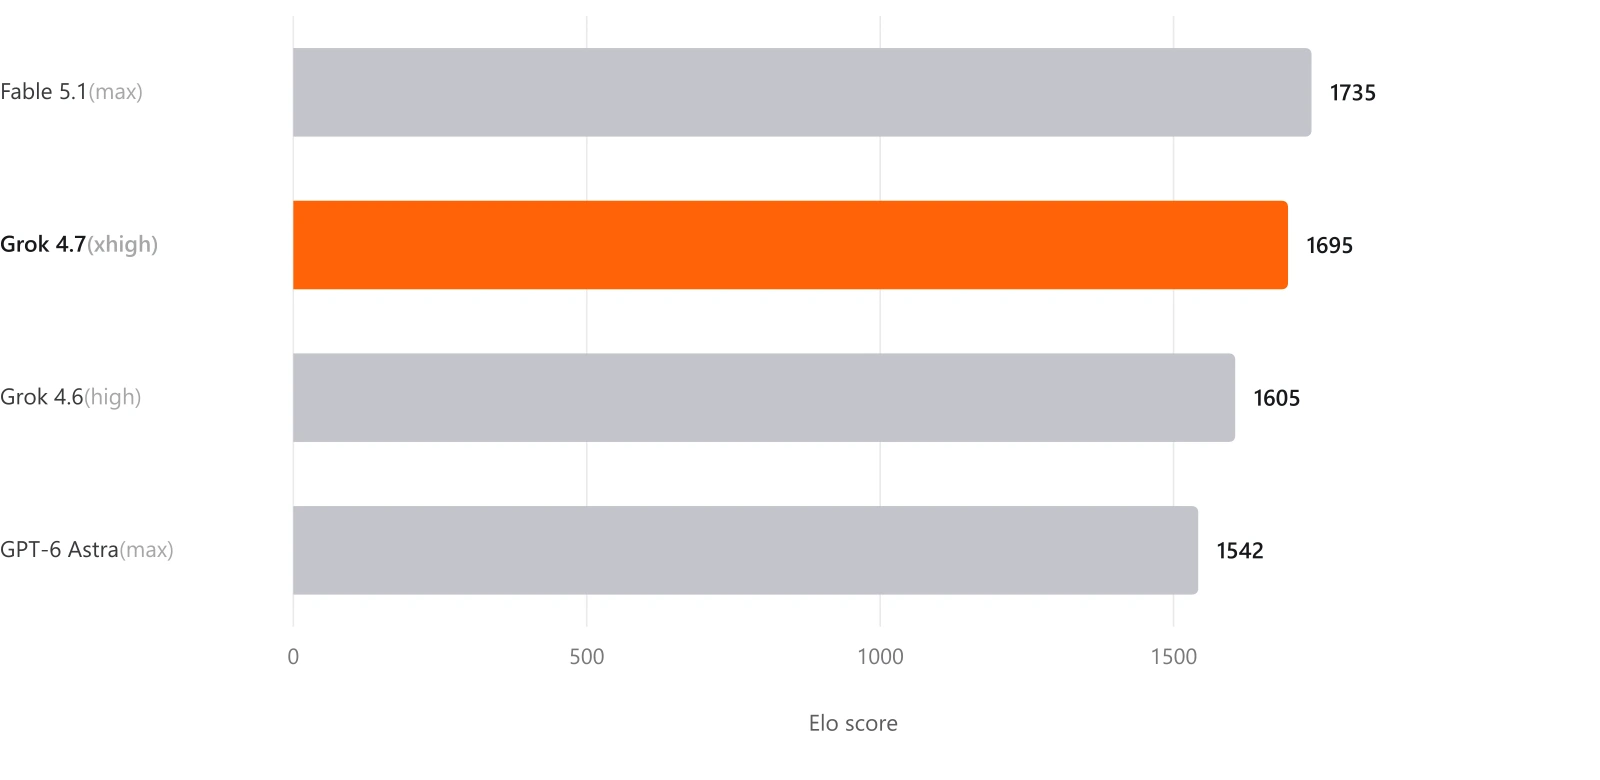
Officielt xAI-diagram over GDPval-benchmarken

04

Grok 4.7 API til indbyggede workflows med flere værktøjer og dynamisk ræsonnering

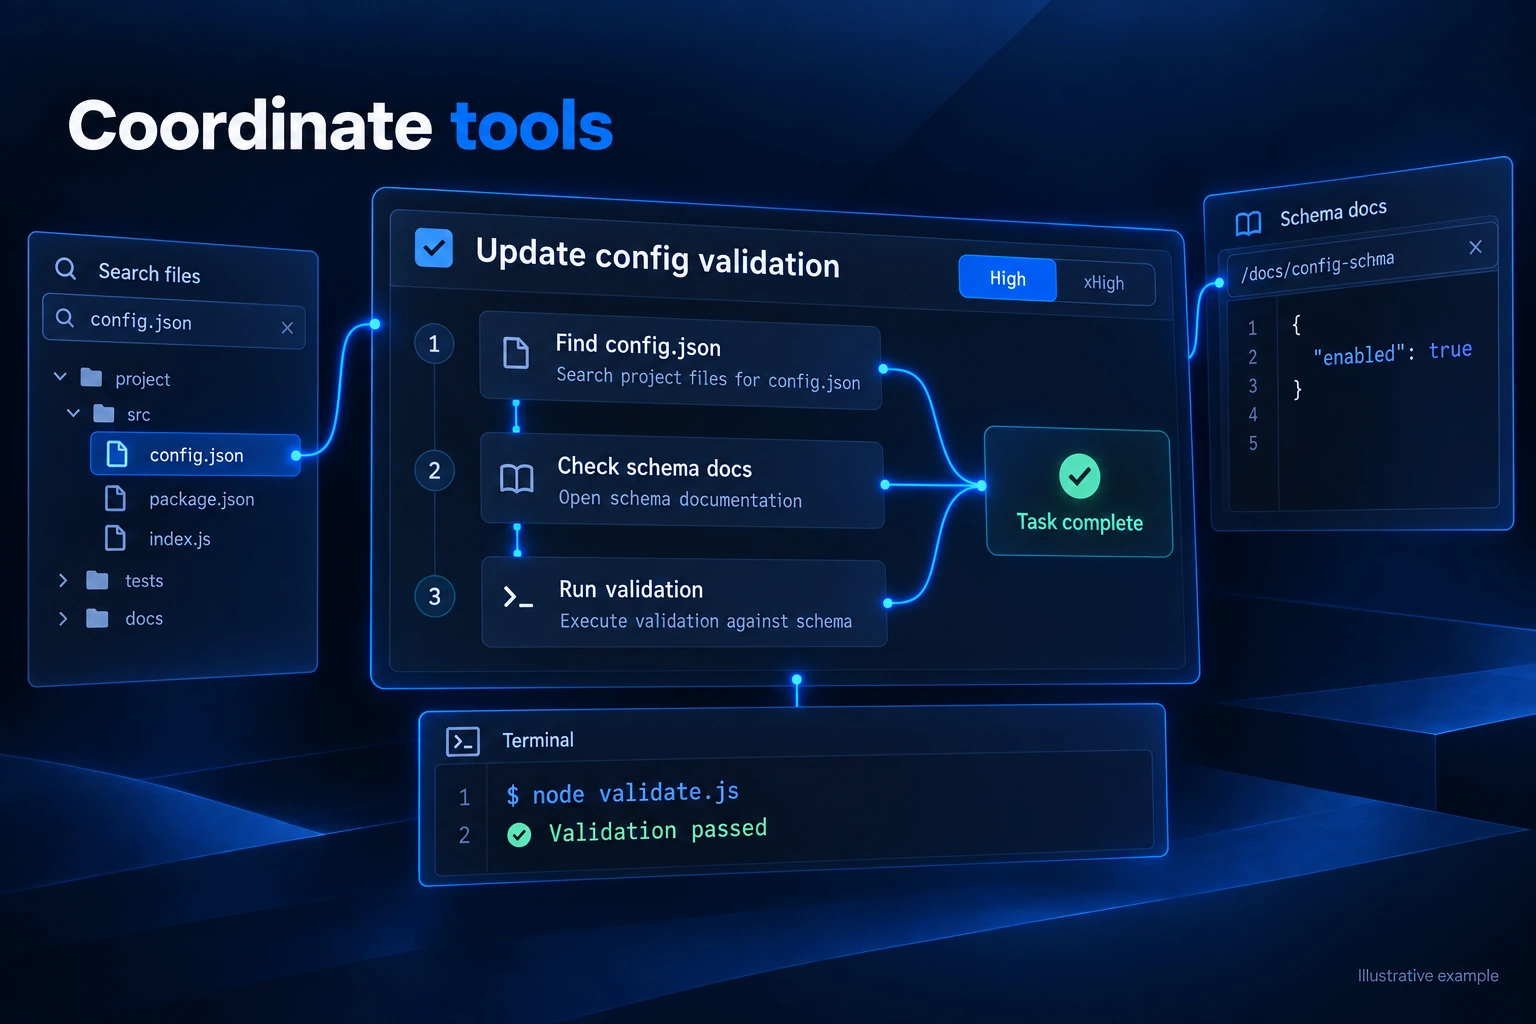
Moderne agentbaserede workflows kræver problemfri koordinering af filhåndtering, websøgning, shell-kørsel og varierende ræsonneringsintensitet. Grok 4.7 er optimeret indbygget til samtalebaserede agentrammer med indbygget værktøjskald. Udviklere kan dynamisk skifte mellem High-indsats (standard) og xHigh-indsats for maksimal dybde på de mest krævende tekniske og matematiske problemer.

  • Trænet indbygget til agentrammen Grok Bot
  • Konfigurér ræsonneringsniveauerne High (standard) og xHigh
  • Orkestrér filsøgning, shell-kørsel, opslag på nettet og kodegenerering
Koordinering af lokal filsøgning, dokumentationsopslag og shell-kørsel med High- og xHigh-indsats

Hvem har gavn af Grok 4.7 API?

01

Softwareudviklingsteams

Indsæt selvstændige kodeagenter, der refaktorerer hele repositories, finder indviklede fejl på tværs af flere filer, genererer omfattende testsuiter og gennemgår pull requests med topkonsistens.

02

Udviklere af selvstændige agenter

Byg robuste agenter til lange samtaler, der bruger Grok Bots indbyggede værktøjer, filsøgning og selvverificering til at køre selvstændige workflows over flere timer uden at miste opgavens retning.

03

Hardware- og elektroingeniører

Udnyt Grok 4.7's banebrydende score på 64,0 % på EEBench til at gennemgå komplekse elektriske kredsløbsdiagrammer, kontrollere komponentspecifikationer og automatisere tekniske beregninger.

04

Specialister i juridisk og teknisk research

Sammenfat tætte regelsæt, analysér kontrakter med flere parter med Harvey Legal Agent-benchmarks (19,6 %), og behandl hundredvis af siders research i en kontekst på 256K.

05

DevOps- og systemautomatiseringsteams

Automatisér serverdiagnostik, deployment-pipelines og terminaloperationer med Grok 4.7's førende evne på 38,0 % i Terminal-Bench til sikkert at udføre shell-miljøer i flere trin.

06

Full-stack- og produktbyggere

Lav hurtigt prototyper af komplette applikationer, omsæt specifikationer til testede frontend- og backend-komponenter, og validér produktfunktioner fra ende til anden i udviklermiljøer som Cursor.

Grok 4.7 vs Grok 4.6 – modelsammenligning

Grok 4.7 giver generationsspring i forhold til Grok 4.6 inden for agentbaseret kodning, terminalautomatisering, selvverificering og stabilitet i sessioner over flere timer – til samme prisniveau.

EgenskabGrok 4.7Grok 4.6
ArkitekturgrundlagNy, større grundmodel + udvidet RLGrundarkitektur fra Grok 4.6
Kontekstvindue256K som standard / op til 500K tokens128K – 256K tokens
Terminal-Bench 4.038,0 % (+17,7 point)20,3 %
DeepSWE v1.1-kodningsbenchmark71,0 % (+5,8 point)65,2 %
EEBench (elektroteknik)64,0 % (+11,0 point)53,0 %
Selvverificering og -rettelseIndbygget selvverificering trænet med RLGrundlæggende verificering over flere ture
Integration med agentrammeIndbygget Grok Bot-ramme og værktøjskaldStandard function calling
RæsonneringstilstandeNiveauerne High (standard) og xHighÉt indsatsniveau

Benchmarktallene afspejler officielle tekniske udgivelser fra xAI og offentlige evalueringer pr. september 2026. PoYo giver samlet adgang med betaling efter forbrug.

Sådan integrerer du Grok 4.7 API på PoYo

Opret en PoYo API-nøgle, tilføj kreditter, og send derefter en anmodning med endpointet og model-ID'et nedenfor.

Grok 4.7 er tilgængelig på PoYo via /v1/chat/completions. Brug model-ID'et grok-4.7.

Opret API-nøgle → · Tilføj kreditter → · Se dokumentationen →

Ofte stillede spørgsmål om Grok 4.7 API

Hvad er Grok 4.7, og hvem har udviklet den?

Grok 4.7 er SpaceXAI's (xAI) førende flagskibsmodel, som officielt blev udgivet den 21. september 2026. Den er optimeret til agentbaseret kodning over lange tidshorisonter, ræsonnering i flere trin, terminaludførelse og professionelt vidensarbejde.

Hvordan er Grok 4.7 sammenlignet med Grok 4.6?

Grok 4.7 er en arkitektonisk opgradering på generationsniveau og ikke blot en mindre rettelse. Den har en ny, større basismodel, udvidet reinforcement learning på opgaver over flere timer, en markant forbedring på 17,7 point på Terminal-Bench 4.0 (38,0 %) og indbyggede selvverificeringsmekanismer.

Hvor stort er kontekstvinduet i Grok 4.7?

Grok 4.7 har et standardkontekstvindue på 256.000 tokens og et udvidet niveau, der kan behandle op til 500.000 tokens til omfattende kodebaseanalyse og sammenfatning af lange dokumenter.

Hvordan fungerer ræsonneringsniveauerne (High vs xHigh)?

Grok 4.7 bruger som standard High-indsats, som balancerer hastighed og ræsonneringsdybde. Til de mest krævende matematiske og elektrotekniske opgaver og arkitekturmæssige refaktoreringer kan udviklere angive xHigh for at afsætte mere regnekraft og udforske dybere.

Hvilke muligheder for værktøjskald og agenter understøttes?

Grok 4.7 forstår Grok Bot-rammen indbygget og understøtter værktøjsudførelse som filsøgning i arbejdsområdet, læsning og redigering af kode, kørsel af shell-kommandoer, websøgninger og strukturerede outputs.

Hvordan klarer Grok 4.7 sig i kodeeditorer som Cursor?

Grok 4.7 anses for at være en førende model til agentbaseret kodning i Cursor og Grok Build. Den er stærk til at holde fokus i komplekse workflows over flere timer, automatiseret testverificering og vedvarende fejlrettelser.

Understøtter Grok 4.7 multimodale input?

Ja. Grok 4.7 understøtter tekst- og billedinput (vision), så udviklere kan sende arkitekturdiagrammer, UI-mockups og skemaer med sammen med instruktionerne.

Er Grok 4.7 tilgængelig på PoYo?

Grok 4.7 er tilgængelig på PoYo via /v1/chat/completions. Brug model-ID'et grok-4.7.

Hvad koster Grok 4.7 på PoYo?

Pr. million tokens: input $1.6, output $4.8, cache-læsninger $0.4. Basepriserne er 80 % af de officielle standardpriser.

Hvorfor bruge PoYo til adgang til Grok 4.7 API

01

Førende intelligens til agentbaseret kodning

Få tidlig indsigt i og hurtig adgang til Grok 4.7's førende resultater på Terminal-Bench 4.0 og DeepSWE, som er skabt til avancerede, selvstændige udviklerworkflows.

02

Samlet API og høj samtidighed

Integrér Grok 4.7 sammen med modeller fra OpenAI, Anthropic og Google med én API-nøgle, OpenAI-kompatibel syntaks og oppetid i virksomhedsklassen.

03

256K kontekst og koordinering af flere værktøjer

Udnyt fulde kontekstvinduer på 256K og vedvarende værktøjskald fra agenter med optimeret svartid, pålidelig streaming og omfattende teknisk dokumentation.

04

Gennemsigtig betaling efter forbrug

Slip for dyre faste abonnementer. Fyld op efter behov, og betal kun for de tokens, dine produktionsapplikationer faktisk bruger.