Model icon
gemini-3-1-flash-tts
Text to Speech
Modelo:
Google Gemini 3.1 Flash TTS genera discurso multilingüe expresivo con etiquetas de audio granulares, control de estilo natural y diálogo two-speaker.
Input
270/50000
Two speakers
Speaker 1
Speaker 2
1.0
Output

Salida de ejemplo

Estos son datos de muestra. Genere un nuevo resultado para ver el resultado real.

ID de tarea:ZVT5QJYOGL1MQ2LWCreado:2026-06-25 15:14:42
Estado:finishedProgreso:100%
Examples
Detalles de precios

Precios transparentes sin tarifas ocultas. Pague solo por lo que use.

Googlegemini-3-1-flash-tts
Text to speech
Precio de PoYo
$0.120
24 créditos
Precio oficial
$0.150
Reference
Ahorras
20%

* Las tarifas reales se basan en el resultado final.

Introducción

Guía completa para usar Asequible Gemini 3.1 Flash TTS API para un control preciso por voz Audio-Tag

Asequible Gemini 3.1 Flash TTS API para un control preciso por voz Audio-Tag

Cree flujos de trabajo naturales text-to-speech con Gemini 3.1 Flash TTS en PoYo. Utilice etiquetas de audio expresivas, instrucciones de estilo natural-language, ajustes preestablecidos de voz Gemini, diálogo two-speaker y sondeo de estado asíncrono estándar a través de un API. Genere líneas de podcasts, voces de aplicaciones, narraciones de aprendizaje y discursos localizados a precios claros de per-character.

Modelos disponibles Gemini 3.1 Flash TTS API en PoYo

01

gemini-3-1-flash-tts

Expresivo Google TTS a créditos 24 por caracteres 1000, equivalentes a $0.12 por caracteres 1000 en PoYo, con controles para texto, instrucciones de estilo, voz, idioma, parlantes, temperatura y formato de salida.
Prueba el patio de juegos

Por qué Gemini 3.1 Flash TTS es diferente

Gemini 3.1 Flash TTS está diseñado para voz que sigue la dirección, cambia la entrega y admite flujos de trabajo de productos multilingües sin una canalización de voz compleja.

01
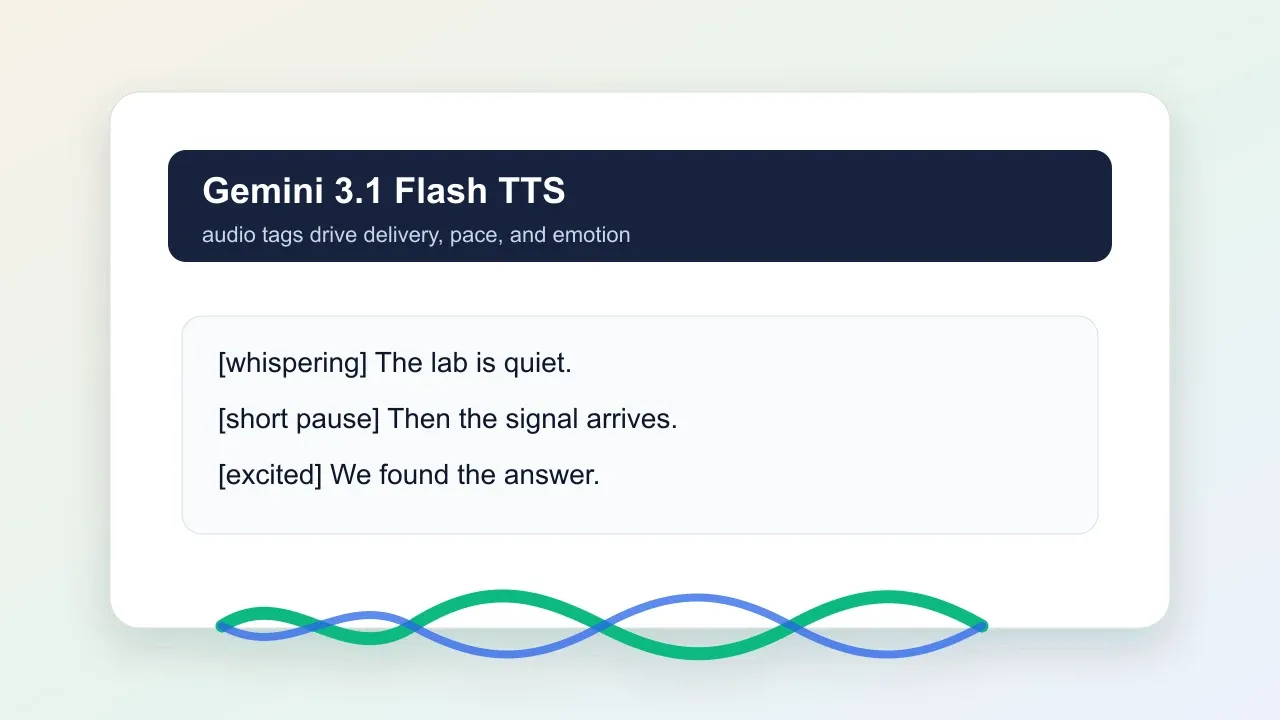
Etiquetas de audio granular

Guíe la entrega dentro del guión con etiquetas expresivas como [suspiro], [risas], [susurros] y [pausa corta]. Esto hace que un único campo de texto sea útil tanto para palabras como para dirección de interpretación.
  • Controle las emociones, el ritmo y las señales de entrega non-verbal.
  • Utilice etiquetas para historias, vídeos de productos, podcasts y líneas de personajes.
  • Mantenga la dirección del discurso expresivo cerca del guión.
Gemini 3.1 Flash TTS control de etiquetas de audio

02

Diálogo Two-Speaker

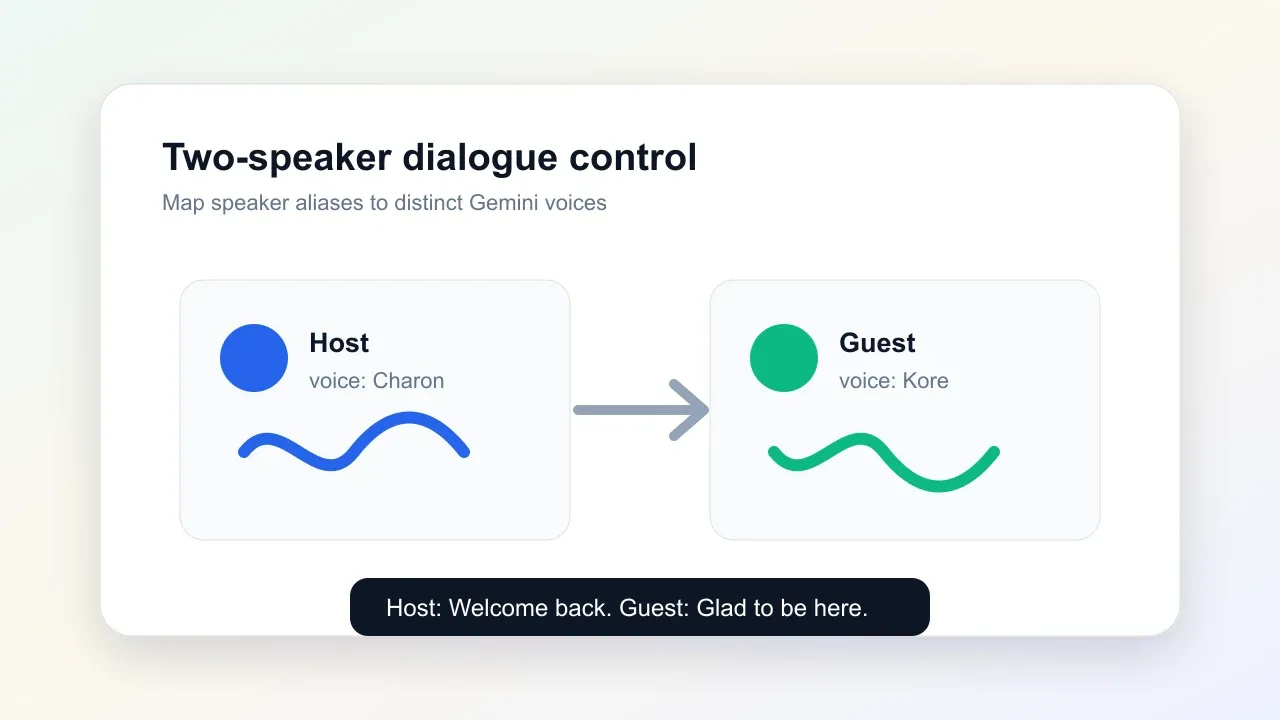
Asigne exactamente dos alias de orador a diferentes voces Gemini para audio conversacional. Prefije líneas en el texto con ID de orador y luego asigne a cada orador una voz distinta en la request API.
  • Cree segmentos de podcasts para anfitriones e invitados.
  • Prototipo de diálogo de personajes y conversaciones de asistentes.
  • Configure alias y voces de oradores para cada rol de diálogo.
Gemini 3.1 Flash TTS diálogo de dos altavoces

Lo que puedes construir

01

Podcasts y narración

Genere lecturas expresivas del presentador, segmentos de introducción, narraciones de audiolibros y audio editorial con entrega guiada.

02

Contenido de aprendizaje

Convierta guiones de cursos, lecciones de incorporación y material de capacitación en audio hablado multilingüe claro.

03

Diálogo de personajes

Prototipos de líneas de juego, flujos de juegos de rol, escenas de historias y conversaciones two-speaker con voces distintas.

04

Voz del producto localizado

Cree entradas de texto para aplicaciones, mensajes de soporte, demostraciones de productos y discursos de accesibilidad en varios idiomas.

Gemini 3.1 Flash TTS Precios: PoYo vs fal.ai

PoYo expone Gemini 3.1 Flash TTS a través del mismo flujo de trabajo de generación asíncrona utilizado en todos los modelos de audio PoYo, con precios claros frente a un precio de referencia público.
FunciónPoYoFal.ai
Público model IDgemini-3-1-flash-ttsNo expuesto
Fal.ai$0.12 por caracteres 1000$0.15 por caracteres 1000
Créditos PoYoCréditos 24 por caracteres 1000N/A
Controles centralestexto, instrucciones de estilo, voz, código de idioma, parlantes, temperatura, formato de salidaEntrada de texto con controles de estilo, voz, idioma, altavoz, temperatura y formato
WorkflowEnviar tarea, sondear el estado estándar, descargar archivos de audioFlujo de trabajo de la cola de referencia

El precio de PoYo utiliza créditos 24 por caracteres 1000. Un crédito tiene el precio de $0.005.

Cómo utilizar Gemini 3.1 Flash TTS en PoYo

  1. Obtenga su clave API: Cree una cuenta PoYo y genere una clave API desde el panel. Obtenga la clave API ->
  2. Escriba el texto: Ingrese el texto del habla y agregue etiquetas de audio como [risas], [suspiro], [susurros] o [pausa corta] cuando necesite expresión entrega.
  3. Elija configuración de voz: Seleccione una voz Gemini, código_idioma opcional, instrucciones_estilo, temperatura, formato_salida o configure exactamente dos altavoces con id_altavoz y voice.
  4. Enviar y recuperar: Enviar a través de PoYo generar API, luego sondear el estado de la tarea estándar endpoint para salida de audio. Ver documentos de API ->

Gemini 3.1 Flash TTS FAQ

¿Qué es Gemini 3.1 Flash TTS?

Gemini 3.1 Flash TTS es el expresivo modelo text-to-speech de Google para generar audio multilingüe natural a partir de entradas de texto. Admite etiquetas de audio, dirección de estilo natural-language, ajustes preestablecidos de voz Gemini y diálogo two-speaker.

¿Qué debo poner en el campo de texto?

Pon las palabras que quieras que se pronuncien en el texto. También puede incluir etiquetas de audio en línea como [risas], [suspiro], [susurros] y [pausa corta]. Para la síntesis multi-speaker, prefije líneas con alias como Host: e Guest:.

¿Cómo funcionan las instrucciones de estilo?

Utilice instrucciones de estilo para la dirección de entrega que debe aplicarse a toda la request, como noticiero dramático, cálido y lento, acento británico, tono alegre o susurro misterioso.

¿Gemini 3.1 Flash TTS admite etiquetas de audio?

Sí. Las etiquetas de audio son una fortaleza central del modelo y ayudan a controlar las emociones, las pausas, las risas, los susurros, el ritmo y otros detalles de la entrega directamente dentro del guión.

¿Qué voces e idiomas son compatibles?

El API expone ajustes preestablecidos de voz 30 Gemini como Kore, Puck, Charon, Zephyr y Aoede. El modelo admite síntesis multilingüe en los idiomas 70+, con dirección opcional de código de idioma.

¿Puedo crear un diálogo multi-speaker?

Sí. Envíe exactamente dos oradores, cada uno con un ID de altavoz y una voz. Utilice los mismos prefijos de Speaker_id en el texto para que el modelo pueda enrutar cada línea a la voz deseada. Cuando se configuran los altavoces, se ignora la voz top-level.

¿Qué formatos de salida puedo solicitar?

PoYo admite mp3, wav y ogg_opus para Gemini 3.1 Flash TTS. MP3 es el valor predeterminado y se recomienda cuando desea archivos compactos para reproducción web y de aplicaciones.

¿Cómo se calcula la facturación y cómo obtengo resultados?

PoYo factura créditos 24 por caracteres 1000, equivalentes a $0.12 por caracteres 1000. Envíe la request de generación, luego use el task_id devuelto con el estado de tarea estándar de PoYo, endpoint, para recuperar archivos de audio.

Por qué utilizar PoYo

01

Borrar precios de Per-Character

Utilice Gemini 3.1 Flash TTS a $0.12 por caracteres 1000 con facturación de crédito predecible.

02

Acceso al modelo unificado

Utilice la misma cuenta PoYo, facturación, sondeo de estado y flujo de trabajo de devolución de llamadas en modelos de texto, imagen, video y audio.

03

Flujo de trabajo de producción

Envíe trabajos asíncronos, sondee el estado estable de las tareas y recupere archivos de voz terminados desde una superficie API.

04

Controles expresivos

Exponga controles prácticos de producción para texto, estilo, voz, idioma, hablantes, temperatura y formato de salida.