
Poin utama
- Fable 5.2 cocok untuk pekerjaan tersulit; GPT-6.1 Sol cocok untuk pekerjaan bervolume tinggi. Pada Artificial Analysis Intelligence Index, Fable 5.2 meraih skor 65 dan GPT-6.1 Sol 55 pada effort maksimum, dan Sol menyelesaikan setiap tugas indeks dengan biaya yang jauh lebih kecil.
- Harga token resmi: $8 / $40 per juta token input/output untuk Fable 5.2 dan $2 / $10 untuk Sol pada konteks pendek, selisih 4×.
- Satu tarif tetap di PoYo. OpenAI menaikkan harga seluruh permintaan Sol menjadi $4 / $15 jika input melebihi 272K token. Di PoYo, GPT-6.1 Sol berharga $1.60 / $8 di seluruh jendela konteksnya, dan Fable 5.2 berharga $6.40 / $32 di seluruh jendela 1M-nya.
- Fable 5.2 mencurahkan lebih banyak penalaran ke setiap tugas. Artificial Analysis mengukur $26.54 per tugas indeks untuk Fable 5.2 pada effort maksimum dan $1.27 untuk Sol.
- Fable 5.2 mencapai skor tinggi dengan cepat. Pada effort
low, skornya 54, mendekati skor 55 milik Sol padamax, dan menyelesaikan satu tugas indeks dalam 5.8 menit dibandingkan 23.3 menit. - Mencari "GPT-5.6 Sol vs Fable 5"? Itu adalah duel Juli 2026. Kedua lini sudah berkembang; bagian di bawah membahas pasangan lama tersebut secara terpisah.
Sekilas Claude Fable 5.2 vs GPT-6.1 Sol
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Developer | Anthropic | OpenAI |
| ID model API | claude-fable-5-2 | gpt-6.1-sol |
| Dirilis | 9 November 2026 | 29 September 2026 |
| Posisi | Tingkatan teratas Anthropic, di atas Opus | Tingkatan Sol dari OpenAI, di antara GPT-6 Astra dan GPT-6 Luna |
| Jendela konteks | 1M token | 1.050.000 token (input maksimum 922.000) |
| Output maksimum | 128K token | 128K token |
| Input → output | Teks dan gambar → teks | Teks dan gambar → teks |
| Kontrol penalaran | output_config.effort | reasoning.effort |
| Tingkat effort | low hingga max, default high | low hingga max, default medium |
| Batas pengetahuan | Juni 2026 | 30 April 2026 |
| Input / output resmi (per 1M) | $8 / $40 | $2 / $10 (input ≤272K) $4 / $15 (input >272K) |
| Pembacaan cache resmi (per 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| Input / output PoYo (per 1M) | $6.40 / $32 | $1.60 / $8 |
| Endpoint PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs Fable 5: versi mana yang sedang Anda bandingkan?
Sebagian besar halaman yang muncul untuk pencarian "GPT-5.6 Sol vs Fable 5" ditulis pada Juli 2026, saat keduanya masih menjadi model terbaru. Sejak itu, setiap lini telah merilis versi yang lebih baru:
| Model | Developer | Dirilis | Input / output resmi saat peluncuran (per 1M, konteks pendek) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9 Juni 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9 Juli 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1 September 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22 September 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29 September 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9 November 2026 | $8 / $40 |
GPT-5.6 Sol vs Claude Fable 5: duel Juli 2026
Saat peluncuran, GPT-5.6 Sol berharga setengah dari Fable 5 untuk input dan 40% lebih murah untuk output ($5 / $30 vs $10 / $50, dengan input yang di-cache $0.50 vs $1). Pengujian independen pada bulan itu memberikan kesimpulan yang terbagi:
| Pengujian | Pengaturan | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: tiga rencana desain sistem | Kilo Code CLI, keduanya pada penalaran Max, dinilai dengan rubrik yang ditulis sebelumnya | Skor tertinggi pada ketiga tugas, setelah meninjau dan merevisi setiap rencananya sendiri; rata-rata 52 menit 53 detik per rencana; total $13.57 | Rencana yang menurut penguji paling mudah untuk dibangun; rata-rata 15 menit 27 detik per rencana; total $12.02 |
| Composio: Golden Eval, 47 alur kerja alat multi-aplikasi | Fable 5 di Claude Code; Sol di Codex CLI pada high | 45 dari 47 lolos (95.7%); rata-rata 223.779 token dan 79.6 detik per tugas | 47 dari 47 lolos (100%); rata-rata 276.957 token dan 84.4 detik per tugas |
| Analytics Vidhya: aplikasi web, analisis data, deck investor | Prompt yang sama, chat baru, penalaran default | Kualitas sebanding, dengan waktu eksekusi sekitar dua kali lipat | Kualitas sebanding dan eksekusi lebih cepat; pilihan penulis untuk pekerjaan panjang dan kompleks yang diserahkan sekaligus |
Pola pada bulan Juli: GPT-5.6 Sol cocok untuk perencanaan dan pemrograman dengan harga token yang lebih rendah serta meluangkan waktu ekstra untuk memeriksa pekerjaannya sendiri; Fable 5 cocok untuk alur kerja alat yang panjang dan menulis rencana yang mudah untuk dibangun.
Hasil tersebut menggambarkan model Juli, yang kini sudah menjadi generasi sebelumnya. Sejak itu, selisih harga semakin melebar ke arah keuntungan Sol: Fable 5.2 berharga 4× GPT-6.1 Sol per token, sedangkan Fable 5 berharga 2× GPT-5.6 Sol untuk input dan sekitar 1.7× untuk output. Bagian selanjutnya dari artikel ini membandingkan pasangan saat ini. Di PoYo, GPT-5.6 Sol tersedia melalui Responses API untuk integrasi yang sudah disesuaikan dengannya.
Kesamaan dan perbedaan kedua model
Kesamaan:
- Sekitar 1M token konteks dan 128K token output per permintaan.
- Input teks dan gambar, output teks.
- Lima tingkat effort, dari
lowhinggamax. Setiap vendor mengkalibrasi tingkatnya sendiri, jadi bandingkan hasilnya, bukan labelnya. - Prompt caching, streaming, dan structured output.
Perbedaan:
- Effort default. Default Fable 5.2 adalah
high; default Sol adalahmedium. Tetapkan effort secara eksplisit dalam pengujian berdampingan agar keduanya berjalan pada tingkat yang Anda inginkan. - Kontrol pemikiran. Fable 5.2 selalu berpikir secara adaptif dan menerima
tool_choiceberupaautoataunone. Sol dikonfigurasi melaluireasoning.effort, dan alat hosted-nya (pencarian web, pencarian file, code interpreter, hosted shell, apply patch, penggunaan komputer, MCP, pencarian alat) berjalan melalui Responses API milik OpenAI. - Batas pengetahuan. Juni 2026 untuk Fable 5.2; 30 April 2026 untuk Sol.
- Retensi data. Fable 5.2 berjalan dengan retensi data 30 hari di API Anthropic.
Harga: 4× per token, 2× pada prompt panjang
Tarif resmi (USD per 1M token)
| Biaya | Claude Fable 5.2 | GPT-6.1 Sol, input ≤272K | GPT-6.1 Sol, input >272K |
|---|---|---|---|
| Input | $8.00 | $2.00 | $4.00 |
| Output | $40.00 | $10.00 | $15.00 |
| Pembacaan cache | $0.20 | $0.10 | $0.20 |
| Penulisan cache | $10 (5 menit) / $16 (1 jam) | $2.50 (30 menit) / $5.00 (12 jam) | $5.00 (30 menit) / $10.00 (12 jam) |
OpenAI menghargai prompt dengan lebih dari 272K token input sebesar 2× tarif input dan cache serta 1.5× tarif output, untuk seluruh permintaan. Anthropic menagih seluruh jendela 1M Fable 5.2 dengan tarif standar. Di PoYo, kedua model menggunakan satu tarif di seluruh jendela konteksnya, sehingga GPT-6.1 Sol tetap $1.60 / $8 berapa pun panjang prompt-nya. Untuk harga setiap model Claude, lihat panduan harga Claude API kami.
Biaya per permintaan
Contoh berikut mengasumsikan kedua model menggunakan jumlah token yang sama; pemakaian nyata berbeda per model (lihat bagian berikutnya). Biaya penulisan cache tidak dimasukkan untuk keduanya.
| Skenario | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Balasan chat: 20K input + 4K output | Resmi: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Resmi: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Tugas pemrograman: 100K input + 10K output | Resmi: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Resmi: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Dokumen panjang: 500K input + 20K output | Resmi: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Resmi: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Sesi agen: 2M pembacaan cache + 300K input baru + 150K output, setiap permintaan di bawah 272K | Resmi: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Resmi: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
Pada prompt 500K token, tarif konteks panjang resmi Sol mempersempit selisih dari 4× menjadi sekitar 2.1×. Di PoYo, permintaan yang sama berbiaya $0.96 di GPT-6.1 Sol, karena PoYo menagih Sol dengan satu tarif tanpa pengali konteks panjang.
Biaya per tugas yang selesai
Harga token hanyalah separuh dari tagihan. Artificial Analysis menjalankan kedua model pada tugas Intelligence Index yang sama dan memublikasikan biayanya:
| Effort maksimum | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Biaya per tugas indeks | $26.54 | $1.27 |
| Waktu per tugas indeks | 45.3 menit | 23.3 menit |
| Skor indeks | 65 | 55 |
Selisih biayanya sekitar 21×, dibandingkan selisih harga 4×: Fable 5.2 mencurahkan jauh lebih banyak penalaran ke setiap tugas, dan dari situlah skor tingginya berasal, sementara Sol menyelesaikan tugas dengan token yang jauh lebih sedikit. Pada beban kerja nyata, bandingkan total tagihan per tugas yang diterima bersama dengan tarif tokennya.
Benchmark
Pengaturan yang sama: Artificial Analysis Intelligence Index
Artificial Analysis mengevaluasi kedua model dengan tugas dan harness yang sama, sehingga angkanya dapat dibandingkan secara langsung. Intelligence Index v5.0.1, dibaca pada 14 November 2026:
| Effort | Skor Fable 5.2 | Skor GPT-6.1 Sol | Waktu Fable 5.2 per tugas | Waktu Sol per tugas |
|---|---|---|---|---|
low | 54 | 35 | 5.8 menit | 2.0 menit |
medium | 56 | 46 | 7.7 menit | 4.6 menit |
high | 62 | 50 | 16.2 menit | 7.9 menit |
xhigh | 62 | 52 | 27.9 menit | 10.7 menit |
max | 65 | 55 | 45.3 menit | 23.3 menit |
Cara membacanya:
- Fable 5.2 mencetak skor lebih tinggi di setiap tingkat, dengan selisih 10 hingga 19 poin, cocok untuk pekerjaan yang paling mengutamakan kualitas jawaban.
- Fable 5.2 pada
lowmendekati skor Sol padamax(54 vs 55) dalam seperempat waktunya. - Sol menghasilkan skornya dengan biaya rendah: $1.27 per tugas indeks pada effort maksimum, cocok untuk pekerjaan bervolume tinggi dan yang sensitif terhadap anggaran.
- Fable menghasilkan token lebih cepat: sekitar 94–102 token output per detik dibandingkan 47–49 untuk Sol.
- Artificial Analysis memberi label "Default Fallback" pada pengujian Fable 5.2-nya, yang berarti fallback penolakan dari Anthropic diaktifkan selama pengujian.
Hasil peluncuran Anthropic
Tabel Fable 5.2 dari Anthropic membandingkannya dengan GPT-6 Astra, tingkatan teratas OpenAI. Setiap model berjalan pada effort tertinggi yang tersedia, kecuali disebutkan lain:
| Benchmark | Yang diukur | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Pemrograman agentik | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Rekayasa perangkat lunak | 69.9% | 65.5% |
| AutomationBench | Alur kerja bisnis | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Sains agentik | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Penggunaan komputer | 89.3% | 79.5% |
| Remote Labor Index | Tugas berbayar nyata | 41.3% (high) | 20.8% |
| Humanity's Last Exam (dengan alat) | Penalaran sulit | 74.2% | 57.2% |
| Chartography (tanpa alat) | Penalaran grafik | 73.4% | 71.0% |

Skor FrontierCode 2.0 terhadap biaya per tugas di setiap tingkat effort. Grafik dari materi peluncuran Claude Fable 5.2 milik Anthropic.
Hasil peluncuran OpenAI
OpenAI meluncurkan GPT-6.1 Sol pada 29 September 2026, enam minggu sebelum Fable 5.2, dan membandingkannya dengan model GPT-6 miliknya sendiri. OpenAI memosisikannya untuk pemrograman kompleks, penggunaan komputer, dan pekerjaan profesional, dengan kemampuan yang mendekati GPT-6 Astra pada seperlima harga token Astra ($2 / $10 dibandingkan $10 / $50). Evaluasi peluncurannya mencakup rekayasa perangkat lunak, pemahaman dokumen, otomatisasi bisnis, dan penggunaan komputer.
Setiap vendor menjalankan benchmark dengan harness dan versi pengujiannya sendiri, jadi bandingkan skor di dalam tabel satu vendor, dan gunakan indeks Artificial Analysis di atas untuk perbandingan langsung.
Mana yang sebaiknya Anda pilih?
| Beban kerja Anda | Mulai dengan | Alasan |
|---|---|---|
| Chat, ekstraksi, dan routing bervolume tinggi | GPT-6.1 Sol pada medium (atau model yang lebih kecil) | Menangani tugas singkat dengan seperempat harga token Fable |
| Pemrograman sehari-hari dan loop agen dengan anggaran terbatas | GPT-6.1 Sol | Dibangun untuk pemrograman dan pekerjaan agen, dengan harga resmi $2 / $10 dan $1.60 / $8 di PoYo |
| Penalaran tersulit, riset, eksekusi otonom yang panjang | Fable 5.2 | 65 vs 55 pada Intelligence Index; unggul atas GPT-6 Astra di seluruh tabel Anthropic |
| Masalah sulit yang mahal jika harus menunggu | Fable 5.2 pada low atau medium | Skornya mendekati skor maksimum Sol dalam seperempat waktunya |
| Penggunaan komputer, grafik, dokumen visual yang padat | Fable 5.2 | 89.3% pada OSWorld 2.1 dan 73.4% pada Chartography dalam tabel Anthropic |
| Prompt yang rutin melebihi 272K token | GPT-6.1 Sol di PoYo untuk biaya, Fable 5.2 untuk kedalaman | Di PoYo, keduanya mempertahankan satu tarif di seluruh jendela: $1.60 / $8 untuk Sol, $6.40 / $32 untuk Fable |
| Dibangun di atas alat hosted OpenAI (shell, pencarian web, MCP) | GPT-6.1 Sol | Alat-alat tersebut berjalan secara native melalui Responses API |
| Butuh kualitas Claude dengan harga lebih rendah | Claude Opus 5.5 | $4 / $20; lihat Claude Fable 5.2 vs Opus 5.5 |
Eksekusi otonom yang panjang cocok untuk Fable 5.2: agen-agennya membangun prototipe sistem operasi ini, yang terlihat berjalan di sebuah laptop. Video dari materi peluncuran Claude Fable 5.2 milik Anthropic.
Pengaturan routing yang praktis: kirim trafik rutin ke GPT-6.1 Sol pada medium, catat jenis tugas mana yang mendapat manfaat dari penalaran yang lebih dalam, lalu arahkan jenis tugas tersebut ke Fable 5.2 pada medium. Setelah seminggu, bandingkan biaya per tugas yang diterima, alih-alih harga token. Untuk opsi Claude kelas menengah dibandingkan Sol, lihat GPT-6.1 Sol vs Claude Opus 5.5.
Gunakan keduanya di PoYo
PoYo memudahkan Anda menjalankan keduanya:
- Satu API key untuk Fable 5.2, GPT-6.1 Sol, serta semua model chat, gambar, video, dan audio lainnya.
- Bayar sesuai pemakaian, ditagih per token dalam bentuk kredit, tanpa langganan.
- Kedua format API: Anthropic Messages serta OpenAI Chat Completions dan Responses.
- Satu tarif per model di seluruh jendela konteks, 20% di bawah tarif konteks pendek resmi masing-masing:
| Biaya (per 1M token) | Claude Fable 5.2 di PoYo | GPT-6.1 Sol di PoYo |
|---|---|---|
| Input | $6.40 | $1.60 |
| Output | $32.00 | $8.00 |
| Pembacaan cache | $0.16 | $0.08 |
| Penulisan cache | $8.00 (5 menit) / $12.80 (1 jam) | $2.00 |
Fable 5.2 melalui format Anthropic Messages:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Tinjau diff ini untuk mencari bug konkurensi: ..."}]
  }'
GPT-6.1 Sol melalui Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Tinjau diff ini untuk mencari bug konkurensi: ..."
  }'
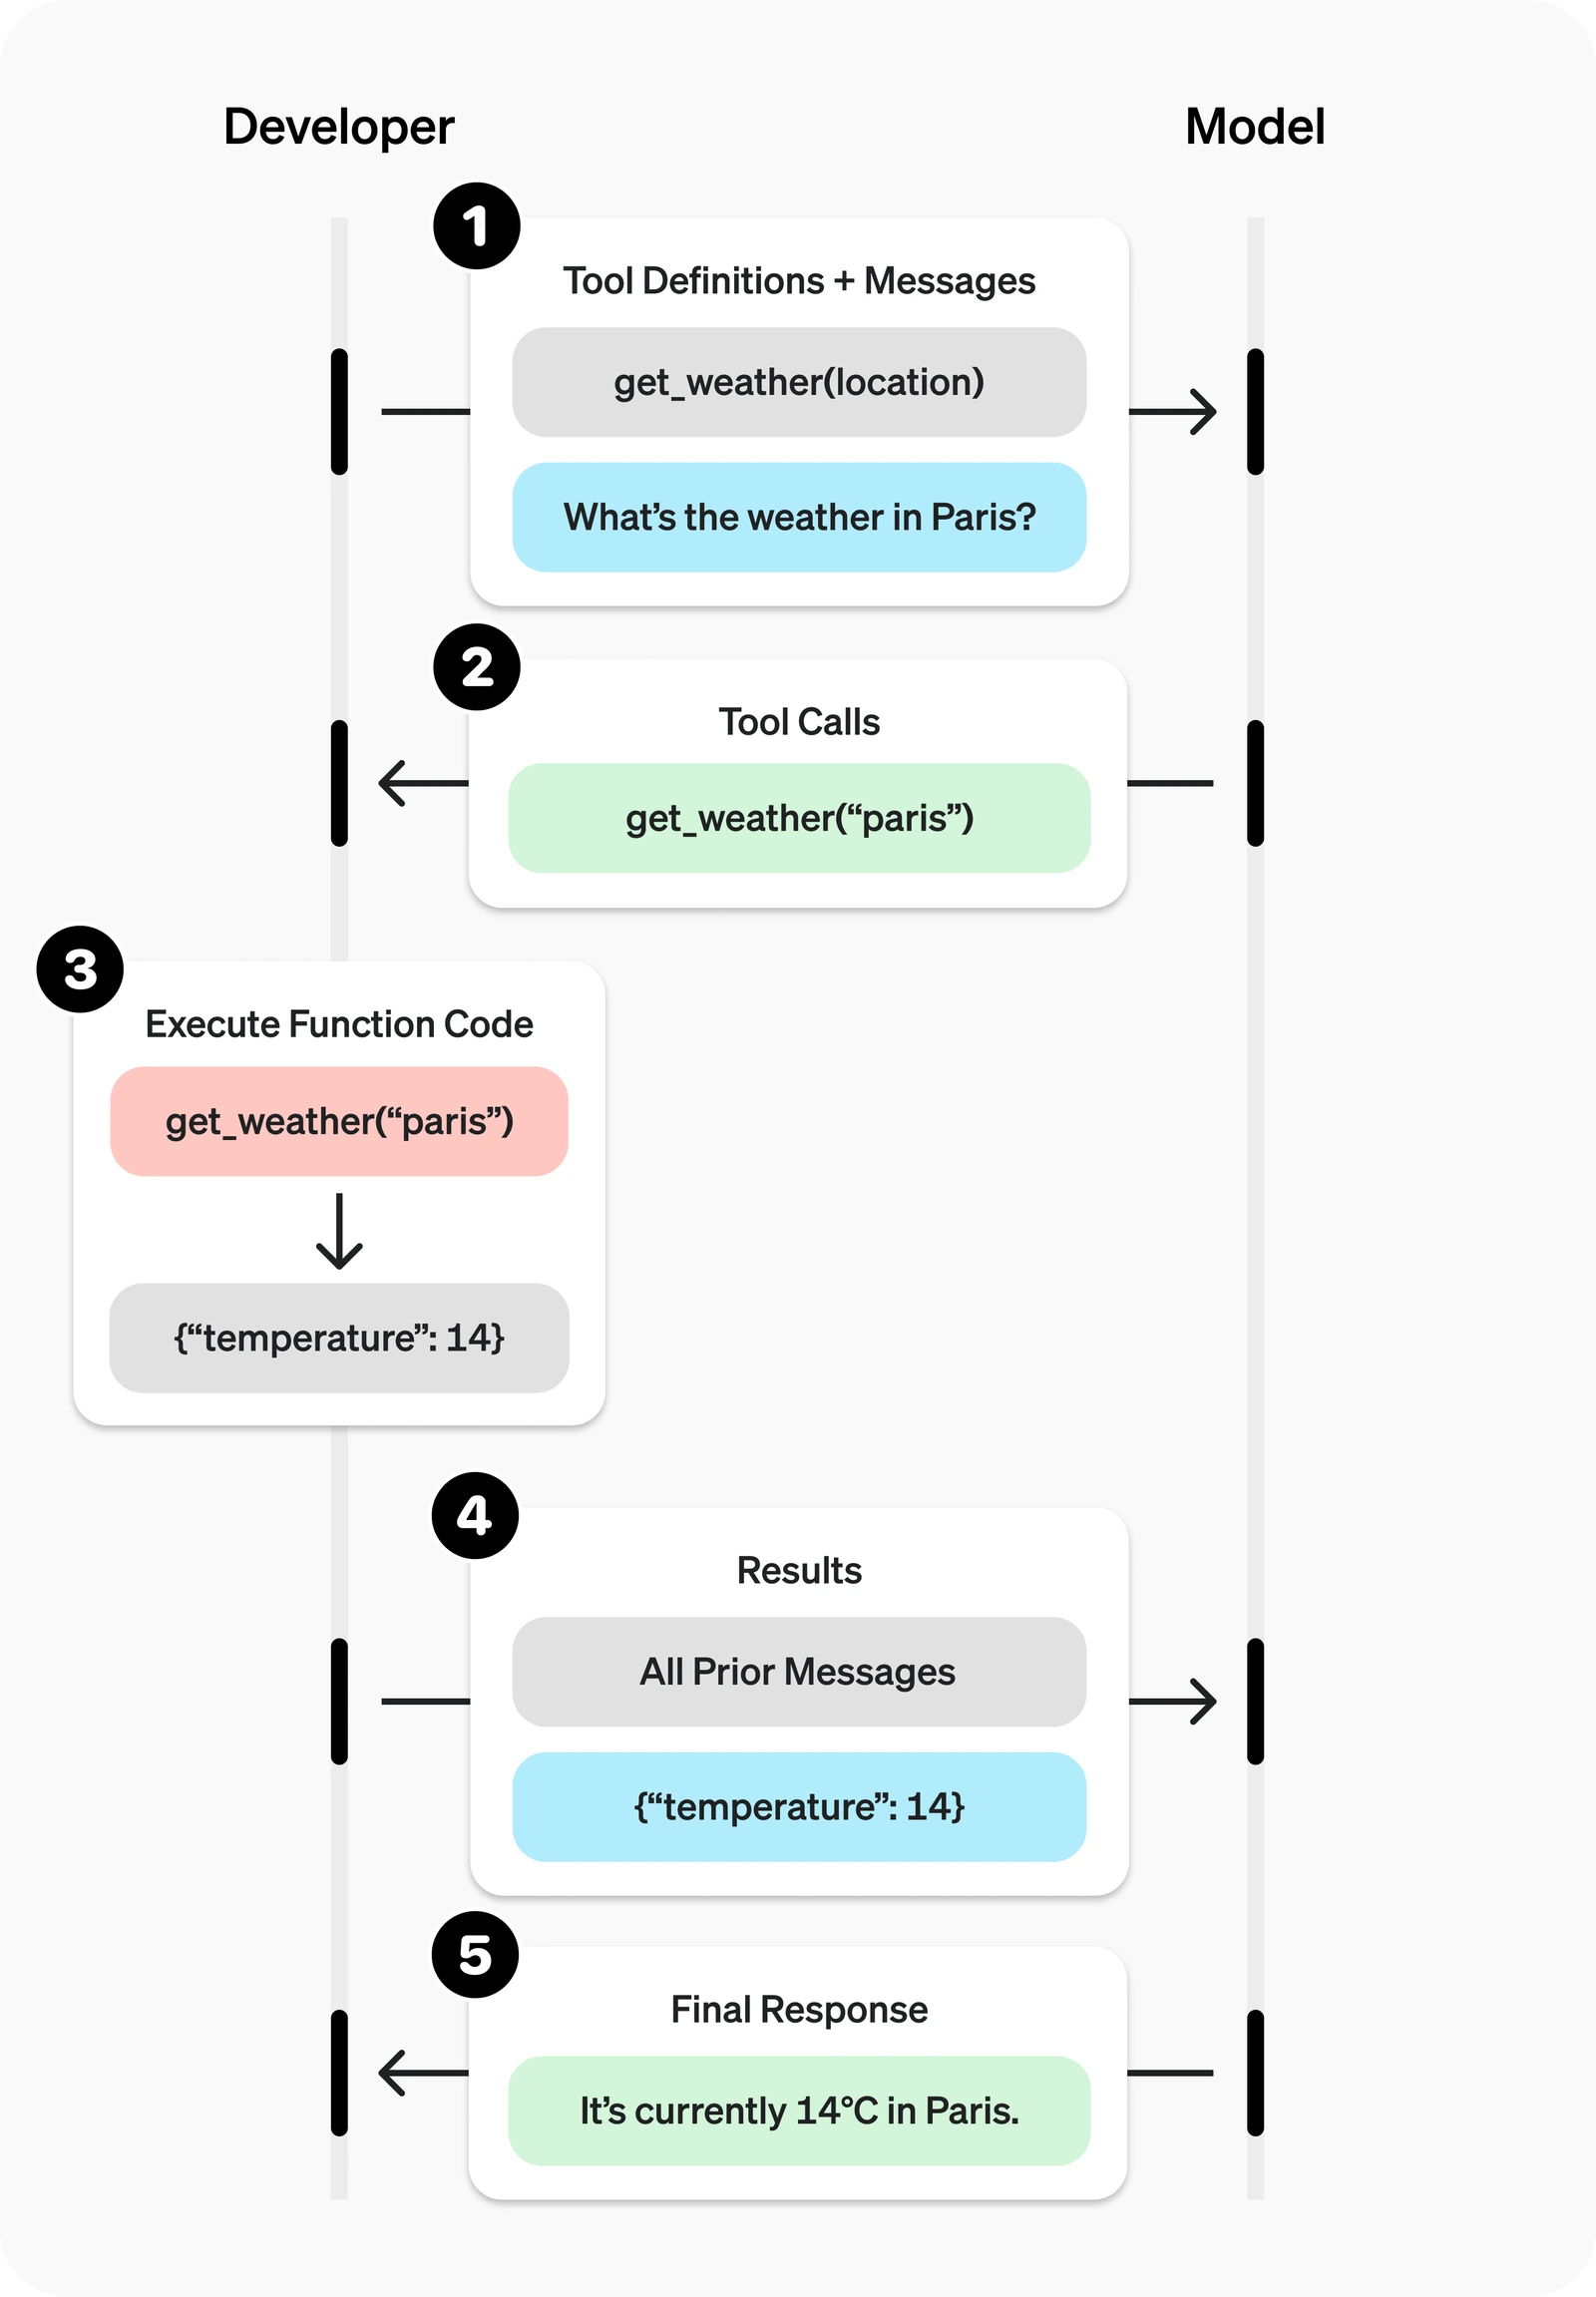
Loop function calling yang digunakan GPT-6.1 Sol untuk pekerjaan dengan alat. Diagram dari dokumentasi resmi OpenAI.
Untuk menguji A/B keduanya pada satu jalur kode, kirim claude-fable-5-2 dan gpt-6.1-sol ke /v1/chat/completions dan ubah hanya field model. Untuk setup SDK, effort, dan caching pada Fable, lihat panduan Claude Fable 5.2 API kami; untuk batas dan alat Sol, lihat panduan fitur GPT-6.1 Sol.
Halaman model: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
FAQ
Apakah Fable 5 lebih baik daripada GPT-5.6 Sol?
Masing-masing cocok untuk pekerjaan yang berbeda. Dalam pengujian Juli 2026, Fable 5 lolos pada ke-47 alur kerja alat multi-aplikasi dari Composio (GPT-5.6 Sol lolos 45), sedangkan GPT-5.6 Sol meraih skor tertinggi pada ketiga tugas perencanaan desain sistem dari Kilo dengan harga token yang lebih rendah. Pada generasi saat ini, Fable 5.2 meraih skor 65 dan GPT-6.1 Sol 55 pada Artificial Analysis Intelligence Index, dengan biaya per tugas Sol yang jauh lebih kecil.
Apakah GPT Astra akan lebih baik daripada Fable?
GPT-6 Astra sudah tersedia, dengan harga $10 / $50 per juta token. Dalam tabel peluncuran Fable 5.2 dari Anthropic, Fable 5.2 mencetak skor lebih tinggi daripada GPT-6 Astra pada setiap benchmark yang diuji pada keduanya, misalnya 74.6% vs 68.1% pada Terminal-Bench-Science 0.1 dan 89.3% vs 79.5% pada OSWorld 2.1. Ini adalah pengujian Anthropic sendiri; uji keduanya pada tugas Anda sebelum memutuskan.
Apakah GPT-5.6 Luna lebih baik?
Luna adalah tingkatan GPT-5.6 yang paling kecil dan paling terjangkau, dibangun untuk pekerjaan cepat bervolume tinggi, sedangkan Sol cocok untuk tugas yang lebih sulit. Pilih Luna untuk throughput dan biaya, Sol untuk kedalaman. Pada generasi saat ini, harga daftar GPT-6 Luna adalah $0.10 / $0.50 per juta token.
Apakah GPT-5.6 Sol layak digunakan?
GPT-5.6 Sol adalah generasi sebelumnya. Untuk proyek baru, GPT-6.1 Sol adalah model Sol terbaru dari OpenAI, dengan harga $2 / $10 per juta token pada konteks pendek, atau $1.60 / $8 di PoYo di seluruh jendela konteksnya. GPT-5.6 Sol tetap cocok untuk integrasi yang sudah disesuaikan dengannya.
Apakah Claude Fable 5.2 lebih baik daripada GPT-6.1 Sol?
Untuk kemampuan maksimum, Fable 5.2 adalah pilihannya: skornya 10 hingga 19 poin lebih tinggi di setiap tingkat effort pada Artificial Analysis Intelligence Index. Untuk biaya, GPT-6.1 Sol adalah pilihannya: harganya seperempat per token dan, pada effort maksimum, sekitar seperdua puluh per tugas indeks.
Mana yang lebih murah, Fable 5.2 atau GPT-6.1 Sol?
GPT-6.1 Sol. Harga resminya $2 / $10 per juta token input/output dibandingkan $8 / $40 untuk Fable 5.2. Di atas 272K token input, OpenAI menaikkan harga Sol menjadi $4 / $15 untuk seluruh permintaan, sementara Fable tetap $8 / $40. Di PoYo, Sol tetap $1.60 / $8 berapa pun panjang prompt-nya.
Mana yang lebih baik untuk pemrograman?
Kedua vendor melaporkan hasil pemrograman pada benchmark yang berbeda. Anthropic melaporkan Fable 5.2 meraih 49.1% pada FrontierCode 2.0, di atas GPT-6 Astra, dan OpenAI membangun GPT-6.1 Sol untuk pemrograman kompleks dengan seperlima harga token Astra. Default yang masuk akal adalah Sol untuk pemrograman rutin dalam volume besar dan Fable 5.2 untuk perubahan besar yang berjalan lama. Jalankan keduanya pada sampel tiket Anda sendiri.
Apakah kedua model memiliki jendela konteks 1M?
Ya, kurang lebih. Fable 5.2 memiliki jendela 1M token. GPT-6.1 Sol memiliki jendela 1.050.000 token dengan input hingga 922.000 token. Keduanya menulis hingga 128K token output per permintaan.