
In sintesi
- Fable 5.2 è adatto al lavoro più difficile; GPT-6.1 Sol al lavoro ad alto volume. Nell’Artificial Analysis Intelligence Index, all’impegno massimo, Fable 5.2 ottiene 65 punti e GPT-6.1 Sol 55, e Sol completa ogni attività dell’indice a una frazione del costo.
- Prezzi ufficiali per token: $8 / $40 per milione di token di input/output per Fable 5.2 e $2 / $10 per Sol con contesto breve, una differenza di 4×.
- Un’unica tariffa su PoYo. OpenAI porta l’intera richiesta di Sol a $4 / $15 oltre i 272K token di input. Su PoYo, GPT-6.1 Sol costa $1.60 / $8 su tutta la finestra di contesto e Fable 5.2 costa $6.40 / $32 su tutta la finestra da 1M.
- Fable 5.2 dedica più ragionamento a ogni attività. Artificial Analysis ha misurato $26.54 per attività dell’indice per Fable 5.2 all’impegno massimo e $1.27 per Sol.
- Fable 5.2 raggiunge in fretta punteggi elevati. Con impegno
lowottiene 54, vicino ai 55 di Sol amax, e completa un’attività dell’indice in 5.8 minuti contro 23.3. - Cerchi «GPT-5.6 Sol vs Fable 5»? Quella era la sfida di luglio 2026. Da allora entrambe le linee sono andate avanti; la sezione qui sotto tratta la vecchia coppia a parte.
Claude Fable 5.2 e GPT-6.1 Sol in breve
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Sviluppatore | Anthropic | OpenAI |
| ID del modello nell’API | claude-fable-5-2 | gpt-6.1-sol |
| Rilascio | 9 novembre 2026 | 29 settembre 2026 |
| Posizionamento | Fascia alta di Anthropic, sopra Opus | Fascia Sol di OpenAI, tra GPT-6 Astra e GPT-6 Luna |
| Finestra di contesto | 1M token | 1.050.000 token (input massimo 922.000) |
| Output massimo | 128K token | 128K token |
| Input → output | Testo e immagini → testo | Testo e immagini → testo |
| Controllo del ragionamento | output_config.effort | reasoning.effort |
| Livelli di impegno | Da low a max, predefinito high | Da low a max, predefinito medium |
| Limite delle conoscenze | Giugno 2026 | 30 aprile 2026 |
| Input / output ufficiale (per 1M) | $8 / $40 | $2 / $10 (input ≤272K) $4 / $15 (input >272K) |
| Lettura dalla cache ufficiale (per 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| Input / output su PoYo (per 1M) | $6.40 / $32 | $1.60 / $8 |
| Endpoint di PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs Fable 5: quali versioni stai confrontando?
Quasi tutte le pagine che si posizionano per «GPT-5.6 Sol vs Fable 5» sono state scritte nel luglio 2026, quando quei due erano i modelli più recenti. Da allora ciascuna linea ha pubblicato nuove versioni:
| Modello | Sviluppatore | Rilascio | Input / output ufficiale al lancio (per 1M, contesto breve) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9 giugno 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9 luglio 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1° settembre 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22 settembre 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29 settembre 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9 novembre 2026 | $8 / $40 |
GPT-5.6 Sol vs Claude Fable 5: la sfida di luglio 2026
Al lancio, GPT-5.6 Sol costava la metà di Fable 5 sull’input e il 40% in meno sull’output ($5 / $30 contro $10 / $50, con l’input in cache a $0.50 contro $1). I test indipendenti di quel mese hanno dato un verdetto diviso:
| Test | Configurazione | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: tre piani di progettazione di sistemi | Kilo Code CLI, entrambi con ragionamento Max, valutati con una griglia scritta in anticipo | Punteggio più alto in tutte e tre le attività, dopo aver rivisto e corretto da solo ogni piano; in media 52 min 53 s per piano; $13.57 in totale | Piani che i tester hanno trovato più facili da realizzare; in media 15 min 27 s per piano; $12.02 in totale |
| Composio: Golden Eval, 47 flussi di lavoro con strumenti su più app | Fable 5 in Claude Code; Sol in Codex CLI a high | 45 su 47 superati (95.7%); in media 223.779 token e 79.6 s per attività | 47 su 47 superati (100%); in media 276.957 token e 84.4 s per attività |
| Analytics Vidhya: app web, analisi dei dati, presentazione per investitori | Stessi prompt, chat nuove, ragionamento predefinito | Qualità paragonabile, con un tempo di esecuzione circa doppio | Qualità paragonabile ed esecuzioni più rapide; la scelta dell’autore per il lavoro lungo e complesso da affidare in un colpo solo |
La tendenza di luglio: GPT-5.6 Sol era adatto alla pianificazione e alla programmazione a un prezzo per token più basso e dedicava più tempo a verificare il proprio lavoro; Fable 5 era adatto ai lunghi flussi di lavoro con strumenti e scriveva piani facili da realizzare.
Questi risultati descrivono i modelli di luglio, che oggi sono la generazione precedente. Da allora il divario di prezzo si è allargato a favore di Sol: Fable 5.2 costa 4× GPT-6.1 Sol per token, mentre Fable 5 costava 2× GPT-5.6 Sol sull’input e circa 1.7× sull’output. Il resto dell’articolo confronta la coppia attuale. Su PoYo, GPT-5.6 Sol è disponibile tramite la Responses API per le integrazioni già ottimizzate su questo modello.
Cosa hanno in comune i due modelli e dove si differenziano
In comune:
- Circa 1M token di contesto e 128K token di output per richiesta.
- Input di testo e immagini, output di testo.
- Cinque livelli di impegno, da
lowamax. Ogni fornitore calibra i propri livelli, quindi confronta i risultati e non le etichette. - Caching dei prompt, streaming e output strutturati.
Differenze:
- Impegno predefinito. Fable 5.2 usa
highper impostazione predefinita; Sol usamedium. Nei test affiancati imposta l’impegno in modo esplicito, così entrambi lavorano al livello che desideri. - Controlli del ragionamento. Fable 5.2 ragiona sempre in modo adattivo e accetta per
tool_choicei valoriautoonone. Sol si configura tramitereasoning.effort, e i suoi strumenti ospitati (ricerca web, ricerca nei file, interprete di codice, shell ospitata, applicazione di patch, uso del computer, MCP, ricerca degli strumenti) funzionano tramite la Responses API di OpenAI. - Limite delle conoscenze. Giugno 2026 per Fable 5.2; 30 aprile 2026 per Sol.
- Conservazione dei dati. Sull’API di Anthropic, Fable 5.2 applica la conservazione dei dati per 30 giorni.
Prezzi: 4× per token, 2× sui prompt lunghi
Tariffe ufficiali (USD per 1M di token)
| Voce di costo | Claude Fable 5.2 | GPT-6.1 Sol, input ≤272K | GPT-6.1 Sol, input >272K |
|---|---|---|---|
| Input | $8.00 | $2.00 | $4.00 |
| Output | $40.00 | $10.00 | $15.00 |
| Lettura dalla cache | $0.20 | $0.10 | $0.20 |
| Scrittura in cache | $10 (5 min) / $16 (1 ora) | $2.50 (30 min) / $5.00 (12 ore) | $5.00 (30 min) / $10.00 (12 ore) |
OpenAI applica ai prompt con più di 272K token di input 2× le tariffe di input e di cache e 1.5× la tariffa di output, sull’intera richiesta. Anthropic fattura l’intera finestra da 1M di Fable 5.2 a tariffe standard. Su PoYo entrambi i modelli usano un’unica tariffa su tutta la finestra di contesto, quindi GPT-6.1 Sol resta a $1.60 / $8 qualunque sia la lunghezza del prompt. Per i prezzi di tutti i modelli Claude, consulta la nostra guida ai prezzi di Claude API.
Costo per richiesta
Questi esempi presuppongono che i due modelli usino lo stesso numero di token; nella pratica il consumo varia da modello a modello (vedi la sezione successiva). I costi di scrittura in cache sono esclusi per entrambi.
| Scenario | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Risposta in chat: 20K di input + 4K di output | Ufficiale: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Ufficiale: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Attività di programmazione: 100K di input + 10K di output | Ufficiale: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Ufficiale: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Documento lungo: 500K di input + 20K di output | Ufficiale: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Ufficiale: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Sessione di un agente: 2M di letture dalla cache + 300K di nuovo input + 150K di output, ogni richiesta sotto i 272K | Ufficiale: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Ufficiale: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
Su un prompt da 500K token, la tariffa ufficiale di Sol per il contesto lungo riduce il divario da 4× a circa 2.1×. Su PoYo la stessa richiesta costa $0.96 con GPT-6.1 Sol, perché PoYo fattura Sol con un’unica tariffa, senza moltiplicatore per il contesto lungo.
Costo per attività completata
Il prezzo dei token è solo metà della fattura. Artificial Analysis sottopone entrambi i modelli alle stesse attività dell’Intelligence Index e ne pubblica il costo:
| Impegno massimo | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Costo per attività dell’indice | $26.54 | $1.27 |
| Tempo per attività dell’indice | 45.3 min | 23.3 min |
| Punteggio dell’indice | 65 | 55 |
Il divario di costo è di circa 21×, a fronte di un divario di prezzo di 4×: Fable 5.2 dedica molto più ragionamento a ogni attività, ed è da lì che vengono i suoi punteggi più alti, mentre Sol porta a termine le attività con molti meno token. Sui carichi di lavoro reali, confronta la fattura totale per attività accettata insieme alla tariffa per token.
Benchmark
Stessa configurazione: Artificial Analysis Intelligence Index
Artificial Analysis valuta entrambi i modelli con le stesse attività e lo stesso ambiente di test, quindi i suoi numeri sono direttamente confrontabili. Intelligence Index v5.0.1, consultato il 14 novembre 2026:
| Impegno | Punteggio Fable 5.2 | Punteggio GPT-6.1 Sol | Tempo per attività Fable 5.2 | Tempo per attività Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 min | 2.0 min |
medium | 56 | 46 | 7.7 min | 4.6 min |
high | 62 | 50 | 16.2 min | 7.9 min |
xhigh | 62 | 52 | 27.9 min | 10.7 min |
max | 65 | 55 | 45.3 min | 23.3 min |
Come leggere la tabella:
- Fable 5.2 ottiene punteggi più alti a ogni livello, con 10–19 punti di vantaggio: è adatto al lavoro in cui la qualità della risposta conta di più.
- Fable 5.2 a
lowsi avvicina a Sol amax(54 contro 55) in un quarto del tempo. - Sol offre i suoi punteggi a basso costo: $1.27 per attività dell’indice all’impegno massimo, ideale per il lavoro ad alto volume e attento al budget.
- Fable genera token più velocemente: circa 94–102 token di output al secondo contro 47–49 di Sol.
- Artificial Analysis etichetta le sue esecuzioni di Fable 5.2 come «Default Fallback», il che significa che durante i test era attivo il fallback di Anthropic per i rifiuti.
I risultati di lancio di Anthropic
La tabella di Anthropic per Fable 5.2 lo confronta con GPT-6 Astra, la fascia alta di OpenAI. Ogni modello è stato eseguito al massimo livello di impegno disponibile, salvo diversa indicazione:
| Benchmark | Cosa misura | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Programmazione agentica | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Ingegneria del software | 69.9% | 65.5% |
| AutomationBench | Flussi di lavoro aziendali | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Scienza agentica | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Uso del computer | 89.3% | 79.5% |
| Remote Labor Index | Incarichi reali retribuiti | 41.3% (high) | 20.8% |
| Humanity's Last Exam (con strumenti) | Ragionamento complesso | 74.2% | 57.2% |
| Chartography (senza strumenti) | Ragionamento sui grafici | 73.4% | 71.0% |

Punteggio su FrontierCode 2.0 in rapporto al costo per attività a ogni livello di impegno. Grafico dai materiali di lancio di Claude Fable 5.2 pubblicati da Anthropic.
I risultati di lancio di OpenAI
OpenAI ha lanciato GPT-6.1 Sol il 29 settembre 2026, sei settimane prima di Fable 5.2, e lo ha confrontato con i propri modelli GPT-6. OpenAI lo presenta come modello per la programmazione complessa, l’uso del computer e il lavoro professionale, con capacità vicine a GPT-6 Astra a un quinto del prezzo per token di Astra ($2 / $10 contro $10 / $50). Le valutazioni di lancio coprono ingegneria del software, comprensione dei documenti, automazione aziendale e uso del computer.
Ogni fornitore esegue i benchmark con il proprio ambiente di test e la propria versione dei test: confronta quindi i punteggi all’interno della tabella di uno stesso fornitore e usa l’indice di Artificial Analysis qui sopra per un confronto diretto.
Quale scegliere?
| Il tuo carico di lavoro | Inizia con | Perché |
|---|---|---|
| Chat, estrazione e instradamento ad alto volume | GPT-6.1 Sol a medium (o un modello più piccolo) | Gestisce le attività brevi a un quarto del prezzo per token di Fable |
| Programmazione quotidiana e cicli di agenti con budget limitato | GPT-6.1 Sol | Pensato per la programmazione e il lavoro con agenti, a $2 / $10 ufficiali e $1.60 / $8 su PoYo |
| Ragionamento più complesso, ricerca, lunghe esecuzioni autonome | Fable 5.2 | 65 contro 55 sull’Intelligence Index; supera GPT-6 Astra in tutta la tabella di Anthropic |
| Problemi difficili in cui l’attesa costa cara | Fable 5.2 a low o medium | Si avvicina al punteggio massimo di Sol in un quarto del tempo |
| Uso del computer, grafici, documenti visivamente densi | Fable 5.2 | 89.3% su OSWorld 2.1 e 73.4% su Chartography nella tabella di Anthropic |
| Prompt che superano spesso i 272K token | GPT-6.1 Sol su PoYo per il costo, Fable 5.2 per la profondità | Su PoYo entrambi mantengono un’unica tariffa su tutta la finestra: $1.60 / $8 per Sol, $6.40 / $32 per Fable |
| Basato sugli strumenti ospitati di OpenAI (shell, ricerca web, MCP) | GPT-6.1 Sol | Questi strumenti funzionano in modo nativo tramite la Responses API |
| Qualità Claude a un prezzo più basso | Claude Opus 5.5 | $4 / $20; leggi Claude Fable 5.2 e Opus 5.5 a confronto |
Le lunghe esecuzioni autonome sono il terreno di Fable 5.2: i suoi agenti hanno creato questo prototipo di sistema operativo, qui in esecuzione su un portatile. Video dai materiali di lancio di Claude Fable 5.2 pubblicati da Anthropic.
Un instradamento pratico: invia il traffico di routine a GPT-6.1 Sol a medium, annota quali tipi di attività traggono vantaggio da un ragionamento più profondo e indirizzali a Fable 5.2 a medium. Dopo una settimana, confronta il costo per attività accettata invece dei prezzi dei token. Per l’opzione Claude di fascia media contro Sol, leggi GPT-6.1 Sol e Claude Opus 5.5 a confronto.
Usa entrambi su PoYo
Con PoYo è semplice usare entrambi i modelli:
- Un’unica chiave API per Fable 5.2, GPT-6.1 Sol e tutti gli altri modelli di chat, immagini, video e audio.
- Paghi a consumo, con addebito per token in crediti e senza abbonamento.
- Entrambi i formati API: Messages di Anthropic e Chat Completions e Responses di OpenAI.
- Un’unica tariffa per modello su tutta la finestra di contesto, il 20% in meno rispetto a ciascuna tariffa ufficiale per il contesto breve:
| Voce di costo (per 1M di token) | Claude Fable 5.2 su PoYo | GPT-6.1 Sol su PoYo |
|---|---|---|
| Input | $6.40 | $1.60 |
| Output | $32.00 | $8.00 |
| Lettura dalla cache | $0.16 | $0.08 |
| Scrittura in cache | $8.00 (5 min) / $12.80 (1 ora) | $2.00 |
Fable 5.2 tramite il formato Messages di Anthropic:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Analizza questo diff alla ricerca di bug di concorrenza: ..."}]
  }'
GPT-6.1 Sol tramite la Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Review this diff for concurrency bugs: ..."
  }'
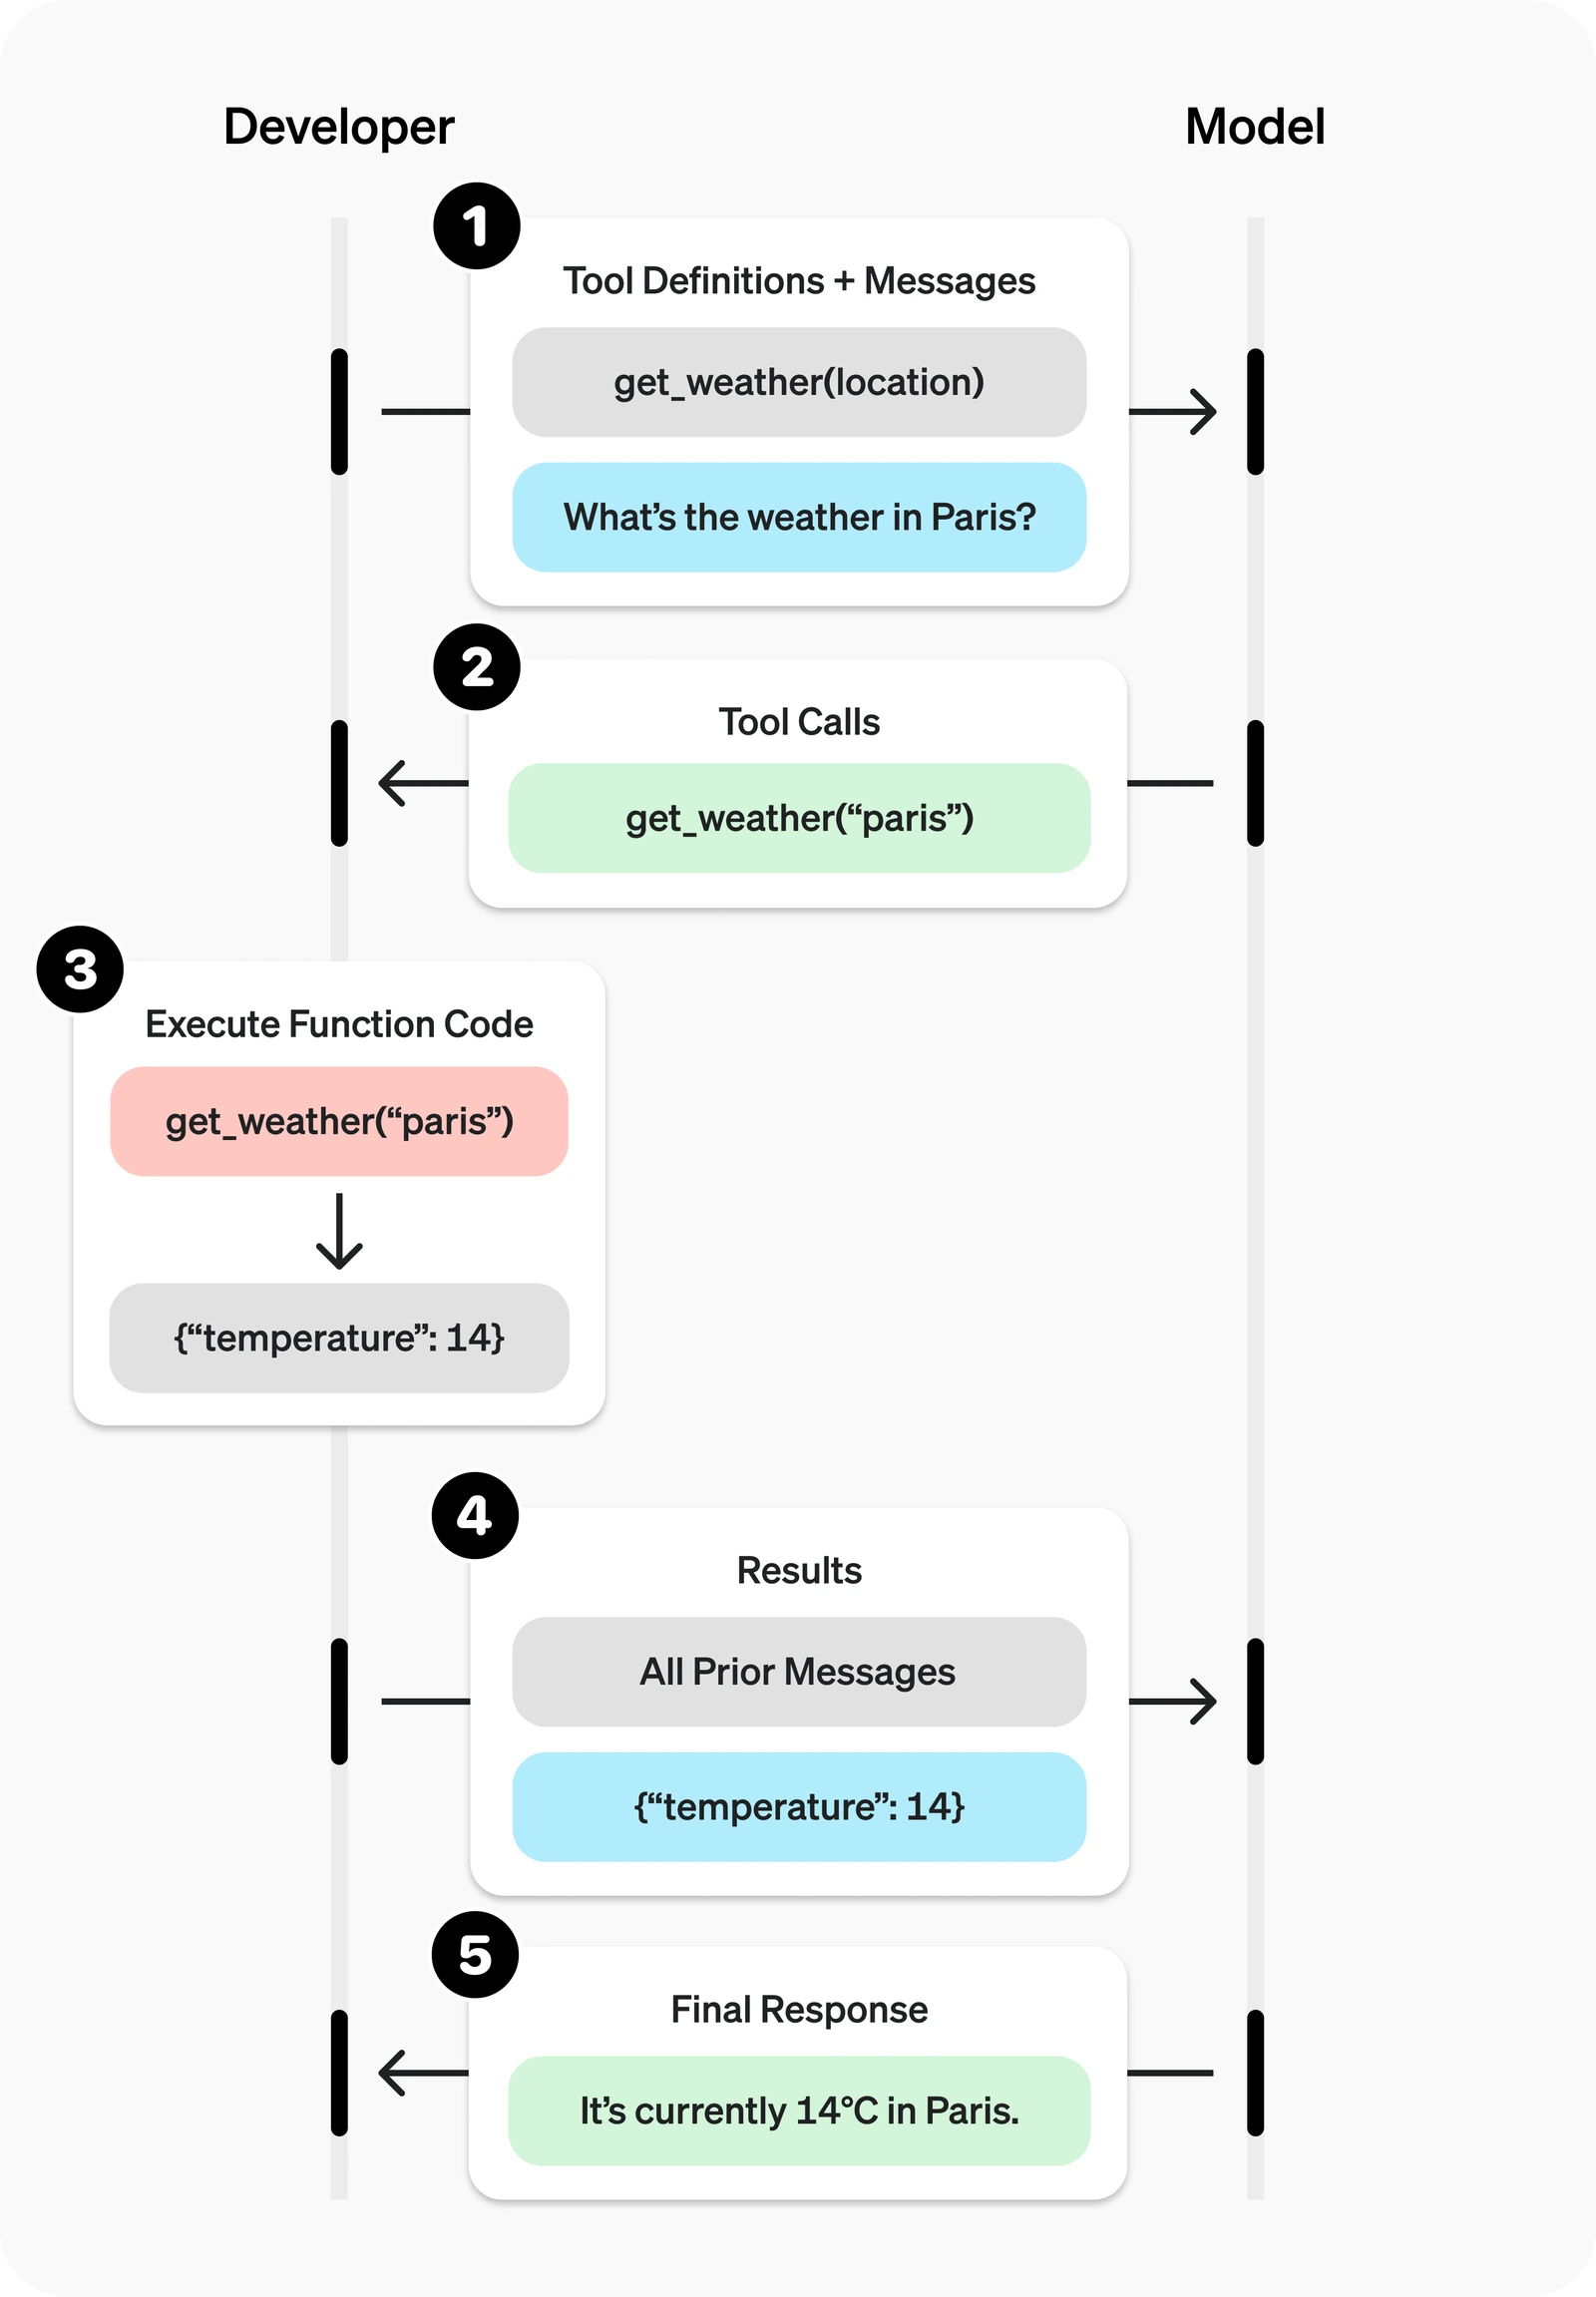
Il ciclo di chiamata delle funzioni che GPT-6.1 Sol usa per lavorare con gli strumenti. Schema dalla documentazione ufficiale di OpenAI.
Per un test A/B di entrambi sullo stesso percorso di codice, invia claude-fable-5-2 e gpt-6.1-sol a /v1/chat/completions e cambia solo il campo model. Per la configurazione degli SDK, l’impegno e la cache su Fable, consulta la nostra guida all’API di Claude Fable 5.2; per i limiti e gli strumenti di Sol, leggi la guida alle funzionalità di GPT-6.1 Sol.
Pagine dei modelli: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Domande frequenti
Fable 5 è migliore di GPT-5.6 Sol?
Ognuno era adatto a lavori diversi. Nei test di luglio 2026, Fable 5 ha superato tutti i 47 flussi di lavoro con strumenti su più app di Composio (GPT-5.6 Sol ne ha superati 45), mentre GPT-5.6 Sol ha ottenuto il punteggio più alto in tutte e tre le attività di pianificazione di sistemi di Kilo, a un prezzo per token più basso. Nella generazione attuale, Fable 5.2 ottiene 65 e GPT-6.1 Sol 55 sull’Artificial Analysis Intelligence Index, con Sol a una frazione del costo per attività.
GPT Astra sarà migliore di Fable?
GPT-6 Astra è già disponibile, a $10 / $50 per milione di token. Nella tabella di lancio di Fable 5.2 pubblicata da Anthropic, Fable 5.2 ottiene punteggi più alti di GPT-6 Astra in tutti i benchmark eseguiti su entrambi, ad esempio 74.6% contro 68.1% su Terminal-Bench-Science 0.1 e 89.3% contro 79.5% su OSWorld 2.1. Si tratta di esecuzioni di Anthropic: prova entrambi sulle tue attività prima di decidere.
GPT-5.6 Luna è migliore?
Luna è la fascia più piccola e conveniente di GPT-5.6, pensata per il lavoro rapido e ad alto volume, mentre Sol è adatto alle attività più difficili. Scegli Luna per throughput e costi, Sol per la profondità. Nella generazione attuale, GPT-6 Luna ha un prezzo di listino di $0.10 / $0.50 per milione di token.
Vale la pena usare GPT-5.6 Sol?
GPT-5.6 Sol appartiene alla generazione precedente. Per i nuovi progetti, GPT-6.1 Sol è il modello Sol attuale di OpenAI, a $2 / $10 per milione di token con contesto breve, oppure $1.60 / $8 su PoYo su tutta la finestra di contesto. GPT-5.6 Sol resta una buona scelta per le integrazioni già ottimizzate su di esso.
Claude Fable 5.2 è migliore di GPT-6.1 Sol?
Per la massima capacità, la scelta è Fable 5.2: sull’Artificial Analysis Intelligence Index ottiene da 10 a 19 punti in più a ogni livello di impegno. Per i costi, la scelta è GPT-6.1 Sol: costa un quarto per token e, all’impegno massimo, circa un ventesimo per attività dell’indice.
Quale costa meno, Fable 5.2 o GPT-6.1 Sol?
GPT-6.1 Sol. I prezzi ufficiali sono $2 / $10 per milione di token di input/output contro $8 / $40 di Fable 5.2. Oltre i 272K token di input, OpenAI porta Sol a $4 / $15 per l’intera richiesta, mentre Fable resta a $8 / $40. Su PoYo, Sol resta a $1.60 / $8 con prompt di qualsiasi lunghezza.
Quale è migliore per programmare?
I due fornitori riportano i risultati di programmazione su benchmark diversi. Anthropic indica per Fable 5.2 il 49.1% su FrontierCode 2.0, davanti a GPT-6 Astra, e OpenAI ha creato GPT-6.1 Sol per la programmazione complessa a un quinto del prezzo per token di Astra. Una scelta predefinita sensata è Sol per la programmazione di routine su larga scala e Fable 5.2 per le modifiche grandi e di lunga durata. Prova entrambi su un campione dei tuoi ticket.
Entrambi i modelli hanno una finestra di contesto da 1M?
Sì, più o meno. Fable 5.2 ha una finestra da 1M token. GPT-6.1 Sol ha una finestra da 1.050.000 token con un input massimo di 922.000 token. Entrambi scrivono fino a 128K token di output per richiesta.