
Det vigtigste
- Fable 5.2 passer til det sværeste arbejde; GPT-6.1 Sol passer til arbejde i store mængder. På Artificial Analysis Intelligence Index scorer Fable 5.2 65 og GPT-6.1 Sol 55 ved max effort, og Sol løser hver indeksopgave for en brøkdel af prisen.
- Officielle tokenpriser: $8 / $40 pr. million input-/output-tokens for Fable 5.2 og $2 / $10 for Sol ved kort kontekst, en forskel på 4×.
- Én fast pris på PoYo. OpenAI hæver hele anmodningen for Sol til $4 / $15 over 272K input-tokens. På PoYo koster GPT-6.1 Sol $1.60 / $8 i hele kontekstvinduet, og Fable 5.2 koster $6.40 / $32 i hele vinduet på 1 mio. tokens.
- Fable 5.2 lægger mere ræsonnement i hver opgave. Artificial Analysis målte $26.54 pr. indeksopgave for Fable 5.2 ved max effort og $1.27 for Sol.
- Fable 5.2 når hurtigt stærke scores. Ved
loweffort scorer den 54, tæt på Sols 55 vedmax, og gør en indeksopgave færdig på 5,8 minutter mod 23,3. - Søger du efter "GPT-5.6 Sol vs Fable 5"? Det var opgøret i juli 2026. Begge modelserier er gået videre; afsnittet nedenfor dækker det gamle par for sig.
Claude Fable 5.2 vs GPT-6.1 Sol i overblik
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Udvikler | Anthropic | OpenAI |
| Model-ID i API'en | claude-fable-5-2 | gpt-6.1-sol |
| Udgivet | 9. november 2026 | 29. september 2026 |
| Placering | Anthropics topniveau, over Opus | OpenAI's Sol-niveau, mellem GPT-6 Astra og GPT-6 Luna |
| Kontekstvindue | 1M tokens | 1.050.000 tokens (maks. input 922.000) |
| Maks. output | 128K tokens | 128K tokens |
| Input → output | Tekst og billeder → tekst | Tekst og billeder → tekst |
| Styring af ræsonnement | output_config.effort | reasoning.effort |
| Effort-niveauer | low til max, standard high | low til max, standard medium |
| Vidensgrænse | juni 2026 | 30. april 2026 |
| Officiel input / output (pr. 1M) | $8 / $40 | $2 / $10 (input ≤272K) $4 / $15 (input >272K) |
| Officiel cache-læsning (pr. 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| PoYo input / output (pr. 1M) | $6.40 / $32 | $1.60 / $8 |
| PoYo-endpoints | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs Fable 5: hvilke versioner sammenligner du?
De fleste sider, der rangerer på "GPT-5.6 Sol vs Fable 5", blev skrevet i juli 2026, da de to var de nyeste modeller. Siden da har begge serier udgivet nyere versioner:
| Model | Udvikler | Udgivet | Officiel input / output ved lancering (pr. 1M, kort kontekst) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9. juni 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9. juli 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1. september 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22. september 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29. september 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9. november 2026 | $8 / $40 |
GPT-5.6 Sol vs Claude Fable 5: opgøret i juli 2026
Ved lanceringen kostede GPT-5.6 Sol halvt så meget som Fable 5 på input og 40 % mindre på output ($5 / $30 mod $10 / $50, med cachet input til $0.50 mod $1). Uafhængige test fra den måned gav en delt dom:
| Test | Opsætning | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: tre planer for systemdesign | Kilo Code CLI, begge ved Max reasoning, bedømt efter en rubric skrevet på forhånd | Topscore på alle tre opgaver efter selv at have gennemgået og revideret hver plan; i gennemsnit 52 min 53 s pr. plan; $13.57 i alt | De planer, testerne fandt lettest at bygge ud fra; i gennemsnit 15 min 27 s pr. plan; $12.02 i alt |
| Composio: Golden Eval, 47 værktøjsworkflows på tværs af apps | Fable 5 i Claude Code; Sol i Codex CLI ved high | 45 af 47 bestået (95.7%); i gennemsnit 223.779 tokens og 79.6 s pr. opgave | 47 af 47 bestået (100%); i gennemsnit 276.957 tokens og 84.4 s pr. opgave |
| Analytics Vidhya: webapp, dataanalyse, investorpræsentation | Samme prompts, nye chats, standard-reasoning | Sammenlignelig kvalitet med omkring dobbelt så lang kørselstid | Sammenlignelig kvalitet og hurtigere kørsler; forfatterens valg til langt, komplekst arbejde, der overdrages i ét hug |
Mønstret i juli: GPT-5.6 Sol passede til planlægning og kodning til en lavere tokenpris og brugte ekstra tid på at kontrollere sit eget arbejde; Fable 5 passede til lange værktøjsworkflows og skrev planer, der var lette at bygge ud fra.
De resultater beskriver juli-modellerne, som nu er den forrige generation. Siden da er prisforskellen vokset til Sols fordel: Fable 5.2 koster 4× så meget som GPT-6.1 Sol pr. token, hvor Fable 5 kostede 2× så meget som GPT-5.6 Sol på input og omkring 1,7× på output. Resten af artiklen sammenligner det aktuelle par. På PoYo er GPT-5.6 Sol tilgængelig via Responses API'en til integrationer, der allerede er tilpasset den.
Det har de to modeller til fælles, og her adskiller de sig
Fælles:
- Omkring 1 mio. tokens kontekst og 128K output-tokens pr. anmodning.
- Tekst- og billedinput, tekstoutput.
- Fem effort-niveauer, fra
lowtilmax. Hver udbyder kalibrerer sine egne niveauer, så sammenlign resultater frem for betegnelser. - Prompt caching, streaming og struktureret output.
Forskelle:
- Standard-effort. Fable 5.2 kører som standard med
high; Sol medmedium. Angiv effort eksplicit i direkte sammenligninger, så begge kører på det niveau, du har tænkt dig. - Styring af tænkning. Fable 5.2 tænker altid adaptivt og accepterer
tool_choicemedautoellernone. Sol konfigureres viareasoning.effort, og dens hostede værktøjer (websøgning, filsøgning, code interpreter, hostet shell, apply patch, computerbrug, MCP, værktøjssøgning) kører via OpenAI's Responses API. - Vidensgrænse. Juni 2026 for Fable 5.2; 30. april 2026 for Sol.
- Dataopbevaring. Fable 5.2 kører med 30 dages dataopbevaring i Anthropics API.
Priser: 4× pr. token, 2× ved lange prompts
Officielle priser (USD pr. 1M tokens)
| Omkostning | Claude Fable 5.2 | GPT-6.1 Sol, input ≤272K | GPT-6.1 Sol, input >272K |
|---|---|---|---|
| Input | $8.00 | $2.00 | $4.00 |
| Output | $40.00 | $10.00 | $15.00 |
| Cache-læsning | $0.20 | $0.10 | $0.20 |
| Cache-skrivning | $10 (5 min) / $16 (1 time) | $2.50 (30 min) / $5.00 (12 timer) | $5.00 (30 min) / $10.00 (12 timer) |
OpenAI afregner prompts med mere end 272K input-tokens til 2× input- og cachepriserne og 1,5× outputprisen for hele anmodningen. Anthropic afregner hele vinduet på 1 mio. tokens for Fable 5.2 til standardpris. På PoYo bruger begge modeller én pris i hele kontekstvinduet, så GPT-6.1 Sol bliver på $1.60 / $8, uanset hvor lang prompten er. Se vores prisguide til Claude API'en for priserne på alle Claude-modeller.
Pris pr. anmodning
Eksemplerne antager, at begge modeller bruger lige mange tokens; det reelle forbrug varierer fra model til model (se næste afsnit). Omkostninger til cache-skrivning er udeladt for begge.
| Scenarie | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Chatsvar: 20K input + 4K output | Officiel: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Officiel: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Kodningsopgave: 100K input + 10K output | Officiel: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Officiel: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Langt dokument: 500K input + 20K output | Officiel: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Officiel: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Agentsession: 2M cachede læsninger + 300K nyt input + 150K output, hver anmodning under 272K | Officiel: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Officiel: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
Ved en prompt på 500K tokens indsnævrer Sols officielle pris for lang kontekst forskellen fra 4× til omkring 2,1×. På PoYo koster den samme anmodning $0.96 på GPT-6.1 Sol, fordi PoYo afregner Sol til én pris uden multiplikator for lang kontekst.
Pris pr. gennemført opgave
Tokenprisen er kun den ene halvdel af regningen. Artificial Analysis kører begge modeller gennem de samme opgaver i Intelligence Index og offentliggør prisen:
| Max effort | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Pris pr. indeksopgave | $26.54 | $1.27 |
| Tid pr. indeksopgave | 45.3 min | 23.3 min |
| Indeksscore | 65 | 55 |
Prisforskellen er omkring 21× mod en tokenprisforskel på 4×: Fable 5.2 lægger langt mere ræsonnement i hver opgave, og det er derfra, de højere scores kommer, mens Sol gør opgaverne færdige med langt færre tokens. På rigtige arbejdsbyrder bør du sammenligne den samlede regning pr. godkendt opgave sammen med tokenprisen.
Benchmarks
Samme opsætning: Artificial Analysis Intelligence Index
Artificial Analysis evaluerer begge modeller med de samme opgaver og det samme testmiljø, så tallene kan sammenlignes direkte. Intelligence Index v5.0.1, aflæst 14. november 2026:
| Effort | Score for Fable 5.2 | Score for GPT-6.1 Sol | Tid pr. opgave, Fable 5.2 | Tid pr. opgave, Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 min | 2.0 min |
medium | 56 | 46 | 7.7 min | 4.6 min |
high | 62 | 50 | 16.2 min | 7.9 min |
xhigh | 62 | 52 | 27.9 min | 10.7 min |
max | 65 | 55 | 45.3 min | 23.3 min |
Sådan læser du tabellen:
- Fable 5.2 scorer højere på alle niveauer, med 10 til 19 point, hvilket passer til arbejde, hvor svarkvaliteten betyder mest.
- Fable 5.2 ved
lowscorer tæt på Sol vedmax(54 mod 55) på en fjerdedel af tiden. - Sol leverer sine scores til en lav pris: $1.27 pr. indeksopgave ved max effort, hvilket passer til arbejde i store mængder og prisfølsomt arbejde.
- Fable genererer tokens hurtigere: omkring 94–102 output-tokens i sekundet mod 47–49 for Sol.
- Artificial Analysis mærker sine kørsler af Fable 5.2 "Default Fallback", hvilket betyder, at Anthropics fallback ved afvisninger var slået til under testen.
Anthropics lanceringsresultater
Anthropics tabel for Fable 5.2 sammenligner den med GPT-6 Astra, OpenAI's topniveau. Hver model kørte ved sin højeste tilgængelige effort, medmindre andet er angivet:
| Benchmark | Hvad den måler | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Agentisk kodning | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Softwareudvikling | 69.9% | 65.5% |
| AutomationBench | Forretningsworkflows | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Agentisk videnskab | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Computerbrug | 89.3% | 79.5% |
| Remote Labor Index | Rigtige betalte opgaver | 41.3% (high) | 20.8% |
| Humanity's Last Exam (med værktøjer) | Svært ræsonnement | 74.2% | 57.2% |
| Chartography (uden værktøjer) | Ræsonnement om diagrammer | 73.4% | 71.0% |

Score på FrontierCode 2.0 mod pris pr. opgave ved hvert effort-niveau. Diagram fra Anthropics lanceringsmateriale til Claude Fable 5.2.
OpenAI's lanceringsresultater
OpenAI lancerede GPT-6.1 Sol den 29. september 2026, seks uger før Fable 5.2, og sammenlignede den med sine egne GPT-6-modeller. OpenAI placerer den til kompleks kodning, computerbrug og professionelt arbejde med en kapacitet, der nærmer sig GPT-6 Astra, til en femtedel af Astras tokenpris ($2 / $10 mod $10 / $50). Lanceringsevalueringerne dækker softwareudvikling, dokumentforståelse, forretningsautomatisering og computerbrug.
Hver udbyder kører benchmarks i sit eget testmiljø og sin egen testversion, så sammenlign scores inden for den enkelte udbyders tabel, og brug Artificial Analysis-indekset ovenfor til en direkte sammenligning.
Hvilken skal du vælge?
| Din arbejdsbyrde | Start med | Hvorfor |
|---|---|---|
| Chat, udtræk og routing i store mængder | GPT-6.1 Sol på medium (eller en mindre model) | Klarer korte opgaver til en fjerdedel af Fables tokenpris |
| Daglig kodning og agentløkker på et budget | GPT-6.1 Sol | Bygget til kodning og agentarbejde til $2 / $10 officielt og $1.60 / $8 på PoYo |
| Det sværeste ræsonnement, research, lange autonome kørsler | Fable 5.2 | 65 mod 55 på Intelligence Index; fører over GPT-6 Astra i hele Anthropics tabel |
| Svære problemer, hvor ventetid er dyr | Fable 5.2 på low eller medium | Scorer tæt på Sols max på en fjerdedel af tiden |
| Computerbrug, diagrammer, tætte visuelle dokumenter | Fable 5.2 | 89.3% på OSWorld 2.1 og 73.4% på Chartography i Anthropics tabel |
| Prompts, der jævnligt er over 272K tokens | GPT-6.1 Sol på PoYo for prisen, Fable 5.2 for dybden | På PoYo har begge én pris i hele vinduet: $1.60 / $8 for Sol, $6.40 / $32 for Fable |
| Bygget på OpenAI's hostede værktøjer (shell, websøgning, MCP) | GPT-6.1 Sol | De værktøjer kører direkte via Responses API'en |
| Claude-kvalitet til en lavere pris | Claude Opus 5.5 | $4 / $20; se Claude Fable 5.2 vs Opus 5.5 |
Lange autonome kørsler passer til Fable 5.2: Dens agenter byggede dette prototype-styresystem, her vist kørende på en bærbar. Video fra Anthropics lanceringsmateriale til Claude Fable 5.2.
En praktisk routing-opsætning: Send rutinetrafik til GPT-6.1 Sol på medium, notér, hvilke opgavetyper der har gavn af dybere ræsonnement, og send dem videre til Fable 5.2 på medium. Sammenlign efter en uge prisen pr. godkendt opgave i stedet for tokenpriserne. Se GPT-6.1 Sol vs Claude Opus 5.5 for Claude-modellen i mellemprisklassen over for Sol.
Brug begge på PoYo
PoYo gør det nemt at køre begge:
- Én API-nøgle til Fable 5.2, GPT-6.1 Sol og alle andre chat-, billed-, video- og lydmodeller.
- Betal efter forbrug, afregnet pr. token i kreditter og uden abonnement.
- Begge API-formater: Anthropic Messages samt OpenAI Chat Completions og Responses.
- Én pris pr. model i hele kontekstvinduet, 20 % under hver officiel pris for kort kontekst:
| Omkostning (pr. 1M tokens) | Claude Fable 5.2 på PoYo | GPT-6.1 Sol på PoYo |
|---|---|---|
| Input | $6.40 | $1.60 |
| Output | $32.00 | $8.00 |
| Cache-læsning | $0.16 | $0.08 |
| Cache-skrivning | $8.00 (5 min) / $12.80 (1 time) | $2.00 |
Fable 5.2 via Anthropic Messages-formatet:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Gennemgå denne diff for samtidighedsfejl: ..."}]
  }'
GPT-6.1 Sol via Responses API'en:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Gennemgå denne diff for samtidighedsfejl: ..."
  }'
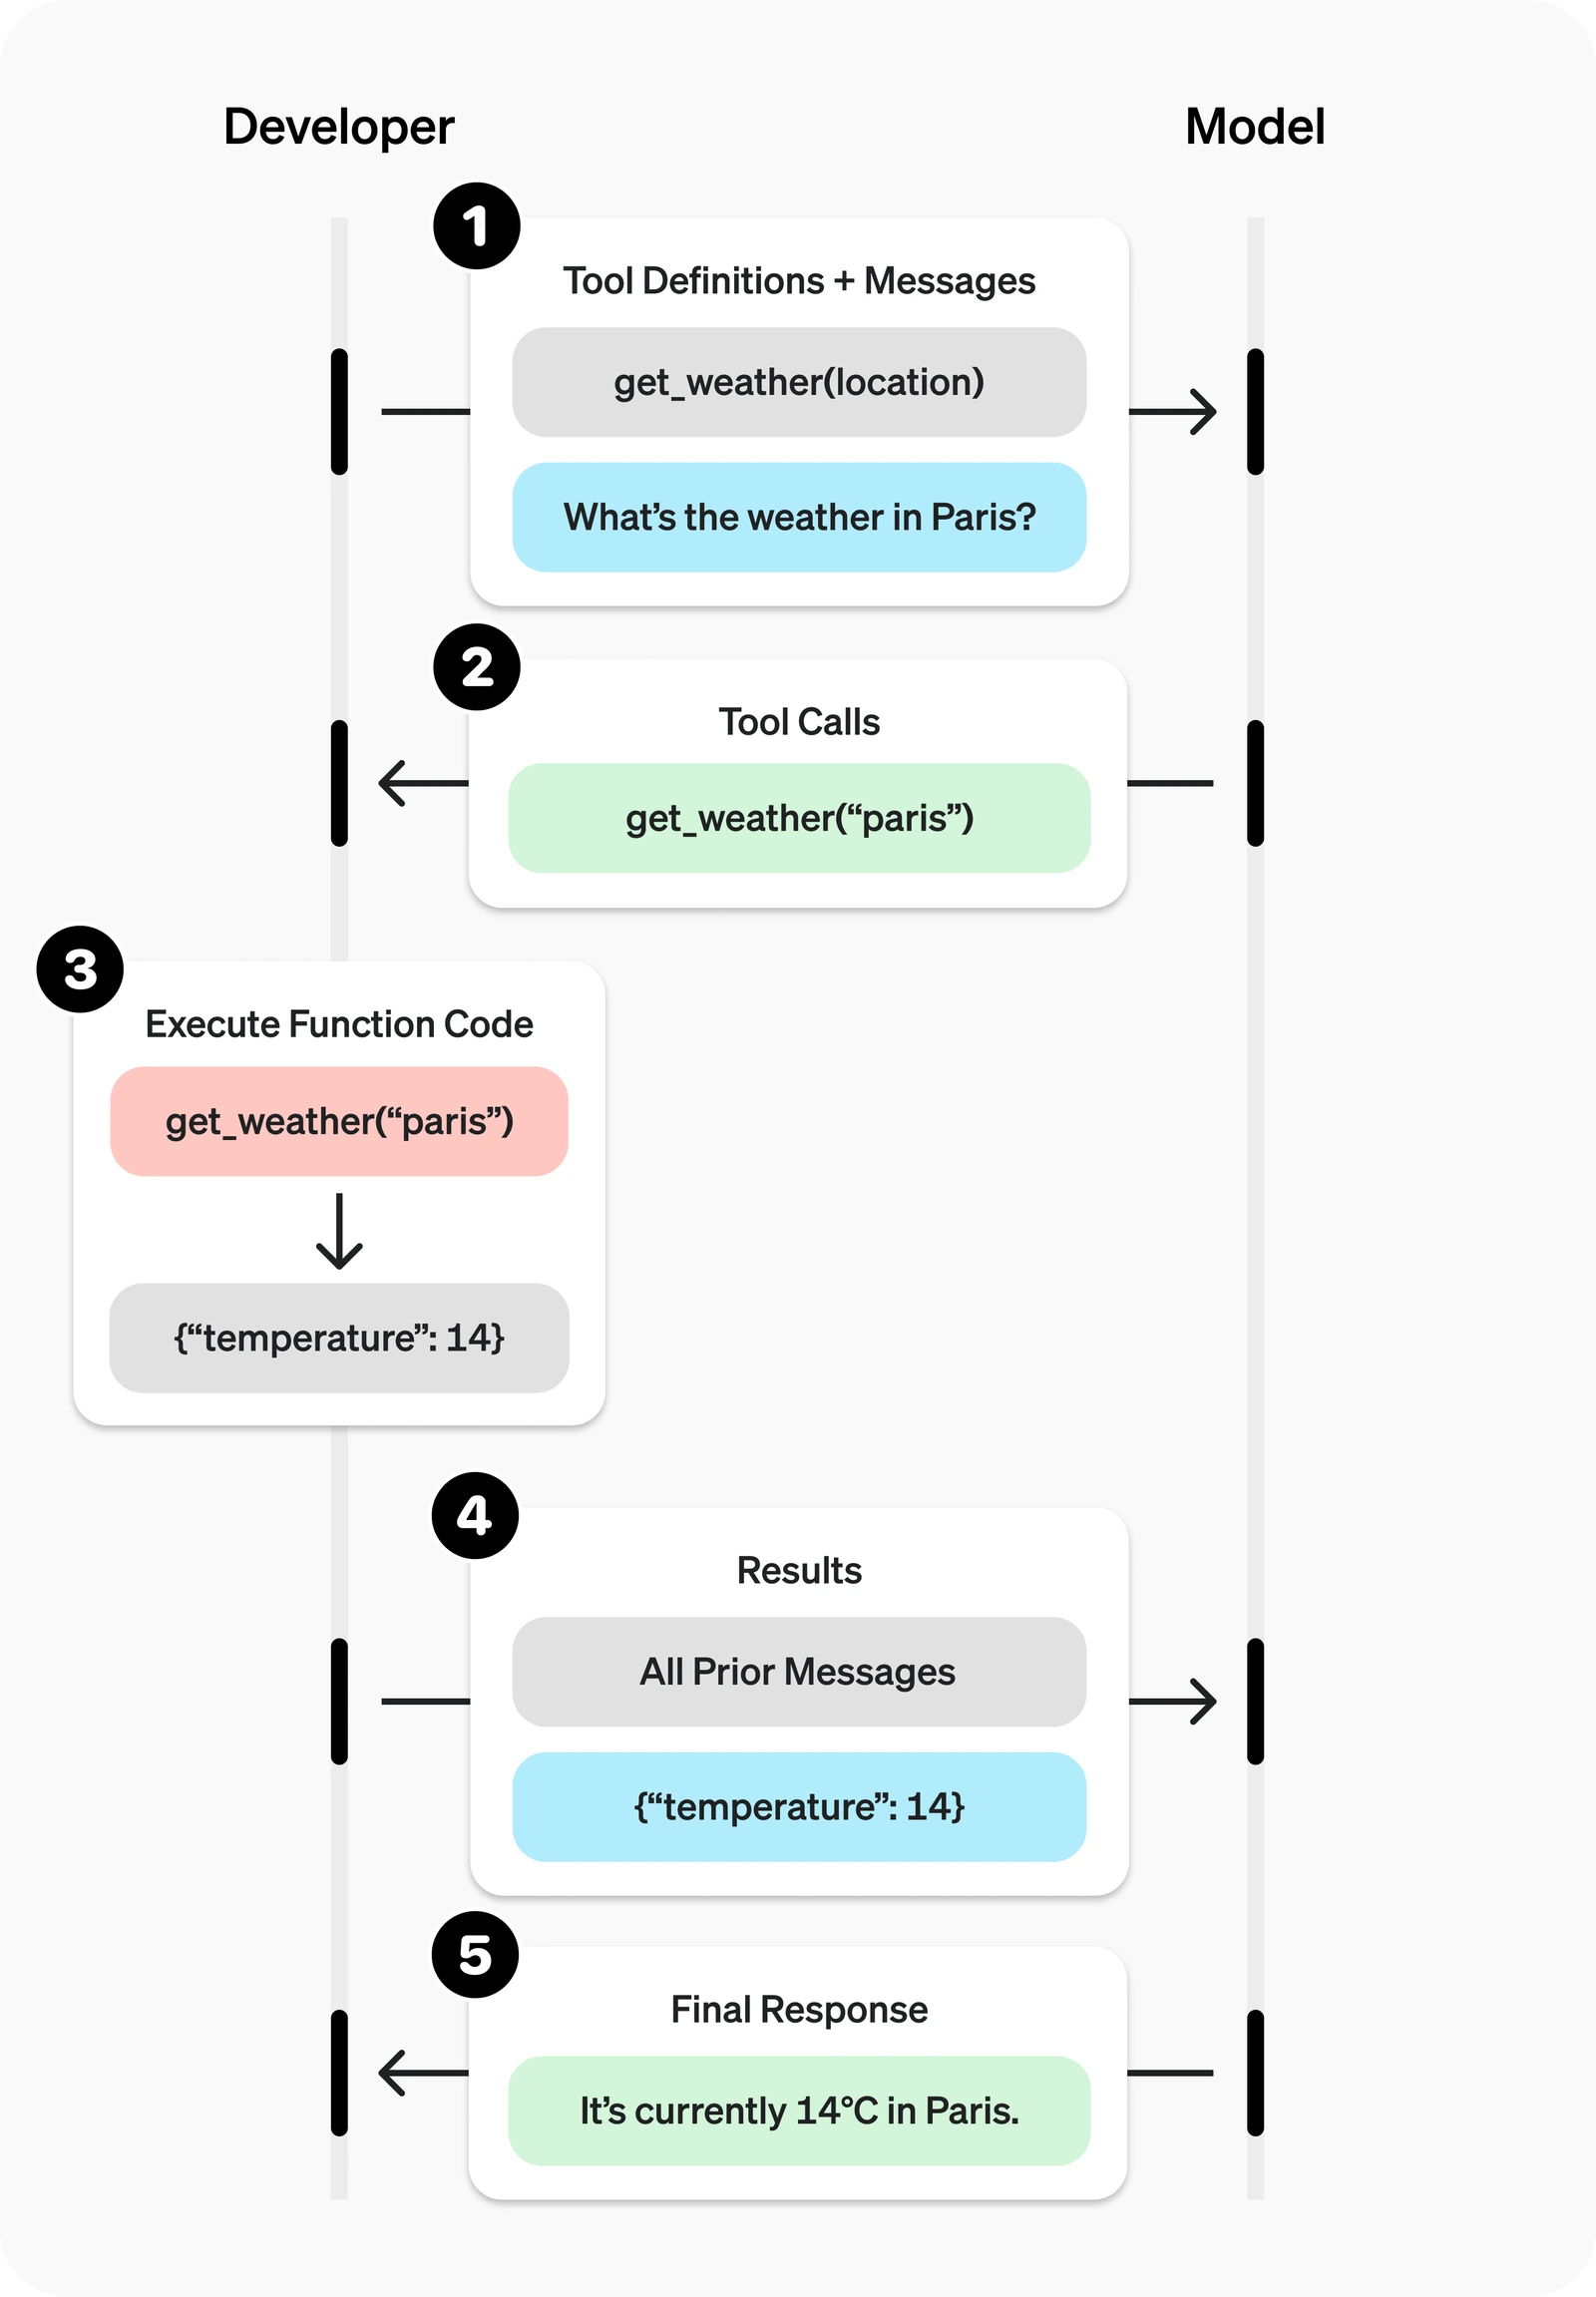
Løkken for funktionskald, som GPT-6.1 Sol bruger til arbejde med værktøjer. Diagram fra OpenAI's officielle dokumentation.
Vil du A/B-teste begge på samme kodesti, så send claude-fable-5-2 og gpt-6.1-sol til /v1/chat/completions, og skift kun feltet model. Se vores API-guide til Claude Fable 5.2 for SDK-opsætning, effort og caching på Fable, og guiden til GPT-6.1 Sols funktioner for Sols grænser og værktøjer.
Modelsider: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Ofte stillede spørgsmål
Er Fable 5 bedre end GPT-5.6 Sol?
De passede til forskelligt arbejde. I test fra juli 2026 bestod Fable 5 alle 47 af Composios værktøjsworkflows på tværs af apps (GPT-5.6 Sol bestod 45), mens GPT-5.6 Sol fik den højeste score på alle tre af Kilos opgaver i planlægning af systemdesign til en lavere tokenpris. I den nuværende generation scorer Fable 5.2 65 og GPT-6.1 Sol 55 på Artificial Analysis Intelligence Index, og Sol koster en brøkdel pr. opgave.
Bliver GPT Astra bedre end Fable?
GPT-6 Astra er allerede tilgængelig til $10 / $50 pr. million tokens. I Anthropics lanceringstabel for Fable 5.2 scorer Fable 5.2 højere end GPT-6 Astra på alle benchmarks, begge er kørt på, for eksempel 74,6 % mod 68,1 % på Terminal-Bench-Science 0.1 og 89,3 % mod 79,5 % på OSWorld 2.1. Det er Anthropics egne kørsler; test begge på dine opgaver, før du beslutter dig.
Er GPT-5.6 Luna bedre?
Luna er det mindste og billigste GPT-5.6-niveau, bygget til hurtigt arbejde i store mængder, mens Sol passer til sværere opgaver. Vælg Luna for kapacitet og pris, Sol for dybde. I den nuværende generation har GPT-6 Luna en listepris på $0.10 / $0.50 pr. million tokens.
Er GPT-5.6 Sol pengene værd?
GPT-5.6 Sol er den forrige generation. Til nye projekter er GPT-6.1 Sol OpenAI's aktuelle Sol-model til $2 / $10 pr. million tokens ved kort kontekst eller $1.60 / $8 på PoYo i hele kontekstvinduet. GPT-5.6 Sol passer fortsat godt til integrationer, der allerede er tilpasset den.
Er Claude Fable 5.2 bedre end GPT-6.1 Sol?
Går du efter maksimal kapacitet, er Fable 5.2 valget: Den scorer 10 til 19 point højere på alle effort-niveauer i Artificial Analysis Intelligence Index. Går du efter pris, er GPT-6.1 Sol valget: Den koster en fjerdedel pr. token og ved max effort omkring en tyvendedel pr. indeksopgave.
Hvilken er billigst, Fable 5.2 eller GPT-6.1 Sol?
GPT-6.1 Sol. De officielle priser er $2 / $10 pr. million input-/output-tokens mod $8 / $40 for Fable 5.2. Over 272K input-tokens hæver OpenAI Sol til $4 / $15 for hele anmodningen, mens Fable bliver på $8 / $40. På PoYo bliver Sol på $1.60 / $8 uanset promptens længde.
Hvilken er bedst til kodning?
De to udbydere rapporterer kodningsresultater på forskellige benchmarks. Anthropic rapporterer 49,1 % for Fable 5.2 på FrontierCode 2.0, foran GPT-6 Astra, og OpenAI har bygget GPT-6.1 Sol til kompleks kodning til en femtedel af Astras tokenpris. Et fornuftigt udgangspunkt er Sol til rutinemæssig kodning i store mængder og Fable 5.2 til store, langvarige ændringer. Kør begge på et udsnit af dine egne opgaver.
Har begge modeller et kontekstvindue på 1 mio. tokens?
Ja, omtrent. Fable 5.2 har et vindue på 1 mio. tokens. GPT-6.1 Sol har et vindue på 1.050.000 tokens med op til 922.000 input-tokens. Begge skriver op til 128K output-tokens pr. anmodning.