
Puntos clave
- Fable 5.2 encaja con el trabajo más difícil; GPT-6.1 Sol, con el trabajo de gran volumen. En el Artificial Analysis Intelligence Index, Fable 5.2 obtiene 65 y GPT-6.1 Sol 55 con el esfuerzo máximo, y Sol completa cada tarea del índice por una fracción del coste.
- Precios oficiales por token: $8 / $40 por millón de tokens de entrada/salida para Fable 5.2 y $2 / $10 para Sol con contexto corto, una diferencia de 4×.
- Una tarifa única en PoYo. OpenAI sube toda la solicitud de Sol a $4 / $15 por encima de 272K tokens de entrada. En PoYo, GPT-6.1 Sol cuesta $1.60 / $8 en toda su ventana de contexto, y Fable 5.2 cuesta $6.40 / $32 en toda su ventana de 1M.
- Fable 5.2 dedica más razonamiento a cada tarea. Artificial Analysis midió $26.54 por tarea del índice para Fable 5.2 con el esfuerzo máximo y $1.27 para Sol.
- Fable 5.2 alcanza puntuaciones altas con rapidez. Con el esfuerzo
lowobtiene 54, cerca de los 55 de Sol enmax, y termina una tarea del índice en 5.8 minutos frente a 23.3. - ¿Buscas «GPT-5.6 Sol vs. Fable 5»? Ese fue el enfrentamiento de julio de 2026. Ambas líneas han avanzado desde entonces; la sección siguiente trata la pareja anterior por separado.
Claude Fable 5.2 vs. GPT-6.1 Sol de un vistazo
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Desarrollador | Anthropic | OpenAI |
| ID del modelo en la API | claude-fable-5-2 | gpt-6.1-sol |
| Lanzamiento | 9 de noviembre de 2026 | 29 de septiembre de 2026 |
| Posición | Gama alta de Anthropic, por encima de Opus | Gama Sol de OpenAI, entre GPT-6 Astra y GPT-6 Luna |
| Ventana de contexto | 1M tokens | 1.050.000 tokens (entrada máxima de 922.000) |
| Salida máxima | 128K tokens | 128K tokens |
| Entrada → salida | Texto e imágenes → texto | Texto e imágenes → texto |
| Control del razonamiento | output_config.effort | reasoning.effort |
| Niveles de esfuerzo | De low a max, high por defecto | De low a max, medium por defecto |
| Fecha de corte de conocimientos | Junio de 2026 | 30 de abril de 2026 |
| Entrada / salida oficial (por 1M) | $8 / $40 | $2 / $10 (entrada ≤272K) $4 / $15 (entrada >272K) |
| Lectura de caché oficial (por 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| Entrada / salida en PoYo (por 1M) | $6.40 / $32 | $1.60 / $8 |
| Endpoints en PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs. Fable 5: ¿qué versiones estás comparando?
La mayoría de las páginas que aparecen al buscar «GPT-5.6 Sol vs. Fable 5» se escribieron en julio de 2026, cuando esos dos eran los modelos más recientes. Desde entonces, cada línea ha lanzado versiones nuevas:
| Modelo | Desarrollador | Lanzamiento | Entrada / salida oficial en el lanzamiento (por 1M, contexto corto) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9 de junio de 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9 de julio de 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1 de septiembre de 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22 de septiembre de 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29 de septiembre de 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9 de noviembre de 2026 | $8 / $40 |
GPT-5.6 Sol vs. Claude Fable 5: el enfrentamiento de julio de 2026
En su lanzamiento, GPT-5.6 Sol costaba la mitad que Fable 5 en entrada y un 40% menos en salida ($5 / $30 frente a $10 / $50, con la entrada en caché a $0.50 frente a $1). Las pruebas independientes de aquel mes dieron un veredicto repartido:
| Prueba | Configuración | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: tres planes de diseño de sistemas | Kilo Code CLI, ambos con razonamiento Max, evaluados con una rúbrica redactada de antemano | Mejor puntuación en las tres tareas, tras revisar y corregir cada plan por sí mismo; 52 min 53 s por plan de media; $13.57 en total | Los planes que a los evaluadores les resultaron más fáciles de implementar; 15 min 27 s por plan de media; $12.02 en total |
| Composio: Golden Eval, 47 flujos de herramientas entre varias aplicaciones | Fable 5 en Claude Code; Sol en Codex CLI con high | 45 de 47 aprobados (95.7%); 223.779 tokens y 79.6 s por tarea de media | 47 de 47 aprobados (100%); 276.957 tokens y 84.4 s por tarea de media |
| Analytics Vidhya: aplicación web, análisis de datos, presentación para inversores | Mismos prompts, chats nuevos, razonamiento predeterminado | Calidad comparable, con aproximadamente el doble de tiempo de ejecución | Calidad comparable y ejecuciones más rápidas; la elección del autor para trabajos largos y complejos encargados de una sola vez |
El patrón de julio: GPT-5.6 Sol encajaba con la planificación y la programación a un precio por token más bajo y dedicaba tiempo extra a revisar su propio trabajo; Fable 5 encajaba con los flujos largos de herramientas y redactaba planes fáciles de implementar.
Esos resultados describen los modelos de julio, que ahora son la generación anterior. Desde entonces, la diferencia de precio se ha ampliado a favor de Sol: Fable 5.2 cuesta 4× lo que GPT-6.1 Sol por token, mientras que Fable 5 costaba 2× lo que GPT-5.6 Sol en entrada y unas 1.7× en salida. El resto de este artículo compara la pareja actual. En PoYo, GPT-5.6 Sol está disponible a través de la Responses API para las integraciones que ya están ajustadas a él.
Lo que comparten los dos modelos y en qué se diferencian
En común:
- Alrededor de 1M tokens de contexto y 128K tokens de salida por solicitud.
- Entrada de texto e imágenes, salida de texto.
- Cinco niveles de esfuerzo, de
lowamax. Cada proveedor calibra sus propios niveles, así que compara los resultados y no las etiquetas. - Almacenamiento en caché de prompts, streaming y salidas estructuradas.
Diferencias:
- Esfuerzo predeterminado. Fable 5.2 usa
highpor defecto; Sol usamedium. Fija el esfuerzo de forma explícita en las pruebas comparativas para que ambos funcionen al nivel que quieres. - Controles del razonamiento. Fable 5.2 razona siempre de forma adaptativa y acepta
autoononeentool_choice. Sol se configura conreasoning.effort, y sus herramientas alojadas (búsqueda web, búsqueda de archivos, intérprete de código, shell alojado, aplicación de parches, uso del ordenador, MCP, búsqueda de herramientas) funcionan a través de la Responses API de OpenAI. - Fecha de corte de conocimientos. Junio de 2026 para Fable 5.2; 30 de abril de 2026 para Sol.
- Retención de datos. Fable 5.2 funciona con retención de datos de 30 días en la API de Anthropic.
Precios: 4× por token, 2× en prompts largos
Tarifas oficiales (USD por 1M de tokens)
| Cargo | Claude Fable 5.2 | GPT-6.1 Sol, entrada ≤272K | GPT-6.1 Sol, entrada >272K |
|---|---|---|---|
| Entrada | $8.00 | $2.00 | $4.00 |
| Salida | $40.00 | $10.00 | $15.00 |
| Lectura de caché | $0.20 | $0.10 | $0.20 |
| Escritura en caché | $10 (5 min) / $16 (1 hora) | $2.50 (30 min) / $5.00 (12 horas) | $5.00 (30 min) / $10.00 (12 horas) |
OpenAI factura los prompts de más de 272K tokens de entrada a 2× las tarifas de entrada y de caché y a 1.5× la tarifa de salida, en toda la solicitud. Anthropic factura toda la ventana de 1M de Fable 5.2 a las tarifas estándar. En PoYo, ambos modelos usan una única tarifa en toda su ventana de contexto, así que GPT-6.1 Sol se mantiene en $1.60 / $8 sea cual sea la longitud del prompt. Para los precios de todos los modelos Claude, consulta nuestra guía de precios de Claude API.
Coste por solicitud
Estos ejemplos suponen que ambos modelos usan la misma cantidad de tokens; el uso real varía según el modelo (consulta la sección siguiente). Los cargos por escritura en caché no se incluyen en ninguno de los dos.
| Escenario | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Respuesta de chat: 20K de entrada + 4K de salida | Oficial: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Oficial: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Tarea de programación: 100K de entrada + 10K de salida | Oficial: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Oficial: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Documento largo: 500K de entrada + 20K de salida | Oficial: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Oficial: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Sesión de agente: 2M de lecturas en caché + 300K de entrada nueva + 150K de salida, con todas las solicitudes por debajo de 272K | Oficial: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Oficial: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
Con un prompt de 500K tokens, la tarifa oficial de contexto largo de Sol reduce la diferencia de 4× a unas 2.1×. En PoYo, la misma solicitud cuesta $0.96 en GPT-6.1 Sol, porque PoYo factura Sol con una única tarifa sin multiplicador de contexto largo.
Coste por tarea completada
El precio por token es solo la mitad de la factura. Artificial Analysis ejecuta ambos modelos con las mismas tareas del Intelligence Index y publica el coste:
| Esfuerzo máximo | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Coste por tarea del índice | $26.54 | $1.27 |
| Tiempo por tarea del índice | 45.3 min | 23.3 min |
| Puntuación en el índice | 65 | 55 |
La diferencia de coste es de unas 21×, frente a una diferencia de precio de 4×: Fable 5.2 dedica mucho más razonamiento a cada tarea, y de ahí salen sus puntuaciones más altas, mientras que Sol completa las tareas con muchos menos tokens. En cargas de trabajo reales, compara la factura total por tarea aceptada junto con la tarifa por token.
Benchmarks
Misma configuración: Artificial Analysis Intelligence Index
Artificial Analysis evalúa ambos modelos con las mismas tareas y el mismo entorno de pruebas, así que sus cifras se pueden comparar directamente. Intelligence Index v5.0.1, consultado el 14 de noviembre de 2026:
| Esfuerzo | Puntuación de Fable 5.2 | Puntuación de GPT-6.1 Sol | Tiempo por tarea de Fable 5.2 | Tiempo por tarea de Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 min | 2.0 min |
medium | 56 | 46 | 7.7 min | 4.6 min |
high | 62 | 50 | 16.2 min | 7.9 min |
xhigh | 62 | 52 | 27.9 min | 10.7 min |
max | 65 | 55 | 45.3 min | 23.3 min |
Cómo leer la tabla:
- Fable 5.2 puntúa más alto en todos los niveles, entre 10 y 19 puntos, lo que encaja con los trabajos en los que más importa la calidad de la respuesta.
- Fable 5.2 en
lowpuntúa cerca de Sol enmax(54 frente a 55) en una cuarta parte del tiempo. - Sol consigue sus puntuaciones a bajo coste: $1.27 por tarea del índice con el esfuerzo máximo, lo que encaja con el trabajo de gran volumen y sensible al presupuesto.
- Fable genera tokens más rápido: unos 94–102 tokens de salida por segundo, frente a 47–49 de Sol.
- Artificial Analysis etiqueta sus ejecuciones de Fable 5.2 como «Default Fallback», lo que significa que el mecanismo alternativo de Anthropic ante rechazos estaba activado durante las pruebas.
Resultados del lanzamiento de Anthropic
La tabla de Fable 5.2 de Anthropic lo compara con GPT-6 Astra, la gama alta de OpenAI. Cada modelo se ejecutó con su máximo esfuerzo disponible, salvo que se indique lo contrario:
| Benchmark | Qué mide | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Programación agéntica | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Ingeniería de software | 69.9% | 65.5% |
| AutomationBench | Flujos de trabajo empresariales | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Ciencia agéntica | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Uso del ordenador | 89.3% | 79.5% |
| Remote Labor Index | Encargos reales remunerados | 41.3% (high) | 20.8% |
| Humanity's Last Exam (con herramientas) | Razonamiento difícil | 74.2% | 57.2% |
| Chartography (sin herramientas) | Razonamiento sobre gráficos | 73.4% | 71.0% |

Puntuación en FrontierCode 2.0 frente al coste por tarea en cada nivel de esfuerzo. Gráfico de los materiales de lanzamiento de Claude Fable 5.2 de Anthropic.
Resultados del lanzamiento de OpenAI
OpenAI lanzó GPT-6.1 Sol el 29 de septiembre de 2026, seis semanas antes que Fable 5.2, y lo comparó con sus propios modelos GPT-6. OpenAI lo orienta a la programación compleja, el uso del ordenador y el trabajo profesional, con una capacidad cercana a la de GPT-6 Astra por una quinta parte de su precio por token ($2 / $10 frente a $10 / $50). Sus evaluaciones de lanzamiento abarcan ingeniería de software, comprensión de documentos, automatización empresarial y uso del ordenador.
Cada proveedor ejecuta los benchmarks con su propio entorno y su propia versión de las pruebas, así que compara las puntuaciones dentro de la tabla de un mismo proveedor y usa el índice de Artificial Analysis anterior para una comparación directa.
¿Cuál deberías elegir?
| Tu carga de trabajo | Empieza con | Por qué |
|---|---|---|
| Chat, extracción y enrutamiento a gran escala | GPT-6.1 Sol en medium (o un modelo más pequeño) | Resuelve tareas cortas a una cuarta parte del precio por token de Fable |
| Programación diaria y ciclos de agentes con presupuesto ajustado | GPT-6.1 Sol | Diseñado para programación y agentes, a $2 / $10 oficial y $1.60 / $8 en PoYo |
| Razonamiento más difícil, investigación, ejecuciones autónomas largas | Fable 5.2 | 65 frente a 55 en el Intelligence Index; supera a GPT-6 Astra en toda la tabla de Anthropic |
| Problemas difíciles en los que esperar sale caro | Fable 5.2 en low o medium | Puntúa cerca del máximo de Sol en una cuarta parte del tiempo |
| Uso del ordenador, gráficos, documentos visuales densos | Fable 5.2 | 89.3% en OSWorld 2.1 y 73.4% en Chartography en la tabla de Anthropic |
| Prompts que suelen superar los 272K tokens | GPT-6.1 Sol en PoYo por coste, Fable 5.2 por profundidad | En PoYo ambos mantienen una única tarifa en toda la ventana: $1.60 / $8 para Sol, $6.40 / $32 para Fable |
| Proyectos basados en las herramientas alojadas de OpenAI (shell, búsqueda web, MCP) | GPT-6.1 Sol | Esas herramientas funcionan de forma nativa a través de la Responses API |
| Calidad de Claude a un precio más bajo | Claude Opus 5.5 | $4 / $20; consulta Claude Fable 5.2 vs. Opus 5.5 |
Las ejecuciones autónomas largas encajan con Fable 5.2: sus agentes crearon este prototipo de sistema operativo, que aparece funcionando en un portátil. Vídeo de los materiales de lanzamiento de Claude Fable 5.2 de Anthropic.
Un enrutamiento práctico: envía el tráfico rutinario a GPT-6.1 Sol en medium, anota qué tipos de tareas se benefician de un razonamiento más profundo y derívalos a Fable 5.2 en medium. Pasada una semana, compara el coste por tarea aceptada en lugar de los precios por token. Para la opción de Claude de precio intermedio frente a Sol, consulta GPT-6.1 Sol vs. Claude Opus 5.5.
Usa ambos en PoYo
PoYo facilita trabajar con los dos:
- Una sola clave de API para Fable 5.2, GPT-6.1 Sol y todos los demás modelos de chat, imagen, vídeo y audio.
- Pago por uso, facturado por token en créditos, sin suscripción.
- Los dos formatos de API: Messages de Anthropic, y Chat Completions y Responses de OpenAI.
- Una tarifa por modelo en toda la ventana de contexto, un 20% por debajo de cada tarifa oficial de contexto corto:
| Cargo (por 1M de tokens) | Claude Fable 5.2 en PoYo | GPT-6.1 Sol en PoYo |
|---|---|---|
| Entrada | $6.40 | $1.60 |
| Salida | $32.00 | $8.00 |
| Lectura de caché | $0.16 | $0.08 |
| Escritura en caché | $8.00 (5 min) / $12.80 (1 hora) | $2.00 |
Fable 5.2 con el formato Messages de Anthropic:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Revisa este diff en busca de errores de concurrencia: ..."}]
  }'
GPT-6.1 Sol con la Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Revisa este diff en busca de errores de concurrencia: ..."
  }'
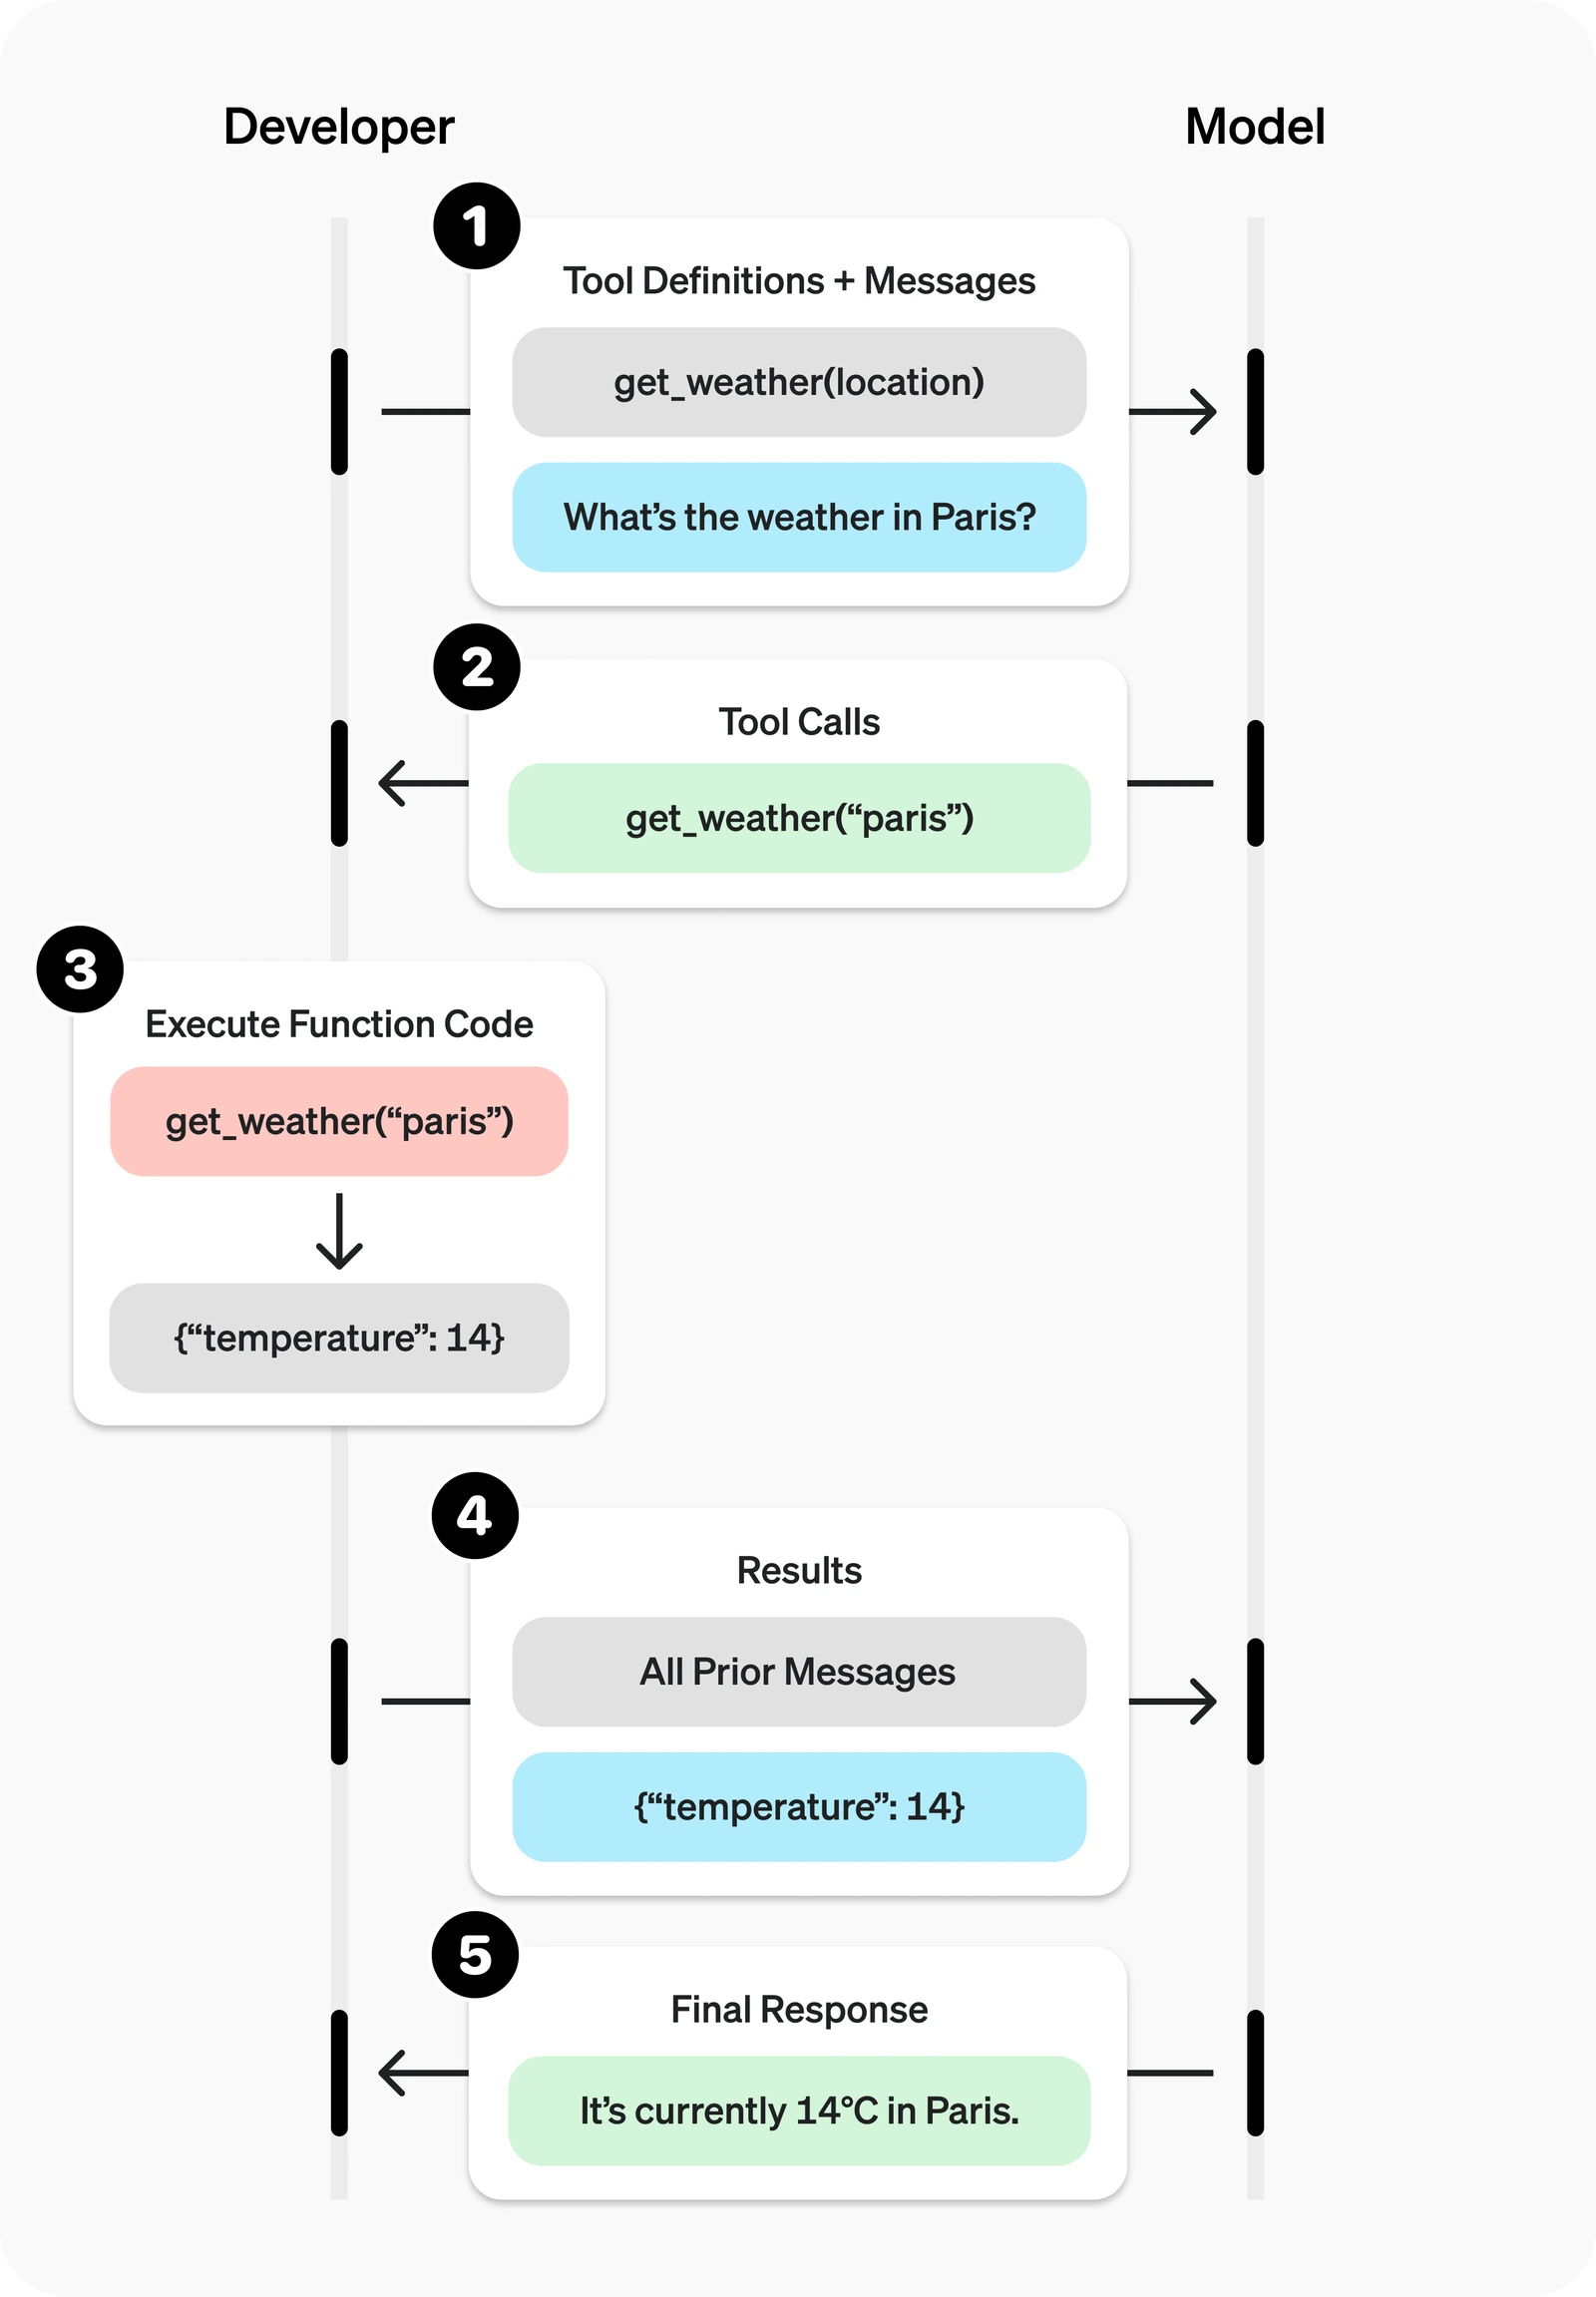
El ciclo de llamada a funciones que usa GPT-6.1 Sol para trabajar con herramientas. Diagrama de la documentación oficial de OpenAI.
Para hacer una prueba A/B de ambos con el mismo código, envía claude-fable-5-2 y gpt-6.1-sol a /v1/chat/completions y cambia solo el campo model. Para la configuración del SDK, el esfuerzo y la caché en Fable, consulta nuestra guía de la API de Claude Fable 5.2; para los límites y las herramientas de Sol, consulta la guía de funciones de GPT-6.1 Sol.
Páginas de los modelos: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Preguntas frecuentes
¿Es Fable 5 mejor que GPT-5.6 Sol?
Cada uno encajaba con un tipo de trabajo distinto. En las pruebas de julio de 2026, Fable 5 superó los 47 flujos de herramientas entre varias aplicaciones de Composio (GPT-5.6 Sol superó 45), mientras que GPT-5.6 Sol obtuvo la mejor puntuación en las tres tareas de planificación de diseño de sistemas de Kilo a un precio por token más bajo. En la generación actual, Fable 5.2 obtiene 65 y GPT-6.1 Sol 55 en el Artificial Analysis Intelligence Index, con Sol a una fracción del coste por tarea.
¿Será GPT Astra mejor que Fable?
GPT-6 Astra ya está disponible, a $10 / $50 por millón de tokens. En la tabla de lanzamiento de Fable 5.2 de Anthropic, Fable 5.2 puntúa más alto que GPT-6 Astra en todos los benchmarks en los que se probaron ambos, por ejemplo 74.6% frente a 68.1% en Terminal-Bench-Science 0.1 y 89.3% frente a 79.5% en OSWorld 2.1. Son ejecuciones de la propia Anthropic; prueba ambos con tus tareas antes de decidir.
¿Es mejor GPT-5.6 Luna?
Luna es la gama más pequeña y asequible de GPT-5.6, pensada para trabajo rápido y de gran volumen, mientras que Sol encaja con las tareas más difíciles. Elige Luna por rendimiento y coste, y Sol por profundidad. En la generación actual, GPT-6 Luna tiene un precio de lista de $0.10 / $0.50 por millón de tokens.
¿Merece la pena GPT-5.6 Sol?
GPT-5.6 Sol es la generación anterior. Para proyectos nuevos, GPT-6.1 Sol es el modelo Sol actual de OpenAI, a $2 / $10 por millón de tokens con contexto corto, o $1.60 / $8 en PoYo en toda su ventana de contexto. GPT-5.6 Sol sigue siendo una buena opción para las integraciones que ya están ajustadas a él.
¿Es Claude Fable 5.2 mejor que GPT-6.1 Sol?
Para la máxima capacidad, la elección es Fable 5.2: puntúa entre 10 y 19 puntos más en todos los niveles de esfuerzo del Artificial Analysis Intelligence Index. Por coste, la elección es GPT-6.1 Sol: cuesta una cuarta parte por token y, con el esfuerzo máximo, aproximadamente una vigésima parte por tarea del índice.
¿Cuál es más barato, Fable 5.2 o GPT-6.1 Sol?
GPT-6.1 Sol. Los precios oficiales son $2 / $10 por millón de tokens de entrada/salida frente a $8 / $40 de Fable 5.2. Por encima de 272K tokens de entrada, OpenAI sube Sol a $4 / $15 en toda la solicitud, mientras que Fable se mantiene en $8 / $40. En PoYo, Sol se mantiene en $1.60 / $8 con cualquier longitud de prompt.
¿Cuál es mejor para programar?
Los dos proveedores publican sus resultados de programación en benchmarks distintos. Anthropic indica que Fable 5.2 alcanza un 49.1% en FrontierCode 2.0, por delante de GPT-6 Astra, y OpenAI diseñó GPT-6.1 Sol para la programación compleja a una quinta parte del precio por token de Astra. Una opción predeterminada sensata es Sol para la programación rutinaria a gran escala y Fable 5.2 para los cambios grandes y de larga duración. Prueba ambos con una muestra de tus propias tareas.
¿Tienen ambos modelos una ventana de contexto de 1M?
Sí, aproximadamente. Fable 5.2 tiene una ventana de 1M tokens. GPT-6.1 Sol tiene una ventana de 1.050.000 tokens con hasta 922.000 tokens de entrada. Ambos escriben hasta 128K tokens de salida por solicitud.