Model icon
grok-4.7
Modèle:
Grok 4.7 est disponible sur PoYo via /v1/chat/completions. Utilisez l’identifiant grok-4.7. Par million de tokens : entrée $1.6, sortie $4.8, lecture du cache $0.4. Les prix de base représentent 80 % des tarifs officiels standard.
Chat

Ce Playground est fourni à titre de démonstration. Les données ne sont valides que dans la fenêtre actuelle et seront effacées lors de l'actualisation.

Saisissez un message...

Configuration
1.0
1.0
Détails des tarifs

Paiement à l'usage. Sans abonnement ni frais cachés.

1 crédit = $0.005
ModèleEntrée /1M tokensLecture du cache /1M tokensSortie /1M tokens
Grok 4.7
100K tokens d'entrée + 20K tokens de sortie : $0.256
$1.60/1M tokens
320 crédits/1M tokens
$2.00/1M tokens-20 %
$0.400/1M tokens
80 crédits/1M tokens
$0.500/1M tokens-20 %
$4.80/1M tokens
960 crédits/1M tokens
$6.00/1M tokens-20 %
Mode de facturation: Les tokens d'entrée et de sortie sont facturés séparément, par 1M tokens.

La facturation se base sur le résultat final.

GROK 4.7 · DISPONIBLE

Codage agentique de pointe, flux de travail de connaissance sur plusieurs heures et raisonnement avec contexte long de 256K

API Grok 4.7 : codage agentique de pointe et travail de connaissance

Grok 4.7 est l’intelligence de pointe de nouvelle génération de SpaceXAI (xAI), conçue spécifiquement pour le codage agentique, l’automatisation de terminal et le travail professionnel de connaissance à long horizon. Basé sur une nouvelle architecture fondamentale considérablement plus grande avec un apprentissage par renforcement approfondi sur des tâches complexes de plusieurs heures, Grok 4.7 dépasse les évaluations à invite unique pour offrir une exécution fiable sur des sessions développeur prolongées.

Grok 4.7 est disponible sur PoYo via /v1/chat/completions. Utilisez l’identifiant grok-4.7. Par million de tokens : entrée $1.6, sortie $4.8, lecture du cache $0.4. Les prix de base représentent 80 % des tarifs officiels standard.

Fonctionnalités clés de l’API Grok 4.7

Le codage autonome via terminal, l’auto-vérification native et le raisonnement avec contexte long de 256K offrent des performances d’agent fiables pour les tâches d’ingénierie de plusieurs heures.

01

API Grok 4.7 pour le terminal autonome et le codage agentique

Les agents de codage autonomes rencontrent souvent des difficultés avec les outils en ligne de commande, les environnements d’exécution des tests et les échecs complexes de compilation en plusieurs étapes. Grok 4.7 représente une avancée majeure dans les benchmarks de codage agentique, avec un score de 38.0% sur Terminal-Bench 4.0 (+17.7 points par rapport à Grok 4.6) et de 71.0% sur DeepSWE v1.1. Les développeurs et les équipes d’ingénierie peuvent automatiser des migrations complexes sur plusieurs fichiers, exécuter des suites de tests de bout en bout et résoudre des problèmes à l’échelle d’un dépôt avec une fiabilité durable.

  • Score de 38.0% sur Terminal-Bench 4.0 (+17.7 pts d’amélioration)
  • Atteint 71.0% sur DeepSWE v1.1 pour le codage à l’échelle d’un dépôt
  • Pilote une exécution persistante en ligne de commande et un codage en plusieurs étapes
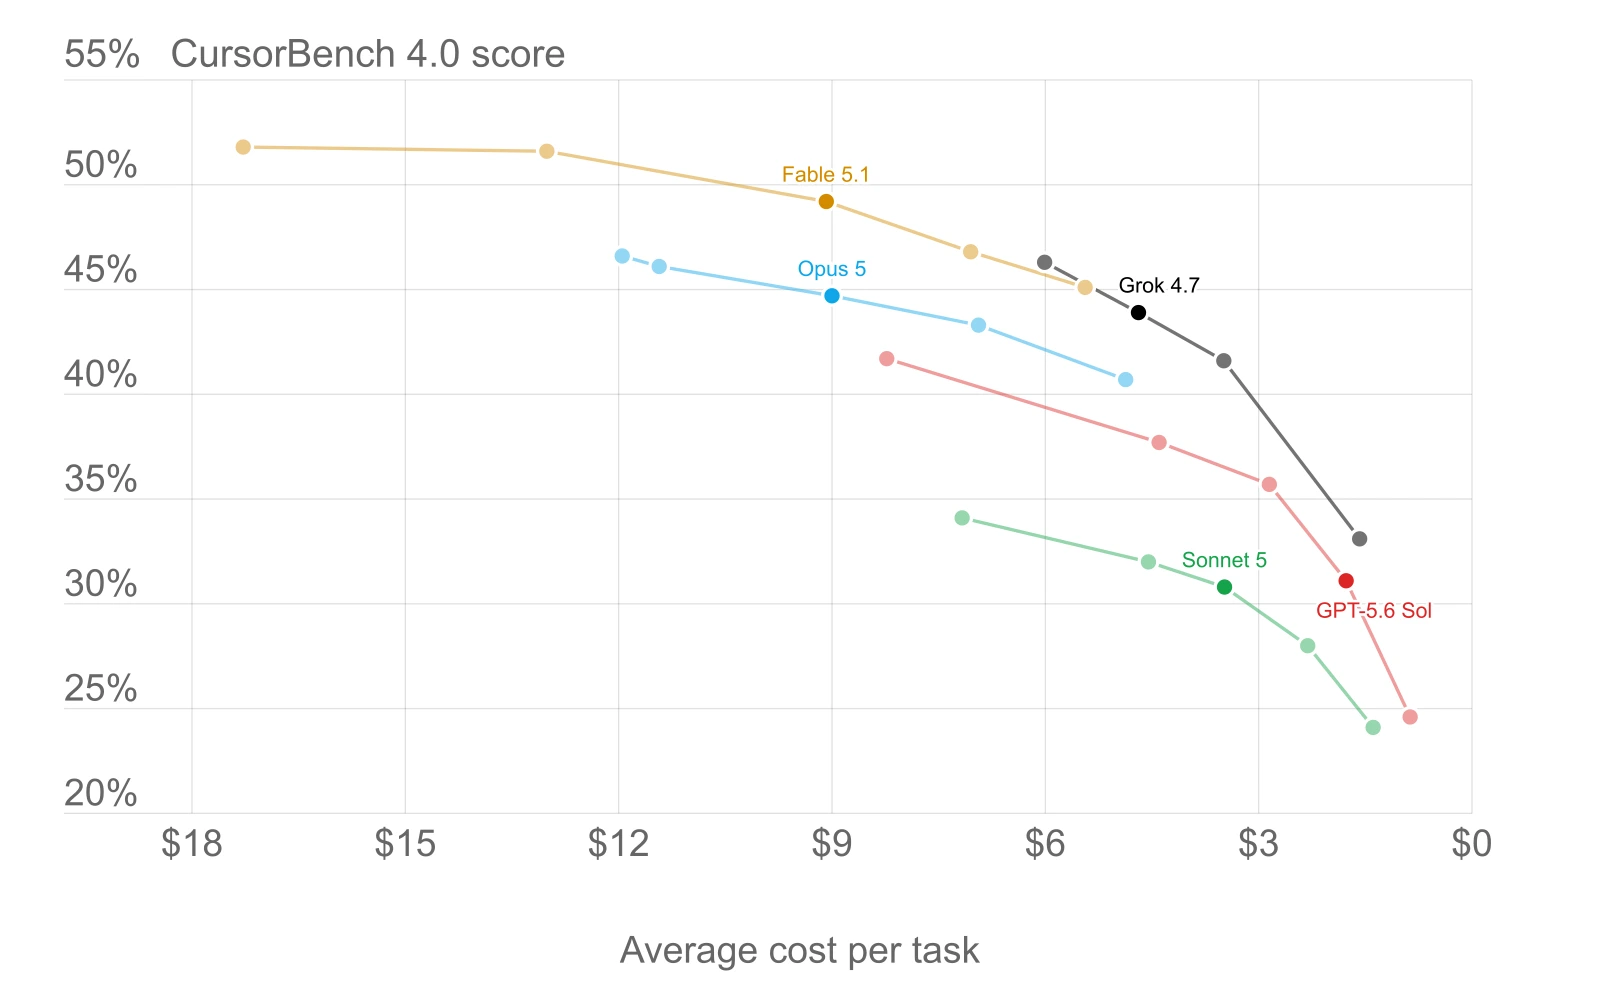
Graphique officiel du benchmark xAI CursorBench 4.0

02

API Grok 4.7 pour l’auto-vérification en temps réel et les tâches fiables

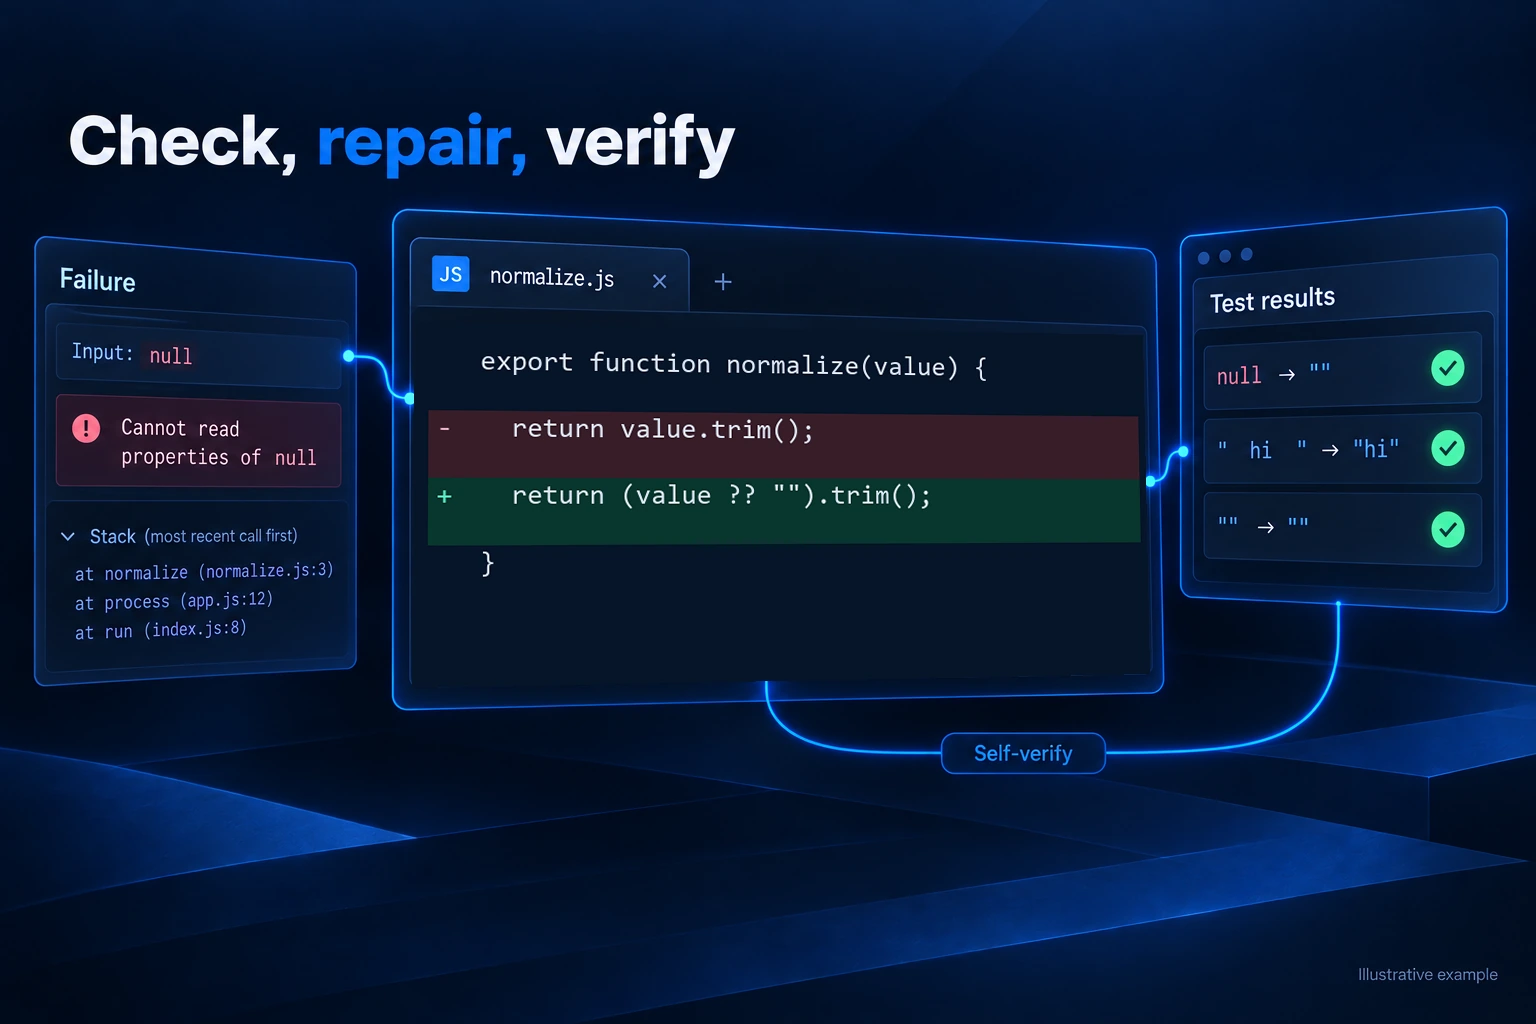
Les pipelines de raisonnement complexes se dégradent souvent au cours de longues sessions multi-tours en raison de l’accumulation d’erreurs et d’hallucinations. Grok 4.7 intègre des mécanismes natifs d’auto-vérification directement entraînés dans son cycle d’apprentissage par renforcement, détectant et corrigeant ses propres défauts logiques en temps réel. Cela garantit une génération de code fiable et une exécution cohérente de tâches sur plusieurs heures sans supervision manuelle.

  • Les boucles natives d’auto-vérification détectent les erreurs pendant la génération
  • Réduit considérablement les dérives logiques et les erreurs cumulées
  • Maintient une précision constante lors des sessions professionnelles de plusieurs heures
Détection, correction et nouvelle vérification d’une même erreur

03

API Grok 4.7 pour l’analyse de bases de code à l’échelle d’un dépôt et le travail de connaissance

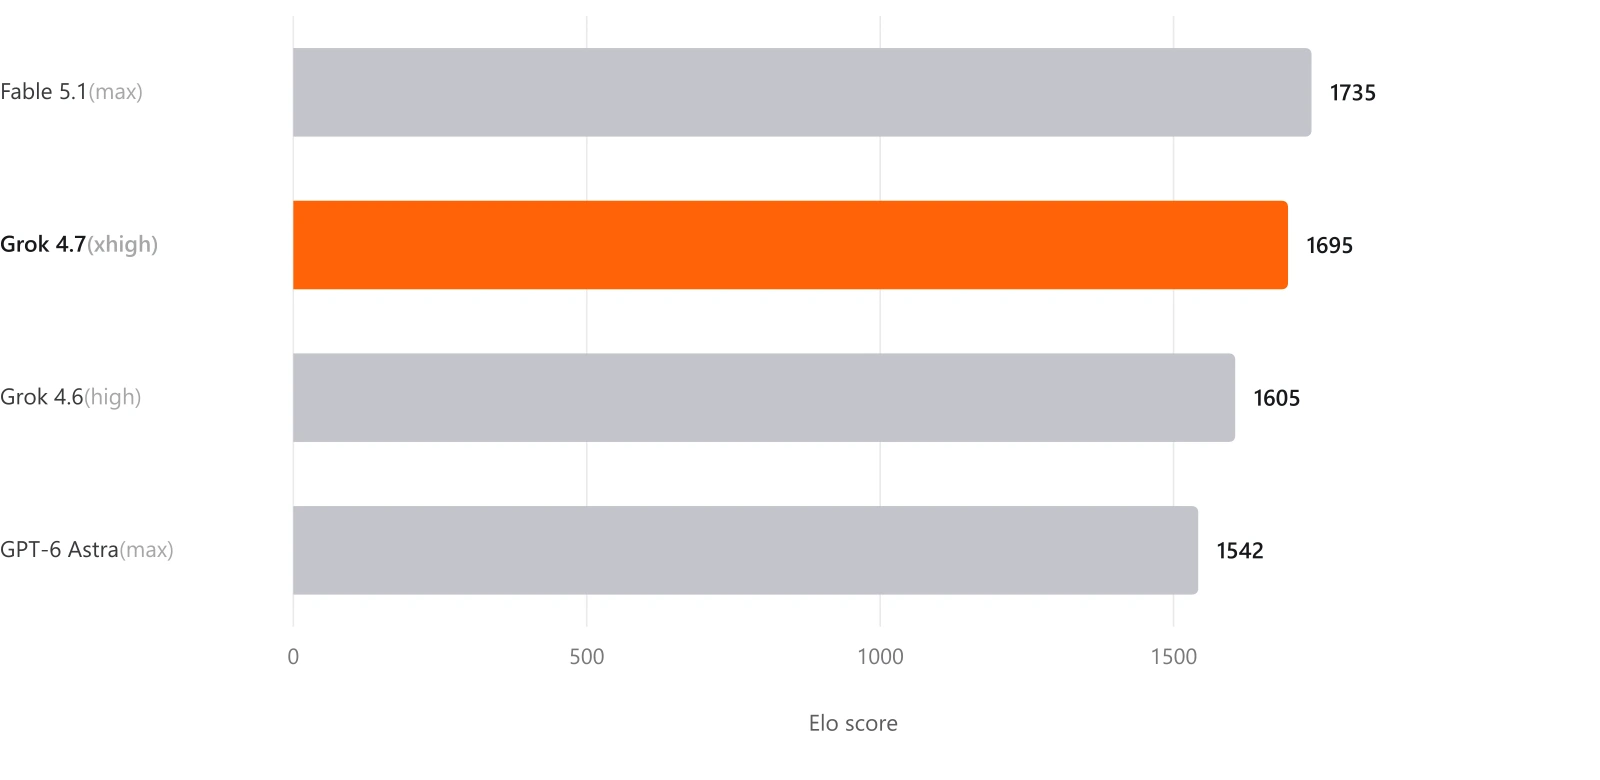
Les pipelines de récupération fragmentés perdent souvent les dépendances architecturales entre fichiers lors du traitement de vastes bases de code d’entreprise ou de documents techniques denses. Grok 4.7 fournit une fenêtre de contexte standard de 256K tokens avec une prise en charge jusqu’à 500K tokens, combinée à une compréhension multimodale native du texte, des diagrammes et du code. Les équipes peuvent inspecter des dépôts complets, synthétiser une documentation étendue et conserver l’état complet d’un projet dans une seule invite.

  • Traite jusqu’à 256,000 tokens en standard, extensible à 500K
  • Conserve une mémoire approfondie entre fichiers dans de vastes dépôts
  • Analyse de manière fluide des documentations techniques et des schémas complexes
Graphique officiel du benchmark xAI GDPval

04

API Grok 4.7 pour les flux de travail natifs multi-outils et le raisonnement dynamique

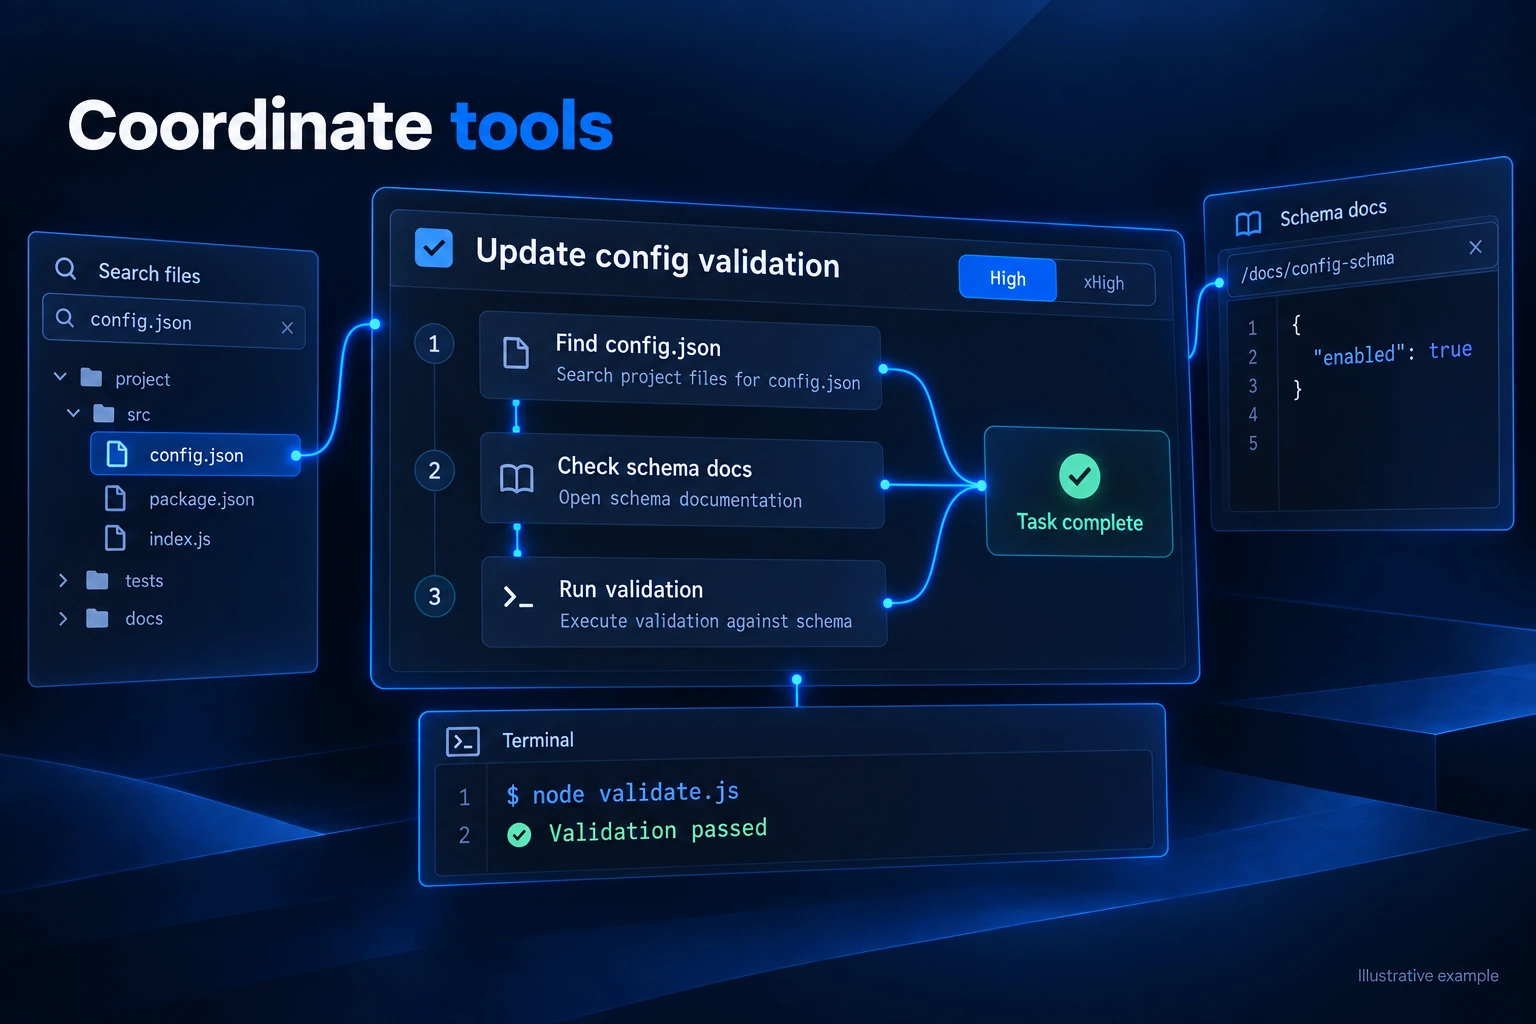
Les flux de travail agentiques modernes nécessitent une coordination fluide entre la manipulation de fichiers, la recherche web, l’exécution shell et une intensité de raisonnement variable. Grok 4.7 est optimisé nativement pour les frameworks d’agents conversationnels avec invocation d’outils intégrée. Les développeurs peuvent basculer dynamiquement entre l’effort High (standard) et l’effort xHigh pour une profondeur maximale sur les problèmes d’ingénierie et mathématiques les plus difficiles.

  • Entraîné nativement pour le framework d’agent conversationnel Grok Bot
  • Configurez les niveaux d’effort de raisonnement High (par défaut) et xHigh
  • Orchestrez la recherche de fichiers, l’exécution shell, la recherche web et la génération de code
Recherche de fichiers, vérification des sources et exécution shell avec High et xHigh

Qui peut bénéficier de l’API Grok 4.7 ?

01

Équipes d’ingénierie logicielle

Déployez des agents de codage autonomes capables d’effectuer des refactorisations à l’échelle d’un dépôt, de diagnostiquer des bugs complexes répartis sur plusieurs fichiers, de générer des suites de tests complètes et de réviser des pull requests avec une cohérence de premier niveau.

02

Développeurs d’agents autonomes

Créez des agents multi-tours robustes qui utilisent les outils natifs du framework Grok Bot, la recherche de fichiers et l’auto-vérification pour exécuter des workflows autonomes de plusieurs heures sans perdre l’alignement avec les objectifs de la tâche.

03

Ingénieurs matériel et électricité

Exploitez le score révolutionnaire de 64.0% obtenu par Grok 4.7 sur EEBench pour réviser des schémas de circuits électriques complexes, vérifier les spécifications des composants et automatiser les calculs techniques d’ingénierie.

04

Spécialistes de la recherche juridique et technique

Synthétisez des cadres réglementaires complexes, analysez des contrats multipartites avec les benchmarks Harvey Legal Agent (19.6%) et traitez des centaines de pages de recherche dans un contexte de 256K.

05

Équipes DevOps et d’automatisation système

Automatisez les diagnostics serveur, les pipelines de déploiement et les opérations terminal à l’aide de la capacité Terminal-Bench de Grok 4.7, leader avec 38.0%, pour exécuter en toute sécurité des environnements shell multi-étapes.

06

Développeurs full-stack et créateurs de produits

Prototyppez rapidement des applications complètes, transformez des spécifications en composants frontend et backend testés, et validez les fonctionnalités produit de bout en bout dans des environnements de développement comme Cursor.

Grok 4.7 vs Grok 4.6 — Comparaison des modèles

Grok 4.7 apporte des avancées générationnelles par rapport à Grok 4.6 en matière de codage agentique, d’automatisation du terminal, d’auto-vérification et de stabilité des sessions de plusieurs heures, au même niveau de prix.

CapacitéGrok 4.7Grok 4.6
Fondation de l’architectureNouveau modèle fondamental plus grand + RL étenduArchitecture de référence Grok 4.6
Fenêtre de contexte256K standard / jusqu’à 500K tokens128K – 256K tokens
Terminal-Bench 4.038.0% (+17.7 pts)20.3%
Benchmark de codage DeepSWE v1.171.0% (+5.8 pts)65.2%
EEBench (Génie électrique)64.0% (+11.0 pts)53.0%
Auto-vérification et correctionAuto-vérification native entraînée via RLVérification basique multi-tours
Intégration du framework d'agentFramework de bot Grok natif et appels d'outilsAppels de fonctions standard
Modes de raisonnementNiveau High (par défaut) et niveaux d'effort xHighNiveau d'effort unique

Les métriques de benchmark reflètent les publications techniques officielles de xAI et les évaluations publiques à compter du septembre 2026. PoYo propose un accès unifié avec une facturation à l'utilisation.

Comment intégrer l'API Grok 4.7 sur PoYo

Créez une clé API PoYo, ajoutez des crédits et envoyez une requête avec le point de terminaison et l’identifiant ci-dessous.

Grok 4.7 est disponible sur PoYo via /v1/chat/completions. Utilisez l’identifiant grok-4.7.

Créer une clé API → · Ajouter des crédits → · Voir la documentation →

Questions fréquentes sur l'API Grok 4.7

Qu'est-ce que Grok 4.7 et qui l'a développé ?

Grok 4.7 est le modèle phare de pointe de SpaceXAI (xAI), officiellement publié le 21 septembre 2026. Il est optimisé pour le codage agentique à long horizon, le raisonnement en plusieurs étapes, l'exécution de terminal et les tâches professionnelles nécessitant des connaissances spécialisées.

Comment Grok 4.7 se compare-t-il à Grok 4.6 ?

Grok 4.7 représente une mise à niveau architecturale générationnelle plutôt qu'un correctif incrémentiel. Il intègre un nouveau modèle de base plus volumineux, un apprentissage par renforcement étendu sur des tâches de plusieurs heures, une augmentation massive de +17.7 points sur Terminal-Bench 4.0 (38.0%), ainsi que des mécanismes natifs d'auto-vérification.

Quelle est la fenêtre de contexte de Grok 4.7 ?

Grok 4.7 propose une fenêtre de contexte standard de 256,000 tokens, avec un niveau étendu capable de traiter jusqu'à 500,000 tokens pour une analyse complète de bases de code et la synthèse de documents volumineux.

Comment fonctionnent les niveaux d'effort de raisonnement (High vs xHigh) ?

Grok 4.7 utilise par défaut un effort High pour un équilibre entre rapidité et profondeur de raisonnement. Pour les défis les plus exigeants en mathématiques, en génie électrique et en refactorisation architecturale, les développeurs peuvent spécifier xHigh afin d'allouer davantage de calcul et une exploration plus approfondie.

Quels appels d'outils et capacités d'agent sont pris en charge ?

Grok 4.7 comprend nativement le framework de bot Grok, prenant en charge l'exécution d'outils tels que la recherche de fichiers d'espace de travail, la lecture/modification de code, l'exécution de commandes shell, les recherches web et les sorties structurées.

Quelles sont les performances de Grok 4.7 dans les IDE de codage comme Cursor ?

Grok 4.7 est reconnu comme un modèle de codage agentique de premier plan dans Cursor et Grok Build, excellant dans le maintien de la concentration sur des flux de travail complexes de plusieurs heures, la vérification automatisée des tests et les corrections persistantes de bugs.

Grok 4.7 prend-il en charge les entrées multimodales ?

Oui. Grok 4.7 prend en charge les entrées texte et image (vision), permettant aux développeurs de transmettre des schémas d'architecture, des maquettes d'interface utilisateur et des schémas techniques avec les instructions.

Grok 4.7 est-il disponible sur PoYo ?

Grok 4.7 est disponible sur PoYo via /v1/chat/completions. Utilisez l’identifiant grok-4.7.

Combien coûte Grok 4.7 sur PoYo ?

Par million de tokens : entrée $1.6, sortie $4.8, lecture du cache $0.4. Les prix de base représentent 80 % des tarifs officiels standard.

Pourquoi utiliser PoYo pour l'accès à l'API Grok 4.7

01

Intelligence de codage agentique de pointe

Obtenez des informations précoces et un accès rapide aux principaux benchmarks Terminal-Bench 4.0 et DeepSWE de Grok 4.7, conçus pour les flux de travail de développement autonomes haut de gamme.

02

API unifiée & haute concurrence

Intégrez Grok 4.7 aux côtés des modèles d'OpenAI, Anthropic et Google avec une seule clé API, une syntaxe compatible avec OpenAI et une disponibilité de niveau entreprise.

03

Contexte de 256K & coordination multi-outils

Exploitez des fenêtres de contexte complètes de 256K et des appels d'outils d'agent persistants avec une latence optimisée, un streaming fiable et une documentation technique complète.

04

Facturation transparente à l'utilisation

Éliminez les abonnements fixes coûteux. Rechargez à la demande et payez uniquement pour les jetons exacts consommés par vos applications en production.