Model icon
omnihuman-2.0
Image to Video
Audio to Video
Talking Avatar
Voir plus de modèles ByteDance
Modèle:
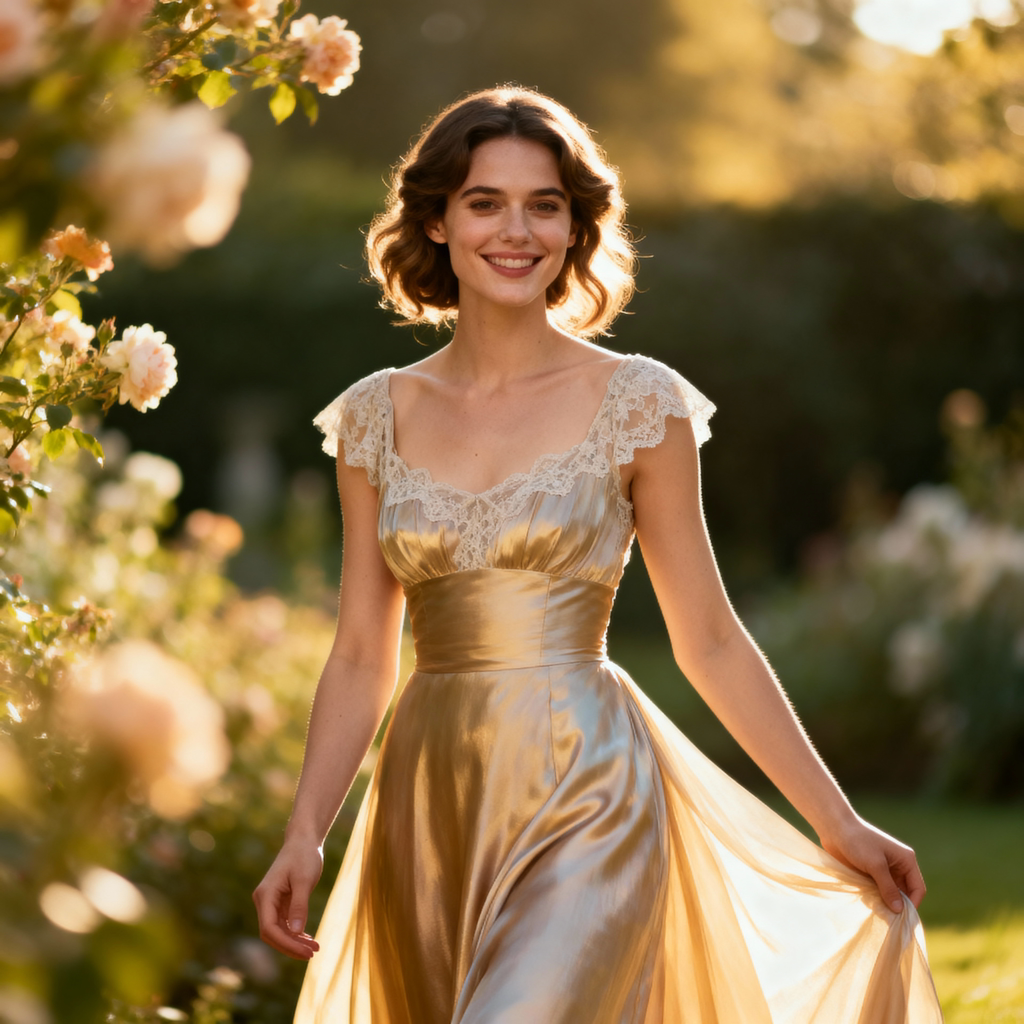
Utilisez l'API OmniHuman 2.0 sur PoYo pour transformer une image et une piste audio en une vidéo 720p dans laquelle le sujet parle, chante ou se produit. Le modèle piloté par l'audio de ByteDance gère la synchronisation labiale, les émotions du visage, les gestes et les mouvements du corps, prend en charge des prises uniques jusqu'à 5 minutes et fonctionne avec des personnes, des animaux et des personnages stylisés.

Input

Added 1/1

Drop files here, paste files, or add a URL. Required. Exactly one character image. JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC or HEIF, up to 30 MB; 300–6,000 px per side and an aspect ratio between 0.4 and 2.5.

Image Urls 1
——
Added 1/1

Drop files here, paste files, or add a URL. Required. One WAV or MP3 voice, song or dialogue track, 4–300 seconds and up to 15 MB. The video length follows the audio.

Audio Url 1
1 · 11.0s

Output

Exemple de sortie

Ceci est un exemple de données. Générez un nouveau résultat pour voir la sortie réelle.

ID de tâche:G60QLE8QQ1VJG4W9Créé:2026-10-17T17:23:10
Statut:finishedProgression:100%
Détails des prix

Tarification transparente, sans frais cachés. Payez à l'usage.

ByteDanceomnihuman-2.0
720p
Prix PoYo
$0.105/s
21 crédits
Prix officiel
-
Économie
-

* Les frais réels sont basés sur la sortie finale.

OMNIHUMAN 2.0

Une image et une piste audio deviennent une vidéo qui parle et qui chante

API OmniHuman 2.0 pour des vidéos d'avatar pilotées par l'audio

OmniHuman 2.0 de ByteDance anime une seule photo avec votre voix, un dialogue ou une chanson. Il reproduit le rythme, le ton et l'émotion de l'audio, ajoute des gestes naturels et garde le personnage stable sur de longues prises. Sur PoYo, vous ne payez que les secondes de vidéo générées.

Modèle OmniHuman 2.0 sur PoYo

01

OmniHuman 2.0 image + audio vers vidéo

Utilisez omnihuman-2.0 avec exactement une image dans image_urls et un fichier WAV ou MP3 dans audio_url. L'audio doit durer entre 4 et 300 secondes et ne pas dépasser 15MB. Ajoutez un prompt facultatif pour diriger les actions, les éléments de la scène et les mouvements de caméra. La sortie est en 720p et dure aussi longtemps que l'audio.

Fonctionnalités clés de l'API OmniHuman 2.0

Les exemples officiels d'OmniHuman 2.0 illustrent l'interprétation émotionnelle, la synchronisation labiale, les dialogues à plusieurs, le chant et les personnages non humains. Activez le son pour écouter l'audio d'origine.

01

Voix, ton et émotion fidèles

OmniHuman 2.0 suit le rythme, l'intonation et le ressenti de l'audio au lieu de se contenter de bouger les lèvres. Les expressions du visage, les mouvements de tête et le langage corporel accompagnent l'interprétation, si bien que les monologues dramatiques comme les explications posées paraissent naturels.

  • Expressions et gestes guidés par l'audio
  • Pauses, respiration et intonations naturelles
  • Prompt facultatif pour diriger les actions et la caméra

02

Synchronisation labiale précise pour tout personnage

La forme de la bouche reste alignée sur chaque syllabe, même pour des personnages non humains. Animaux, mascottes de dessin animé, figures 3D et illustrations stylisées peuvent parler ou chanter tout en conservant leur design d'origine.

  • Mouvements de bouche précis à la syllabe près
  • Fonctionne avec des photos, des illustrations et des personnages 3D
  • Préserve l'apparence d'origine de l'image fournie

03

Conversations à plusieurs personnes

À partir d'une image comportant plusieurs personnes, OmniHuman 2.0 peut mettre en scène une conversation naturelle : la personne qui parle s'exprime pendant que les autres écoutent et réagissent. Idéal pour les interviews, les sketchs et les scènes de dialogue, sans assembler de clips séparés.

  • Plusieurs personnages dans un même cadre
  • Les auditeurs réagissent pendant que l'un parle
  • Scène et éclairage de l'image source préservés

04

Chant et longues prises jusqu'à 5 minutes

OmniHuman 2.0 accepte un audio allant jusqu'à 300 secondes, de quoi couvrir une chanson entière, une leçon ou une présentation de produit en une seule génération. Les performances chantées suivent la mélodie avec une respiration, une expression et un rythme corporel cohérents.

  • Audio de 4 secondes à 5 minutes
  • Chant synchronisé avec la mélodie et le rythme
  • Une prise continue, sans raccords

05

Animaux et personnages stylisés

Donnez une voix aux mascottes, aux animaux de compagnie et aux personnages animés. OmniHuman 2.0 adapte les mouvements du visage à l'anatomie de chaque personnage, pour qu'un raton laveur ou un héros de dessin animé parle avec des expressions crédibles.

  • Visages d'animaux et de créatures
  • Styles dessin animé, anime et 3D
  • Idéal pour les mascottes de marque et le storytelling

À qui s'adresse l'API OmniHuman 2.0 ?

01

Éducation et formation

Transformez des cours enregistrés et des narrations en vidéos avec présentateur. La prise en charge des audios longs permet de couvrir des explications complètes en une seule prise, et un formateur constant crée de la familiarité tout au long d'un cours.

02

Marketing et e-commerce

Créez des vidéos de porte-parole, des démonstrations de produits et des publicités localisées à partir d'une seule photo. Changez l'audio pour produire des versions dans différentes langues avec le même présentateur.

03

Musique et divertissement

Produisez des performances chantées, des vidéos de paroles et des sketchs de personnages. OmniHuman 2.0 suit la mélodie et le rythme, ce qui le rend adapté aux reprises, aux artistes virtuels et au divertissement en format court.

04

Présentateurs virtuels et humains numériques

Animez un présentateur virtuel, un avatar de service client ou un ambassadeur de marque avec une parole et des gestes naturels pour vos sites web, applications et réseaux sociaux.

05

Mascottes et personnages animés

Donnez vie à des animaux de compagnie, des mascottes et des personnages illustrés pour vos campagnes, contenus jeunesse et récits, sans animation traditionnelle.

06

Développeurs et plateformes créatives

Ajoutez la génération d'avatars pilotés par l'audio à votre produit grâce à l'API asynchrone de PoYo, avec suivi des tâches, callbacks et facturation à la seconde.

OmniHuman 2.0 vs OmniHuman 1.5

OmniHuman 2.0 conserve le principe d'OmniHuman 1.5, une image et une piste audio, et fait passer une prise unique de moins d'une minute à 5 minutes. En contrepartie, la résolution baisse : OmniHuman 2.0 produit du 720p, tandis qu'OmniHuman 1.5 propose aussi le 1080p.

FonctionnalitéOmniHuman 2.0 sur PoYoOmniHuman 1.5
Entrées1 image + 1 piste audio + prompt facultatif1 image + 1 piste audio + prompt facultatif
Durée maximale audio et vidéo4–300 secondes (jusqu'à 5 minutes)Moins de 60 secondes en 720p ; moins de 30 secondes en 1080p
Résolution de sortie720p720p ou 1080p
Contrôle par promptFacultatif ; guide les actions, les éléments de scène et les mouvements de caméraFacultatif ; guide les actions, les objets et les mouvements de caméra
Scènes à plusieurs personnesPris en chargePris en charge
ChantPris en chargePris en charge
Personnages non humainsAnimaux de compagnie, personnages de dessin animé et d'animeAnimaux, personnages anthropomorphes et dessins animés

La colonne OmniHuman 2.0 indique les paramètres acceptés par PoYo. La colonne OmniHuman 1.5 s'appuie sur la page du projet OmniHuman 1.5 de ByteDance, la page produit BytePlus et la documentation de l'API fal. Pour les deux modèles, la vidéo dure aussi longtemps que l'audio fourni.

Comment utiliser l'API OmniHuman 2.0 sur PoYo

Étape 1 : Inscrivez-vous et créez une clé API.
Connectez-vous à PoYo et créez une clé d'accès pour votre application.
Obtenir une clé API →

Étape 2 : Rechargez vos crédits.
Ajoutez des crédits à votre compte. Le Playground estime les crédits à partir de la durée de votre audio avant la génération.
Ajouter des crédits →

Étape 3 : Intégrez l'API.
Envoyez model: "omnihuman-2.0" avec image_urls, audio_url et un prompt facultatif à /api/generate/submit, puis interrogez l'ID de la tâche ou fournissez une URL de callback.
Voir la référence de l'API →

Questions fréquentes sur l'API OmniHuman 2.0

Qu'est-ce que l'API OmniHuman 2.0 ?

OmniHuman 2.0 est le modèle de génération vidéo piloté par l'audio de ByteDance. À partir d'une image et d'un fichier audio, il génère une vidéo du sujet qui parle, chante ou se produit, avec une synchronisation labiale, des émotions et des gestes cohérents. Sur PoYo, utilisez l'ID de modèle omnihuman-2.0.

Quel est le prix d'OmniHuman 2.0 ?

OmniHuman 2.0 coûte 21 crédits ($0.105) par seconde de vidéo générée. Le Playground estime le coût à partir de la durée de l'audio avant l'envoi, et le montant final est basé sur la durée réelle de la vidéo produite. Par exemple, une vidéo de 10 secondes coûte environ 210 crédits.

Quels fichiers audio sont pris en charge ?

audio_url accepte un fichier WAV ou MP3 d'une durée de 4 à 300 secondes et ne dépassant pas 15MB. La vidéo générée a la même durée que l'audio : une piste de 2 minutes produit donc une vidéo de 2 minutes.

Quelles images donnent les meilleurs résultats ?

Envoyez exactement une image dans image_urls. Les photos nettes, bien éclairées et aux visages visibles donnent les résultats les plus fiables. ByteDance indique les formats JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC et HEIF, jusqu'à 30MB, avec des côtés compris entre 300 et 6000 pixels et un rapport d'aspect compris entre 0.4 et 2.5.

Que contrôle le prompt ?

Le prompt est facultatif. Utilisez-le pour décrire les actions, les éléments de la scène et les mouvements de caméra, par exemple « Elle sourit et désigne le produit d'un geste, avec un lent travelling avant. » Les mouvements des lèvres et l'émotion continuent de suivre l'audio.

Peut-il animer des animaux, des dessins animés ou plusieurs personnes ?

Oui. OmniHuman 2.0 prend en charge les personnes, les animaux, les personnages stylisés et 3D, ainsi que les images comportant plusieurs personnes. Sur les images à plusieurs personnes, le modèle met en scène la conversation pour que les intervenants et les auditeurs réagissent naturellement.

Quelle résolution OmniHuman 2.0 produit-il ?

OmniHuman 2.0 produit des vidéos en 720p. Le cadrage suit votre image d'entrée : recadrez donc l'image selon la composition souhaitée avant l'envoi.

Puis-je utiliser les vidéos générées à des fins commerciales ?

Consultez les conditions applicables du modèle et de la plateforme avant toute utilisation commerciale. Assurez-vous d'avoir l'autorisation d'utiliser l'image de la personne ainsi que la voix ou la musique de l'audio, et signalez le contenu généré par IA lorsque c'est requis.

Pourquoi utiliser PoYo pour accéder à l'API OmniHuman 2.0

01

Paiement à la seconde générée

Aucun abonnement ni minimum. Vous payez les secondes de vidéo produites, et le Playground affiche une estimation avant l'envoi.

02

Testez avec vos propres médias

Importez une image et un fichier audio dans le Playground, ajoutez un prompt et examinez la requête JSON exacte avant l'intégration.

03

Une seule API pour de nombreux modèles

Utilisez la même authentification et le même flux de tâches pour OmniHuman 2.0, Kling Avatar 2.0 et d'autres modèles vidéo, image et audio sur PoYo.

04

Suivez les tâches ou recevez des callbacks

Interrogez l'ID de la tâche ou fournissez une URL de callback, puis récupérez la vidéo finale via le même flux asynchrone.