
01
표현력 있는 다국어 Text-to-Speech
스크립트, 제품 문구, 내레이션, 대화를 자연스러운 오디오로 변환합니다. 지원 모델은 목소리, 언어, 감정 태그, 텍스트 정규화, 속도, 타임스탬프를 제공합니다.
- 텍스트 스크립트에서 보이스오버 생성
- 지원 시 언어, 목소리, 전달 방식을 제어
- 앱, 영상, 강의, 에이전트용 음성 제작
음성과 음악 제작을 위한 완전한 오디오 생성기 사용에 대한 전체 가이드
PoYo 오디오 생성기는 음성, 보이스오버, 음악 생성 모델을 하나의 집중된 워크스페이스에 모읍니다. ElevenLabs, Gemini, xAI, MiniMax 등 실행 가능한 오디오 모델을 Input 패널에서 바로 선택할 수 있습니다.
각 모델은 고유 설정을 유지하므로 언어, 목소리, 감정 태그, 속도, 가사, 인스트루멘털 모드, 출력 형식, 미리보기, JSON 응답, 다운로드가 지원되는 경우에만 표시됩니다.
음성, 보이스오버, 음악을 생성하고 미리보기, 다운로드, API 검증까지 이어갑니다.
01
스크립트, 제품 문구, 내레이션, 대화를 자연스러운 오디오로 변환합니다. 지원 모델은 목소리, 언어, 감정 태그, 텍스트 정규화, 속도, 타임스탬프를 제공합니다.
02
프롬프트, 가사, 인스트루멘털 설정, 구조화된 작곡 아이디어로 음악을 만듭니다. 데모, 후크, 배경 트랙, 창작 방향 탐색에 적합합니다.
03
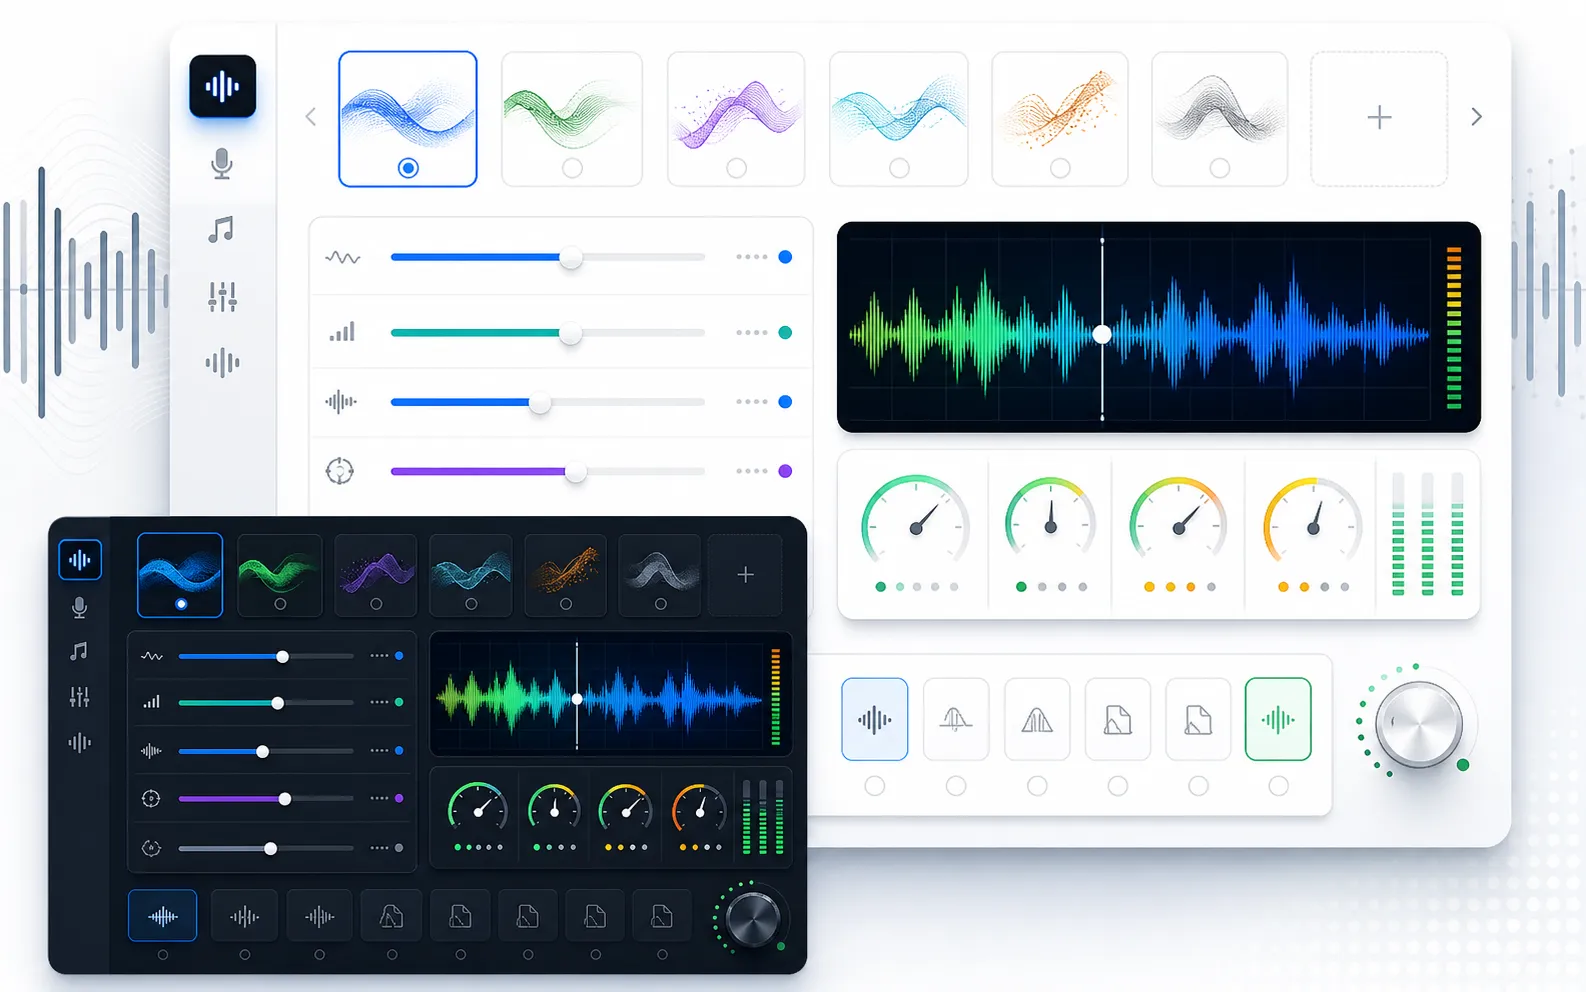
오디오 모델 패밀리를 전환해도 각 모델의 기본 제어를 유지합니다. 빠른 TTS, 표현력 있는 음성, 음악 생성, 샘플레이트, 비트레이트, 출력 형식이 활성 모델에 맞춰 표시됩니다.
04
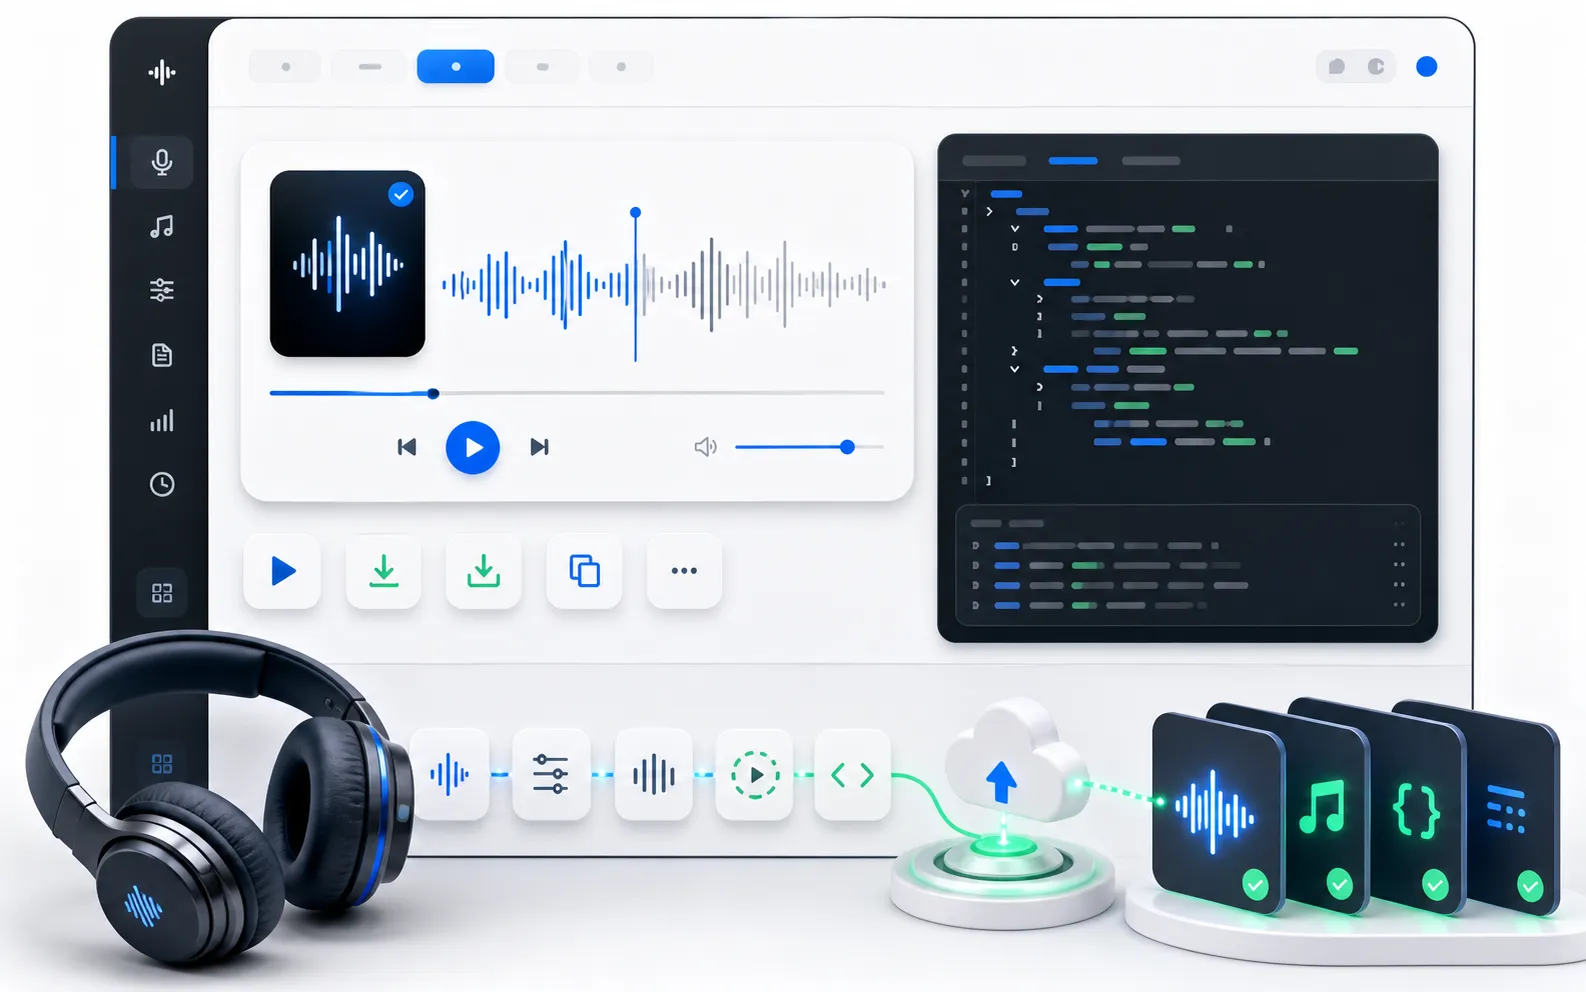
생성된 오디오를 브라우저에서 듣고, JSON과 타임스탬프를 확인하며, 최종 파일을 다운로드한 뒤 API 또는 에이전트 워크플로로 옮길 수 있습니다.
스크립트에서 제품 설명, 짧은 영상, 튜토리얼, 다국어 더빙 초안을 생성합니다.
강의 음성, 챕터 미리듣기, 팟캐스트 세그먼트, 긴 내레이션 테스트를 만듭니다.
앱 음성, 온보딩 내레이션, 읽기 보조형 오디오, 현지화된 음성 경험을 프로토타입합니다.
프롬프트, 가사, 스타일 방향으로 곡 아이디어, 배경 트랙, 후크, 데모를 만듭니다.
캐릭터 목소리, 게임 UI 사운드, 크리에이터 에셋, 인터랙티브 오디오 콘셉트를 탐색합니다.
API 제품에 통합하기 전에 프롬프트, 목소리, 형식, 미리보기, JSON 응답을 검증합니다.
1. Input 패널에서 오디오 모델을 선택합니다. 음성 또는 음악 워크플로에 맞는 제공자와 실행 모델을 선택하세요.
2. 텍스트, 가사, 음악 방향을 추가합니다. 스크립트, 프롬프트, 언어, 목소리 스타일, 무드, 악기, 가사를 입력합니다.
3. 모델별 설정을 조정합니다. 목소리, 감정 태그, 속도, 샘플레이트, 비트레이트, 형식, 가사 최적화, 인스트루멘털 모드를 설정합니다.
4. 실행, 미리보기, 다운로드합니다. 생성을 제출하고 오디오를 들어본 뒤 필요한 경우 JSON을 확인하고 파일을 다운로드합니다.
선택한 모델에 따라 Text-to-Speech, 보이스오버, 내레이션, 대화, 음악 데모, 노래, 인스트루멘털을 만들 수 있습니다. Input 패널은 활성 모델이 지원하는 필드만 보여줍니다.
표현력 있는 보이스오버는 ElevenLabs V3 TTS, 빠른 음성 테스트는 ElevenLabs TTS Turbo v2.5 또는 xAI TTS 1, 스타일 지시형 음성은 Gemini 3.1 Flash TTS, 구조화된 음악은 ElevenLabs Music, 프롬프트와 가사 워크플로는 MiniMax Music 2.6, 범용 음악 생성은 Generate Music으로 시작하세요.
품질은 모델, 프롬프트, 언어, 목소리, 출력 설정에 따라 달라집니다. 최신 TTS는 매우 자연스럽지만 실제 사용 전에는 청취 검수, 발음 수정, 속도 확인, 마스터링이 필요할 수 있습니다.
모델이 지원하면 가능합니다. 음성 모델은 언어, 목소리, 속도, 안정성, 스타일, 감정 태그, 타임스탬프를 제공할 수 있고 음악 모델은 장르, 무드, 가사, 인스트루멘털, 구조, 형식을 제공할 수 있습니다.
갤러리는 일반적인 오디오 파일을 브라우저에서 재생합니다. 제공자 응답에 따라 MP3, WAV, OGG, Opus, PCM, mu-law, A-law, 타임스탬프 또는 보조 파일이 포함될 수 있습니다.
깔끔한 스크립트, 발음 힌트, 구체적인 목소리 방향, 자연스러운 속도, 절제된 감정 태그를 사용하세요. 음악은 장르, 무드, 템포, 악기, 보컬, 구조, 가사, 피해야 할 요소를 명확히 쓰세요.
모델, 텍스트 길이, 길이, 형식, 음악 길이, 품질 설정, 제공자에 따라 달라집니다. 긴 내레이션이나 음악을 실행하기 전 Input 하단의 현재 모델 비용을 확인하세요.
상업적 사용은 모델, 제공자 약관, 계정 플랜, 스크립트, 가사, 목소리, 참조 및 업로드 자료의 권리에 따라 달라집니다. 관련 약관을 확인하세요.
프롬프트를 다시 만들지 않고 음성, 목소리, 음악 모델을 비교합니다.
각 모델의 목소리, 언어, 스타일, 가사, 형식, 결과 흐름을 유지합니다.
다운로드 전에 Output Gallery에서 생성 오디오를 바로 들어봅니다.
스크립트, 프롬프트, 목소리, 형식, JSON을 테스트한 뒤 API 제품으로 이동합니다.