GROK 4.7 · 곧 출시 예정

프런티어 에이전트 코딩, 멀티시간 지식 워크플로 및 256K 장문 컨텍스트 추론

Grok 4.7 API: 프런티어 에이전트 코딩 및 지식 작업

Grok 4.7은 SpaceXAI의 (xAI) 차세대 프런티어 인텔리전스로, 에이전트 코딩, 터미널 자동화 및 장기 전문 지식 작업을 위해 특별히 설계되었습니다. 복잡한 멀티시간 작업에 대한 광범위한 강화 학습과 함께 새롭고 크게 확장된 기반 아키텍처를 바탕으로 구축된 Grok 4.7은 단일 프롬프트 평가를 넘어 장시간 개발자 세션 전반에서 신뢰할 수 있는 실행을 제공합니다.

Grok Bot 하니스에 대한 기본 이해, 강력한 자체 검증 루프, 표준 256K 컨텍스트(500K까지 확장 가능)를 갖춘 Grok 4.7은 곧 통합 고동시성 API 엔드포인트를 통해 PoYo에서 사용할 수 있게 되며—대기 목록 없이 프런티어 추론을 제공합니다.

Grok 4.7 API의 주요 기능

자율 터미널 코딩, 기본 제공 자체 검증 및 256K 장문 컨텍스트 추론으로 멀티시간 엔지니어링 작업 전반에서 안정적인 에이전트 성능을 제공합니다.

01

자율 터미널 및 에이전트 코딩을 위한 Grok 4.7 API

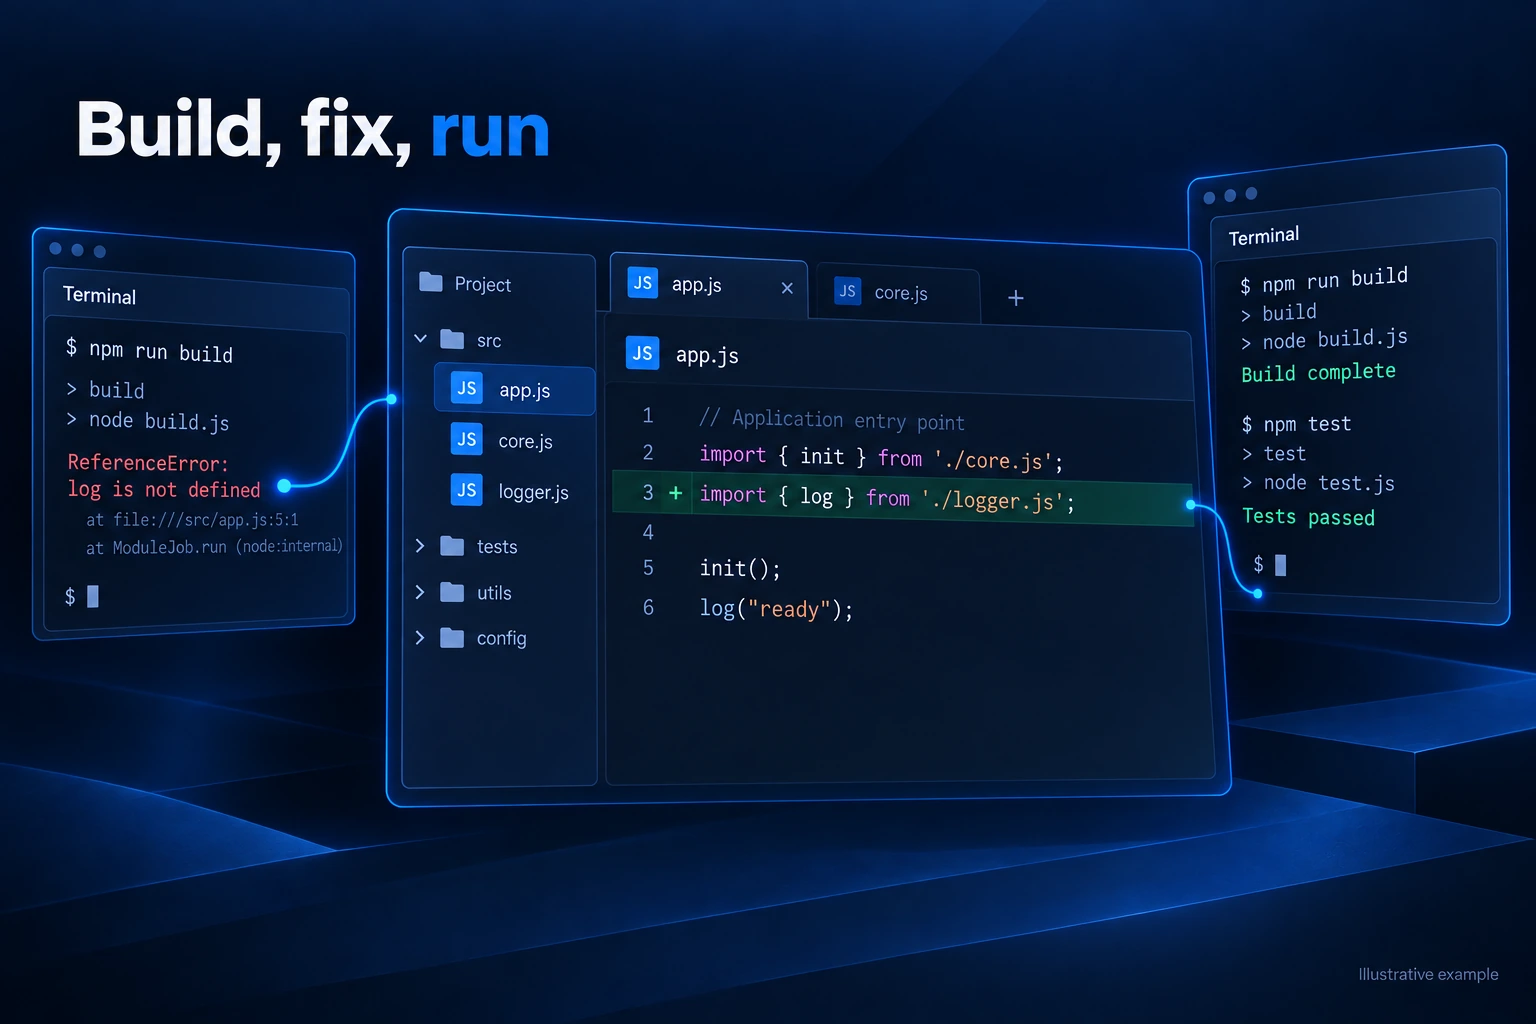
자율 코딩 에이전트는 명령줄 도구, 테스트 실행 환경 및 복잡한 다단계 빌드 실패 문제를 자주 마주합니다. Grok 4.7은 에이전트 코딩 벤치마크에서 큰 도약을 보여주며, Terminal-Bench 4.0에서 38.0% (+Grok 4.6 대비 +17.7점)를 기록하고 DeepSWE v1.1에서 71.0%를 달성합니다. 개발자와 엔지니어링 팀은 복잡한 다중 파일 마이그레이션을 자동화하고, 엔드투엔드 테스트 스위트를 실행하며, 저장소 규모의 문제를 지속적인 정확도로 해결할 수 있습니다.

  • Terminal-Bench 4.0에서 38.0% 점수 달성 (+17.7 포인트 향상)
  • 저장소 규모 코딩을 위한 DeepSWE v1.1에서 71.0% 달성
  • 지속적인 다단계 명령줄 및 코딩 실행 지원
빌드 실패, 코드 수정, 재빌드 성공 과정

02

실시간 자체 검증 및 신뢰할 수 있는 작업을 위한 Grok 4.7 API

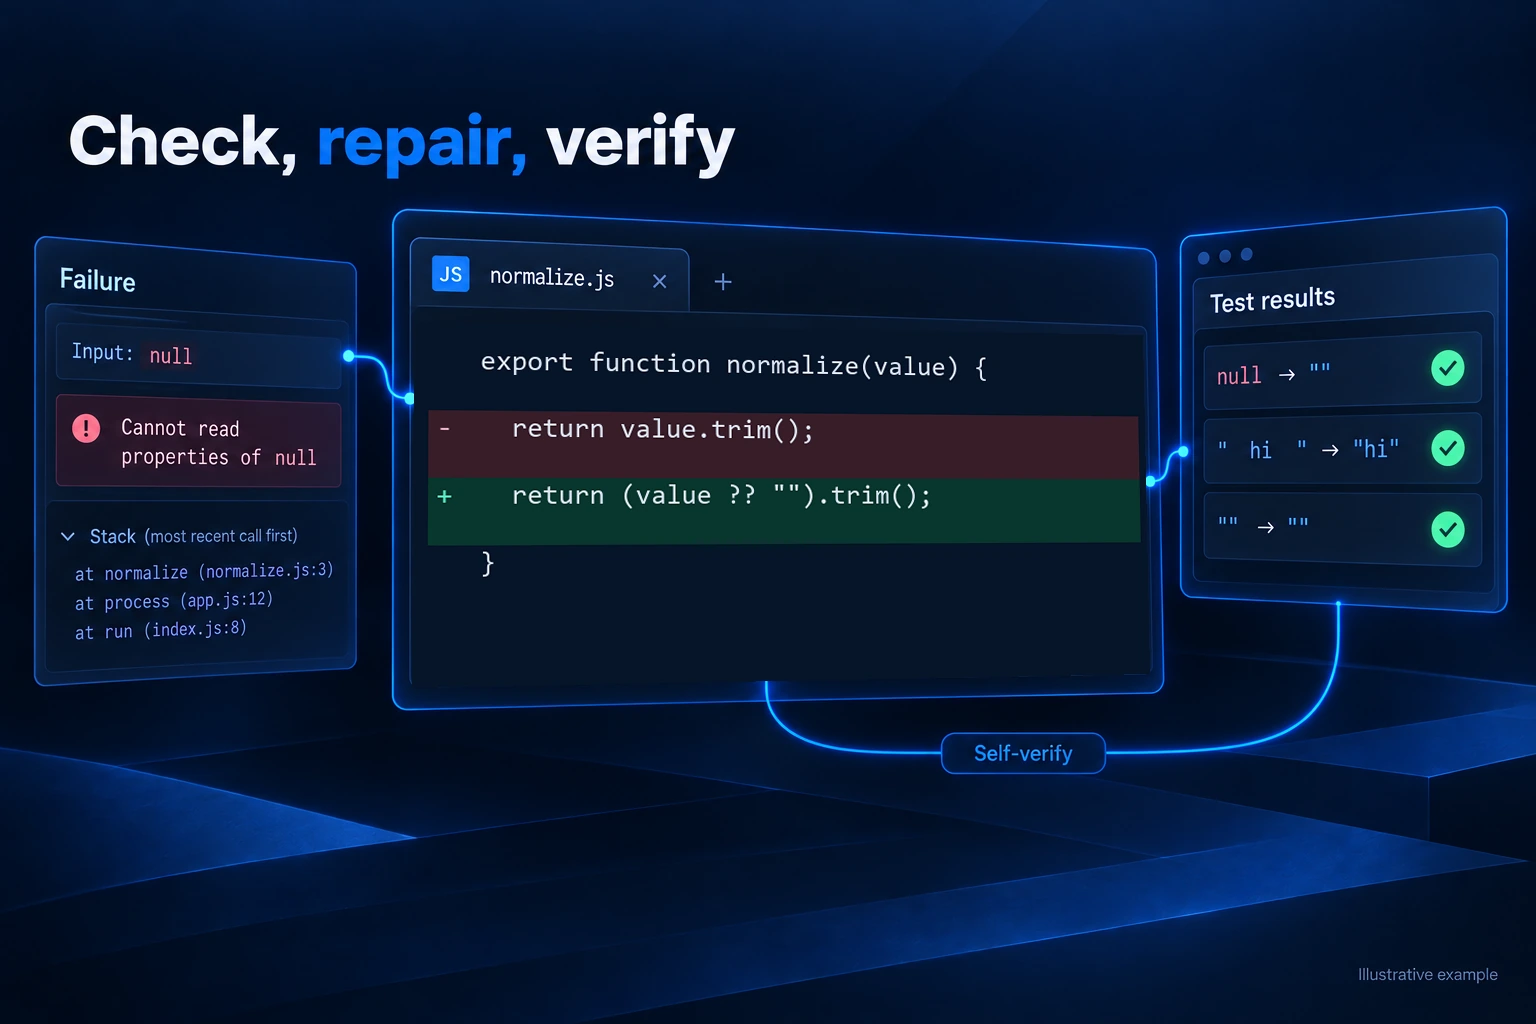
복잡한 추론 파이프라인은 누적 오류와 환각으로 인해 긴 다중 턴 세션에서 성능이 저하되는 경우가 많습니다. Grok 4.7은 강화 학습 주기에 직접 학습된 기본 자체 검증 메커니즘을 통합하여, 실시간으로 자체 논리적 결함을 찾아 수정합니다. 이를 통해 수동 감독 없이도 안정적인 코드 생성과 일관된 멀티시간 작업 실행을 보장합니다.

  • 기본 제공 자체 검증 루프로 생성 중 오류 감지
  • 논리적 흐름 이탈 및 누적 오류 대폭 감소
  • 멀티시간 전문 세션 전반에서 일관된 정확도 유지
같은 오류를 발견하고 수정한 뒤 다시 검증하는 과정

03

저장소 규모 코드베이스 분석 및 지식 작업을 위한 Grok 4.7 API

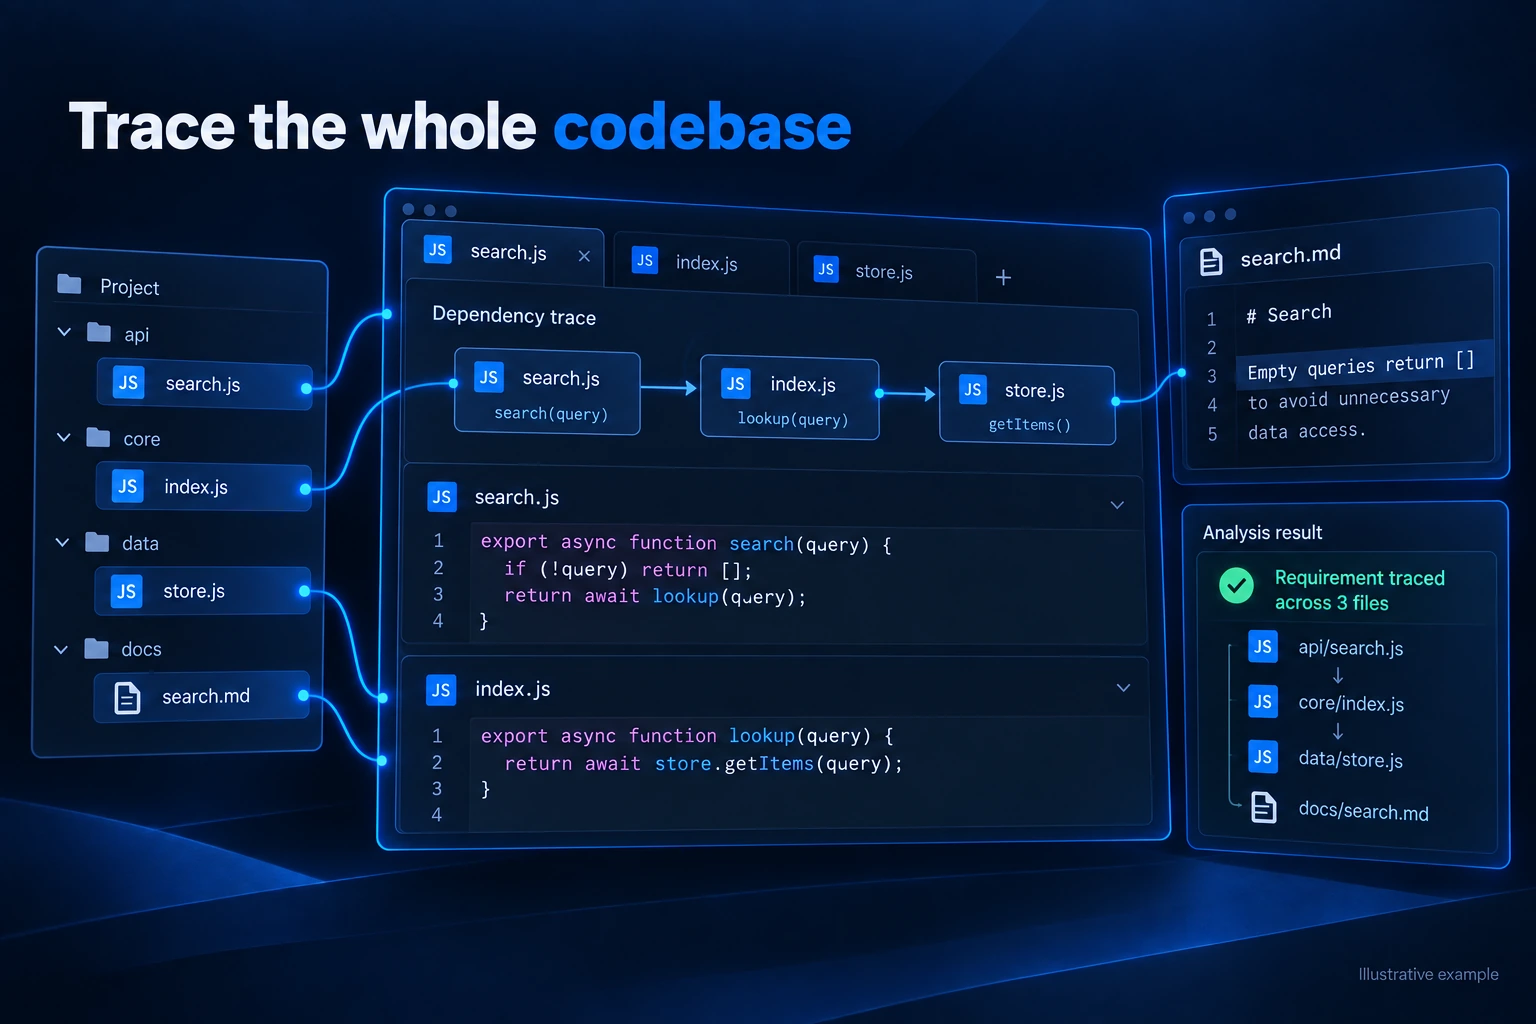
대규모 엔터프라이즈 코드베이스나 방대한 기술 문헌을 처리할 때 단편화된 검색 파이프라인은 종종 파일 간 아키텍처 종속성을 놓칩니다. Grok 4.7은 텍스트, 다이어그램 및 코드에 대한 기본 멀티모달 이해와 결합된 표준 256K 토큰 컨텍스트 창을 제공하며 최대 500K 토큰까지 지원합니다. 팀은 전체 저장소를 검사하고, 광범위한 문서를 종합하며, 단일 프롬프트에서 완전한 프로젝트 상태를 유지할 수 있습니다.

  • 표준 최대 256,000 토큰 처리, 500K까지 확장 가능
  • 대규모 저장소 전반에서 깊은 파일 간 기억 유지
  • 복잡한 기술 문서 및 설계도를 원활하게 분석
파일 간 의존성과 기술 문서 분석

04

기본 멀티도구 워크플로 및 동적 추론을 위한 Grok 4.7 API

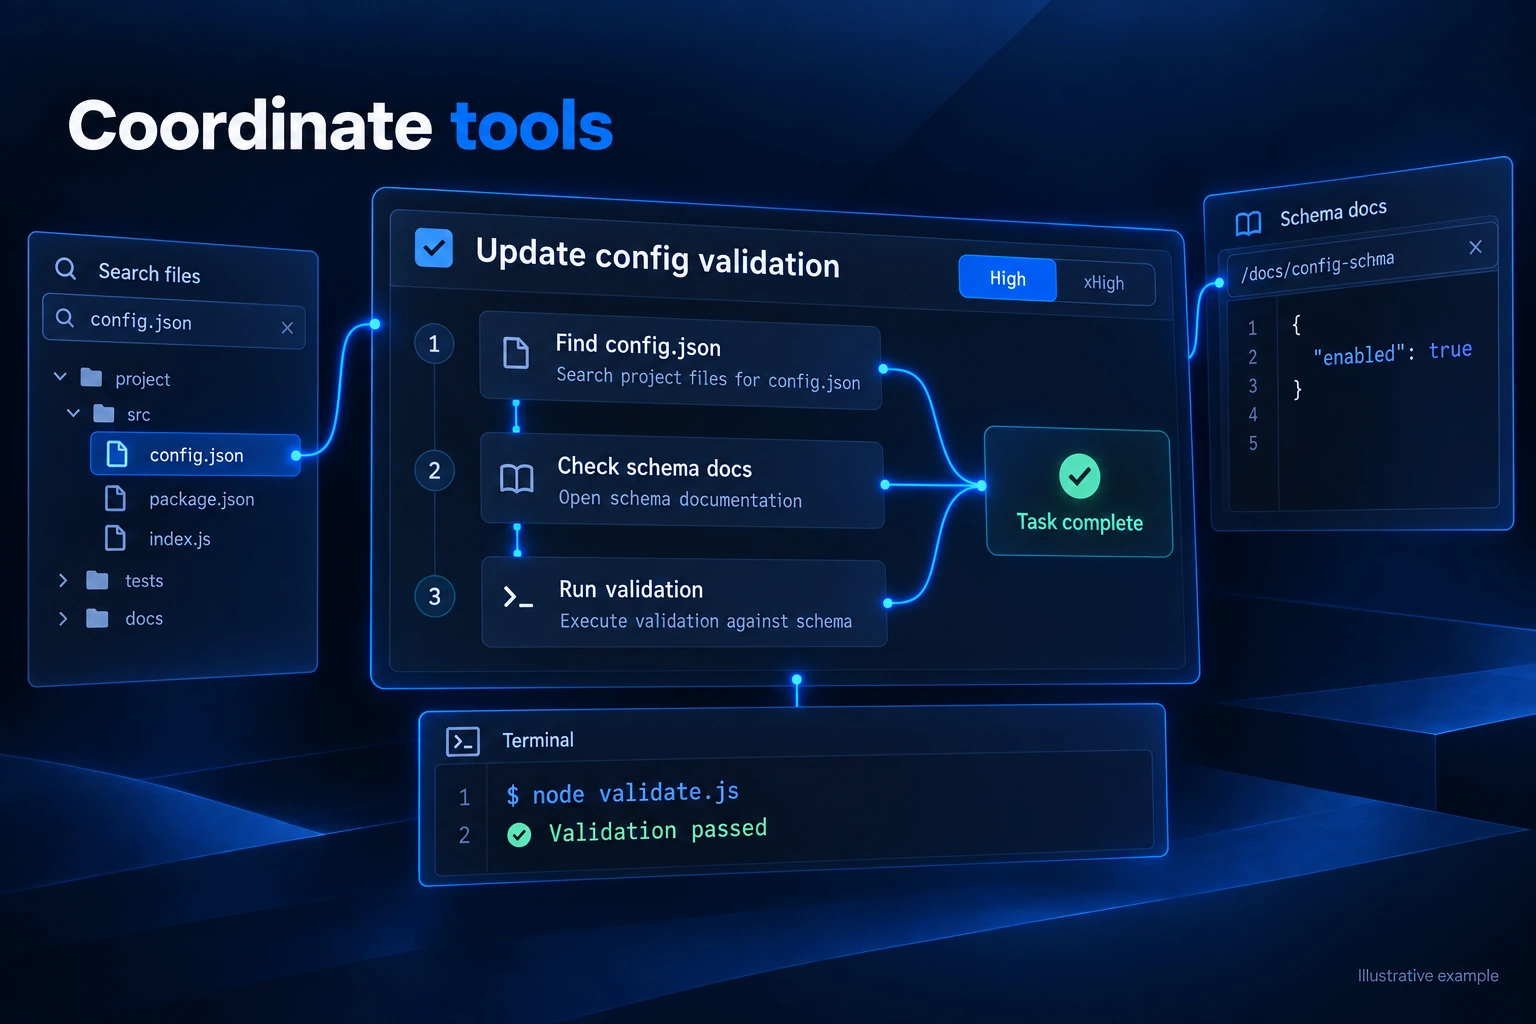
현대적인 에이전트 워크플로는 파일 조작, 웹 검색, 셸 실행 및 가변 추론 강도 간의 원활한 조정이 필요합니다. Grok 4.7은 기본 제공 도구 호출 기능을 갖춘 대화형 에이전트 하니스에 맞게 기본 최적화되었습니다. 개발자는 가장 까다로운 엔지니어링 및 수학 문제에서 최대 깊이를 위해 High effort(표준)와 xHigh effort 사이를 동적으로 전환할 수 있습니다.

  • Grok Bot 대화형 에이전트 하니스를 위해 기본 학습
  • High(기본값) 및 xHigh 추론 노력 단계 구성
  • 파일 검색, 셸 실행, 웹 조회 및 코드 생성을 조율
파일 검색, 출처 확인, 셸 실행 및 High·xHigh 설정

Grok 4.7 API의 혜택을 받을 수 있는 사용자는 누구인가요?

01

소프트웨어 엔지니어링 팀

자율 코딩 에이전트를 배포하여 저장소 전체 리팩터링 수행, 여러 파일에 걸친 복잡한 버그 진단, 포괄적인 테스트 스위트 생성, 최고 수준의 일관성을 갖춘 풀 리퀘스트 검토를 수행할 수 있습니다.

02

자율 에이전트 개발자

네이티브 Grok Bot 하네스 도구, 파일 검색, 자체 검증 기능을 활용하여 작업 정렬성을 잃지 않고 수 시간 동안 자율 워크플로를 실행하는 견고한 멀티턴 에이전트를 구축할 수 있습니다.

03

하드웨어 및 전기 엔지니어

Grok 4.7의 EEBench 64.0%라는 획기적인 점수를 활용하여 복잡한 전기 회로 설계를 검토하고, 부품 사양을 검증하며, 기술 엔지니어링 계산을 자동화할 수 있습니다.

04

법률 및 기술 연구 전문가

복잡한 규제 프레임워크를 종합하고, Harvey Legal Agent 벤치마크(19.6%)를 사용하여 다자간 계약을 분석하며, 256K 컨텍스트에서 수백 페이지의 연구 자료를 처리할 수 있습니다.

05

DevOps 및 시스템 자동화 팀

Grok 4.7의 선도적인 38.0% Terminal-Bench 성능을 활용하여 서버 진단, 배포 파이프라인, 터미널 작업을 자동화하고 멀티스텝 셸 환경을 안전하게 실행할 수 있습니다.

06

풀스택 및 제품 개발자

완전한 애플리케이션을 빠르게 프로토타이핑하고, 사양을 테스트된 프론트엔드 및 백엔드 구성 요소로 변환하며, Cursor와 같은 개발자 환경에서 엔드투엔드 제품 기능을 검증할 수 있습니다.

Grok 4.7 vs Grok 4.6 — 모델 비교

Grok 4.7은 동일한 가격 등급에서 에이전트 코딩, 터미널 자동화, 자체 검증 및 수 시간 세션 안정성 측면에서 Grok 4.6을 뛰어넘는 세대적 도약을 제공합니다.

기능Grok 4.7Grok 4.6
아키텍처 기반새로운 더 큰 기반 모델 + 확장된 RLGrok 4.6 기본 아키텍처
컨텍스트 창256K 표준 / 최대 500K 토큰128K – 256K 토큰
Terminal-Bench 4.038.0% (+17.7 포인트)20.3%
DeepSWE v1.1 코딩 벤치마크71.0% (+5.8 포인트)65.2%
EEBench (전기 공학)64.0% (+11.0 포인트)53.0%
자체 검증 및 수정RL을 통해 학습된 기본 자체 검증 기능기본 다중 턴 검증
에이전트 하네스 통합기본 Grok Bot 하네스 및 도구 호출표준 함수 호출
추론 모드High (기본값) 및 xHigh 연산 노력 단계단일 연산 노력 단계

벤치마크 지표는 2026년 9월 기준 공식 xAI 기술 릴리스 및 공개 평가를 반영합니다. PoYo는 종량제 결제를 통한 통합 액세스를 제공합니다.

PoYo에서 Grok 4.7 API 통합하는 방법

1단계: 등록 및 API 키 생성
PoYo에 가입하고 몇 초 만에 온보딩 절차 없이 범용 API 키를 생성하세요.
API 키 생성 →

2단계: 크레딧 충전
계정에 크레딧을 추가하세요. 개발자 친화적인 요금으로 투명한 종량제 결제를 이용할 수 있습니다.
크레딧 추가 →

3단계: Grok 4.7 통합
표준 OpenAI 호환 SDK 또는 PoYo 클라이언트 라이브러리를 사용하여 모델 ID grok-4.7을 통해 Chat Completions 또는 Responses API 엔드포인트를 호출하세요.
문서 보기 →

Grok 4.7 API 자주 묻는 질문

Grok 4.7이란 무엇이며 누가 개발했나요?

Grok 4.7은 SpaceXAI's (xAI)의 최첨단 플래그십 모델로 2026년 9월 21일 공식 출시되었습니다. 장기 에이전트 코딩, 다단계 추론, 터미널 실행 및 전문 지식 작업에 최적화되었습니다.

Grok 4.7은 Grok 4.6과 어떻게 비교되나요?

Grok 4.7은 점진적인 패치가 아닌 세대별 아키텍처 업그레이드입니다. 새로운 대형 기본 모델, 여러 시간 동안 수행되는 작업에 대한 확장 강화 학습, Terminal-Bench 4.0에서의 대규모 +17.7 포인트 향상(38.0%), 그리고 기본 자체 검증 메커니즘을 제공합니다.

Grok 4.7의 컨텍스트 창은 어떻게 되나요?

Grok 4.7은 256,000 토큰의 표준 컨텍스트 창을 제공하며, 확장 단계에서는 최대 500,000 토큰을 처리하여 포괄적인 코드베이스 분석과 긴 문서 종합을 수행할 수 있습니다.

추론 노력 수준(High 대 xHigh)은 어떻게 작동하나요?

Grok 4.7은 균형 잡힌 속도와 추론 깊이를 위해 기본적으로 High 노력을 사용합니다. 가장 까다로운 수학, 전기 공학 및 아키텍처 리팩터링 과제에서는 개발자가 xHigh를 지정하여 확장된 컴퓨팅과 더 깊은 탐색을 할당할 수 있습니다.

어떤 도구 호출 및 에이전트 기능을 지원하나요?

Grok 4.7은 Grok Bot 하네스를 기본적으로 이해하며, 작업 공간 파일 검색, 코드 읽기/편집, 셸 명령 실행, 웹 검색 및 구조화된 출력과 같은 도구 실행을 지원합니다.

Cursor와 같은 코딩 IDE에서 Grok 4.7은 어떻게 작동하나요?

Grok 4.7은 Cursor와 Grok Build에서 뛰어난 에이전트 코딩 모델로 인정받고 있으며, 복잡한 여러 시간의 작업 흐름을 지속적으로 집중하고, 자동화된 테스트 검증과 지속적인 버그 수정을 수행하는 데 탁월합니다.

Grok 4.7은 멀티모달 입력을 지원하나요?

예. Grok 4.7은 텍스트 및 이미지 입력(비전)을 지원하여 개발자가 지침과 함께 아키텍처 다이어그램, UI 목업 및 설계도를 전달할 수 있습니다.

PoYo에서 Grok 4.7은 언제 이용할 수 있나요?

Grok 4.7은 현재 PoYo에서 출시 예정 준비 단계에 있습니다. xAI가 글로벌 타사 라우팅을 최종 조정하는 동안 PoYo는 대기 목록 없이 통합된 고동시성 API 액세스를 제공합니다.

PoYo를 통해 Grok 4.7 API를 사용하는 이유

01

최첨단 에이전트 코딩 인텔리전스

고급 자율 개발자 워크플로를 위해 설계된 Grok 4.7의 선도적인 Terminal-Bench 4.0 및 DeepSWE 벤치마크에 대한 조기 인사이트와 빠른 액세스를 확보하세요.

02

통합 API 및 고동시성

단일 API 키, OpenAI 호환 구문, 엔터프라이즈급 가동 시간을 통해 OpenAI, Anthropic, Google의 모델과 함께 Grok 4.7을 통합하세요.

03

256K 컨텍스트 및 멀티 도구 조정

최적화된 지연 시간, 안정적인 스트리밍, 포괄적인 기술 문서를 활용하여 전체 256K 컨텍스트 창과 지속적인 에이전트 도구 호출을 활용하세요.

04

투명한 사용량 기반 결제

비싼 고정 구독을 없애세요. 필요할 때 충전하고 프로덕션 애플리케이션에서 소비한 정확한 토큰만 결제하세요.