
Principais conclusões
- O Fable 5.2 serve para o trabalho mais difícil; o GPT-6.1 Sol serve para o trabalho de grande volume. No Artificial Analysis Intelligence Index, o Fable 5.2 obtém 65 e o GPT-6.1 Sol 55 com esforço máximo, e o Sol conclui cada tarefa do índice por uma fração do custo.
- Preços oficiais por token: $8 / $40 por milhão de tokens de entrada/saída no Fable 5.2 e $2 / $10 no Sol em contexto curto, uma diferença de 4×.
- Uma tarifa única na PoYo. A OpenAI sobe o pedido inteiro do Sol para $4 / $15 acima de 272K tokens de entrada. Na PoYo, o GPT-6.1 Sol custa $1.60 / $8 em toda a sua janela de contexto, e o Fable 5.2 custa $6.40 / $32 em toda a sua janela de 1M.
- O Fable 5.2 dedica mais raciocínio a cada tarefa. A Artificial Analysis mediu $26.54 por tarefa do índice no Fable 5.2 com esforço máximo e $1.27 no Sol.
- O Fable 5.2 chega depressa a pontuações fortes. Com esforço
lowobtém 54, perto dos 55 do Sol emmax, e conclui uma tarefa do índice em 5,8 minutos, contra 23,3. - Pesquisaste “GPT-5.6 Sol vs Fable 5”? Esse foi o confronto de julho de 2026. Ambas as linhas evoluíram entretanto; a secção abaixo trata do par antigo à parte.
Claude Fable 5.2 vs GPT-6.1 Sol num relance
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Programador | Anthropic | OpenAI |
| ID do modelo na API | claude-fable-5-2 | gpt-6.1-sol |
| Lançamento | 9 de novembro de 2026 | 29 de setembro de 2026 |
| Posição | Nível de topo da Anthropic, acima do Opus | Nível Sol da OpenAI, entre o GPT-6 Astra e o GPT-6 Luna |
| Janela de contexto | 1M tokens | 1 050 000 tokens (entrada máxima de 922 000) |
| Saída máxima | 128K tokens | 128K tokens |
| Entrada → saída | Texto e imagens → texto | Texto e imagens → texto |
| Controlo do raciocínio | output_config.effort | reasoning.effort |
| Níveis de esforço | De low a max, predefinido high | De low a max, predefinido medium |
| Data de corte do conhecimento | junho de 2026 | 30 de abril de 2026 |
| Entrada / saída oficial (por 1M) | $8 / $40 | $2 / $10 (entrada ≤272K) $4 / $15 (entrada >272K) |
| Leitura da cache oficial (por 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| Entrada / saída na PoYo (por 1M) | $6.40 / $32 | $1.60 / $8 |
| Endpoints da PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs Fable 5: que versões estás a comparar?
A maioria das páginas bem posicionadas para “GPT-5.6 Sol vs Fable 5” foi escrita em julho de 2026, quando esses dois eram os modelos mais recentes. Desde então, cada linha lançou versões mais novas:
| Modelo | Programador | Lançamento | Entrada / saída oficial no lançamento (por 1M, contexto curto) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9 de junho de 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9 de julho de 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1 de setembro de 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22 de setembro de 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29 de setembro de 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9 de novembro de 2026 | $8 / $40 |
GPT-5.6 Sol vs Claude Fable 5: o confronto de julho de 2026
No lançamento, o GPT-5.6 Sol custava metade do Fable 5 na entrada e 40% menos na saída ($5 / $30 vs $10 / $50, com a entrada em cache a $0.50 vs $1). Os testes independentes desse mês dividiram-se no veredicto:
| Teste | Configuração | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: três planos de design de sistemas | Kilo Code CLI, ambos com raciocínio Max, avaliados com uma rubrica escrita de antemão | Pontuação mais alta nas três tarefas, depois de rever e corrigir cada plano por conta própria; 52 min 53 s por plano em média; $13.57 no total | Planos que os testadores acharam mais fáceis de implementar; 15 min 27 s por plano em média; $12.02 no total |
| Composio: Golden Eval, 47 workflows de ferramentas com várias apps | Fable 5 no Claude Code; Sol no Codex CLI em high | 45 de 47 aprovados (95.7%); 223 779 tokens e 79.6 s por tarefa em média | 47 de 47 aprovados (100%); 276 957 tokens e 84.4 s por tarefa em média |
| Analytics Vidhya: app web, análise de dados, apresentação para investidores | Os mesmos prompts, chats novos, raciocínio predefinido | Qualidade comparável, com cerca do dobro do tempo de execução | Qualidade comparável e execuções mais rápidas; a escolha do autor para trabalho longo e complexo entregue de uma só vez |
O padrão em julho: o GPT-5.6 Sol adequava-se ao planeamento e à programação com um preço por token mais baixo e gastava tempo extra a verificar o próprio trabalho; o Fable 5 adequava-se a workflows longos com ferramentas e escrevia planos fáceis de implementar.
Esses resultados descrevem os modelos de julho, que são agora a geração anterior. Desde então, a diferença de preço alargou-se a favor do Sol: o Fable 5.2 custa 4× o GPT-6.1 Sol por token, quando o Fable 5 custava 2× o GPT-5.6 Sol na entrada e cerca de 1,7× na saída. O resto deste artigo compara o par atual. Na PoYo, o GPT-5.6 Sol está disponível através da Responses API para as integrações já afinadas para ele.
O que os dois modelos partilham e em que diferem
Em comum:
- Cerca de 1M tokens de contexto e 128K tokens de saída por pedido.
- Entrada de texto e imagens, saída de texto.
- Cinco níveis de esforço, de
lowamax. Cada fornecedor calibra os seus próprios níveis, por isso compara resultados e não rótulos. - Prompt caching, streaming e saídas estruturadas.
Diferenças:
- Esforço predefinido. O Fable 5.2 usa
highpor predefinição; o Sol usamedium. Define o esforço explicitamente nos testes lado a lado, para que ambos corram no nível que pretendes. - Controlos do raciocínio. O Fable 5.2 raciocina sempre de forma adaptativa e aceita
tool_choicecomautoounone. O Sol configura-se através dereasoning.effort, e as suas ferramentas alojadas (pesquisa na web, pesquisa de ficheiros, interpretador de código, shell alojada, apply patch, utilização do computador, MCP, pesquisa de ferramentas) funcionam através da Responses API da OpenAI. - Data de corte do conhecimento. Junho de 2026 no Fable 5.2; 30 de abril de 2026 no Sol.
- Retenção de dados. O Fable 5.2 funciona com retenção de dados de 30 dias na API da Anthropic.
Preços: 4× por token, 2× em prompts longos
Tarifas oficiais (USD por 1M tokens)
| Encargo | Claude Fable 5.2 | GPT-6.1 Sol, entrada ≤272K | GPT-6.1 Sol, entrada >272K |
|---|---|---|---|
| Entrada | $8.00 | $2.00 | $4.00 |
| Saída | $40.00 | $10.00 | $15.00 |
| Leitura da cache | $0.20 | $0.10 | $0.20 |
| Escrita na cache | $10 (5 min) / $16 (1 hora) | $2.50 (30 min) / $5.00 (12 horas) | $5.00 (30 min) / $10.00 (12 horas) |
A OpenAI cobra os prompts com mais de 272K tokens de entrada a 2× as tarifas de entrada e de cache e a 1,5× a tarifa de saída, no pedido inteiro. A Anthropic fatura toda a janela de 1M do Fable 5.2 às tarifas standard. Na PoYo, ambos os modelos usam uma tarifa única em toda a janela de contexto, por isso o GPT-6.1 Sol mantém-se a $1.60 / $8 seja qual for o comprimento do prompt. Para os preços de todos os modelos Claude, consulta o nosso guia de preços da API Claude.
Custo por pedido
Estes exemplos assumem que os dois modelos usam o mesmo número de tokens; a utilização real varia de modelo para modelo (vê a secção seguinte). Os encargos de escrita na cache ficam de fora em ambos.
| Cenário | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Resposta de chat: 20K de entrada + 4K de saída | Oficial: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Oficial: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Tarefa de programação: 100K de entrada + 10K de saída | Oficial: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Oficial: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Documento longo: 500K de entrada + 20K de saída | Oficial: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Oficial: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Sessão de agent: 2M de leituras em cache + 300K de entrada nova + 150K de saída, todos os pedidos abaixo de 272K | Oficial: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Oficial: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
Num prompt de 500K tokens, a tarifa oficial de contexto longo do Sol reduz a diferença de 4× para cerca de 2,1×. Na PoYo, o mesmo pedido custa $0.96 no GPT-6.1 Sol, porque a PoYo fatura o Sol a uma tarifa única, sem multiplicador de contexto longo.
Custo por tarefa concluída
O preço por token é apenas metade da fatura. A Artificial Analysis corre os dois modelos nas mesmas tarefas do Intelligence Index e publica o custo:
| Esforço máximo | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Custo por tarefa do índice | $26.54 | $1.27 |
| Tempo por tarefa do índice | 45.3 min | 23.3 min |
| Pontuação no índice | 65 | 55 |
A diferença de custo é de cerca de 21×, contra uma diferença de preço de 4×: o Fable 5.2 dedica muito mais raciocínio a cada tarefa, e é daí que vêm as pontuações mais altas, enquanto o Sol conclui as tarefas com muito menos tokens. Em cargas de trabalho reais, compara a fatura total por tarefa aceite a par da tarifa por token.
Benchmarks
Mesma configuração: Artificial Analysis Intelligence Index
A Artificial Analysis avalia os dois modelos com as mesmas tarefas e o mesmo harness, por isso os seus números podem ser comparados diretamente. Intelligence Index v5.0.1, consultado a 14 de novembro de 2026:
| Esforço | Pontuação do Fable 5.2 | Pontuação do GPT-6.1 Sol | Tempo por tarefa do Fable 5.2 | Tempo por tarefa do Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 min | 2.0 min |
medium | 56 | 46 | 7.7 min | 4.6 min |
high | 62 | 50 | 16.2 min | 7.9 min |
xhigh | 62 | 52 | 27.9 min | 10.7 min |
max | 65 | 55 | 45.3 min | 23.3 min |
Como ler a tabela:
- O Fable 5.2 pontua mais alto em todos os níveis, por 10 a 19 pontos, o que o torna indicado para trabalho em que a qualidade da resposta é o que mais conta.
- O Fable 5.2 em
lowfica perto do Sol emmax(54 vs 55) em um quarto do tempo. - O Sol entrega as suas pontuações a baixo custo: $1.27 por tarefa do índice com esforço máximo, o que se adequa a trabalho de grande volume e com orçamento apertado.
- O Fable gera tokens mais depressa: cerca de 94–102 tokens de saída por segundo, contra 47–49 do Sol.
- A Artificial Analysis identifica as execuções do Fable 5.2 como “Default Fallback”, o que significa que o fallback de recusa da Anthropic esteve ativo durante os testes.
Resultados de lançamento da Anthropic
A tabela do Fable 5.2 da Anthropic compara-o com o GPT-6 Astra, o nível de topo da OpenAI. Cada modelo correu no esforço mais elevado disponível, salvo indicação em contrário:
| Benchmark | O que mede | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Programação com agents | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Engenharia de software | 69.9% | 65.5% |
| AutomationBench | Workflows empresariais | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Ciência com agents | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Utilização do computador | 89.3% | 79.5% |
| Remote Labor Index | Tarefas reais remuneradas | 41.3% (high) | 20.8% |
| Humanity's Last Exam (com ferramentas) | Raciocínio difícil | 74.2% | 57.2% |
| Chartography (sem ferramentas) | Raciocínio sobre gráficos | 73.4% | 71.0% |

Pontuação no FrontierCode 2.0 face ao custo por tarefa em cada nível de esforço. Gráfico dos materiais de lançamento do Claude Fable 5.2 da Anthropic.
Resultados de lançamento da OpenAI
A OpenAI lançou o GPT-6.1 Sol a 29 de setembro de 2026, seis semanas antes do Fable 5.2, e comparou-o com os seus próprios modelos GPT-6. A OpenAI posiciona-o para programação complexa, utilização do computador e trabalho profissional, com uma capacidade próxima do GPT-6 Astra por um quinto do preço por token do Astra ($2 / $10 contra $10 / $50). As avaliações de lançamento abrangem engenharia de software, compreensão de documentos, automação empresarial e utilização do computador.
Cada fornecedor corre os benchmarks no seu próprio harness e na sua própria versão de teste, por isso compara pontuações dentro da tabela de um mesmo fornecedor e usa o índice da Artificial Analysis acima para uma comparação direta.
Qual deves escolher?
| A tua carga de trabalho | Começa com | Porquê |
|---|---|---|
| Chat de grande volume, extração, encaminhamento | GPT-6.1 Sol em medium (ou um modelo mais pequeno) | Trata tarefas curtas a um quarto do preço por token do Fable |
| Programação do dia a dia e ciclos de agent com orçamento controlado | GPT-6.1 Sol | Feito para programação e trabalho com agents, a $2 / $10 oficial e $1.60 / $8 na PoYo |
| Raciocínio mais exigente, investigação, execuções autónomas longas | Fable 5.2 | 65 vs 55 no Intelligence Index; lidera o GPT-6 Astra em toda a tabela da Anthropic |
| Problemas difíceis em que esperar sai caro | Fable 5.2 em low ou medium | Fica perto do máximo do Sol em um quarto do tempo |
| Utilização do computador, gráficos, documentos visuais densos | Fable 5.2 | 89.3% no OSWorld 2.1 e 73.4% no Chartography na tabela da Anthropic |
| Prompts que passam muitas vezes os 272K tokens | GPT-6.1 Sol na PoYo pelo custo, Fable 5.2 pela profundidade | Na PoYo, ambos mantêm uma tarifa única em toda a janela: $1.60 / $8 no Sol, $6.40 / $32 no Fable |
| Construído sobre as ferramentas alojadas da OpenAI (shell, pesquisa na web, MCP) | GPT-6.1 Sol | Essas ferramentas funcionam de forma nativa através da Responses API |
| Qualidade Claude a um preço mais baixo | Claude Opus 5.5 | $4 / $20; vê Claude Fable 5.2 vs Opus 5.5 |
As execuções autónomas longas adequam-se ao Fable 5.2: os seus agents construíram este protótipo de sistema operativo, aqui a correr num portátil. Vídeo dos materiais de lançamento do Claude Fable 5.2 da Anthropic.
Uma configuração de encaminhamento prática: envia o tráfego de rotina para o GPT-6.1 Sol em medium, regista que tipos de tarefa beneficiam de um raciocínio mais profundo e encaminha-os para o Fable 5.2 em medium. Ao fim de uma semana, compara o custo por tarefa aceite em vez dos preços por token. Para a opção Claude de preço intermédio face ao Sol, vê GPT-6.1 Sol vs Claude Opus 5.5.
Usa os dois na PoYo
A PoYo torna simples usar os dois:
- Uma chave de API para o Fable 5.2, o GPT-6.1 Sol e todos os outros modelos de chat, imagem, vídeo e áudio.
- Pagas conforme a utilização, faturado por token em créditos, sem subscrição.
- Os dois formatos de API: Anthropic Messages e OpenAI Chat Completions e Responses.
- Uma tarifa por modelo em toda a janela de contexto, 20% abaixo de cada tarifa oficial de contexto curto:
| Encargo (por 1M tokens) | Claude Fable 5.2 na PoYo | GPT-6.1 Sol na PoYo |
|---|---|---|
| Entrada | $6.40 | $1.60 |
| Saída | $32.00 | $8.00 |
| Leitura da cache | $0.16 | $0.08 |
| Escrita na cache | $8.00 (5 min) / $12.80 (1 hora) | $2.00 |
O Fable 5.2 através do formato Anthropic Messages:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Revê este diff à procura de bugs de concorrência: ..."}]
  }'
O GPT-6.1 Sol através da Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Revê este diff à procura de bugs de concorrência: ..."
  }'
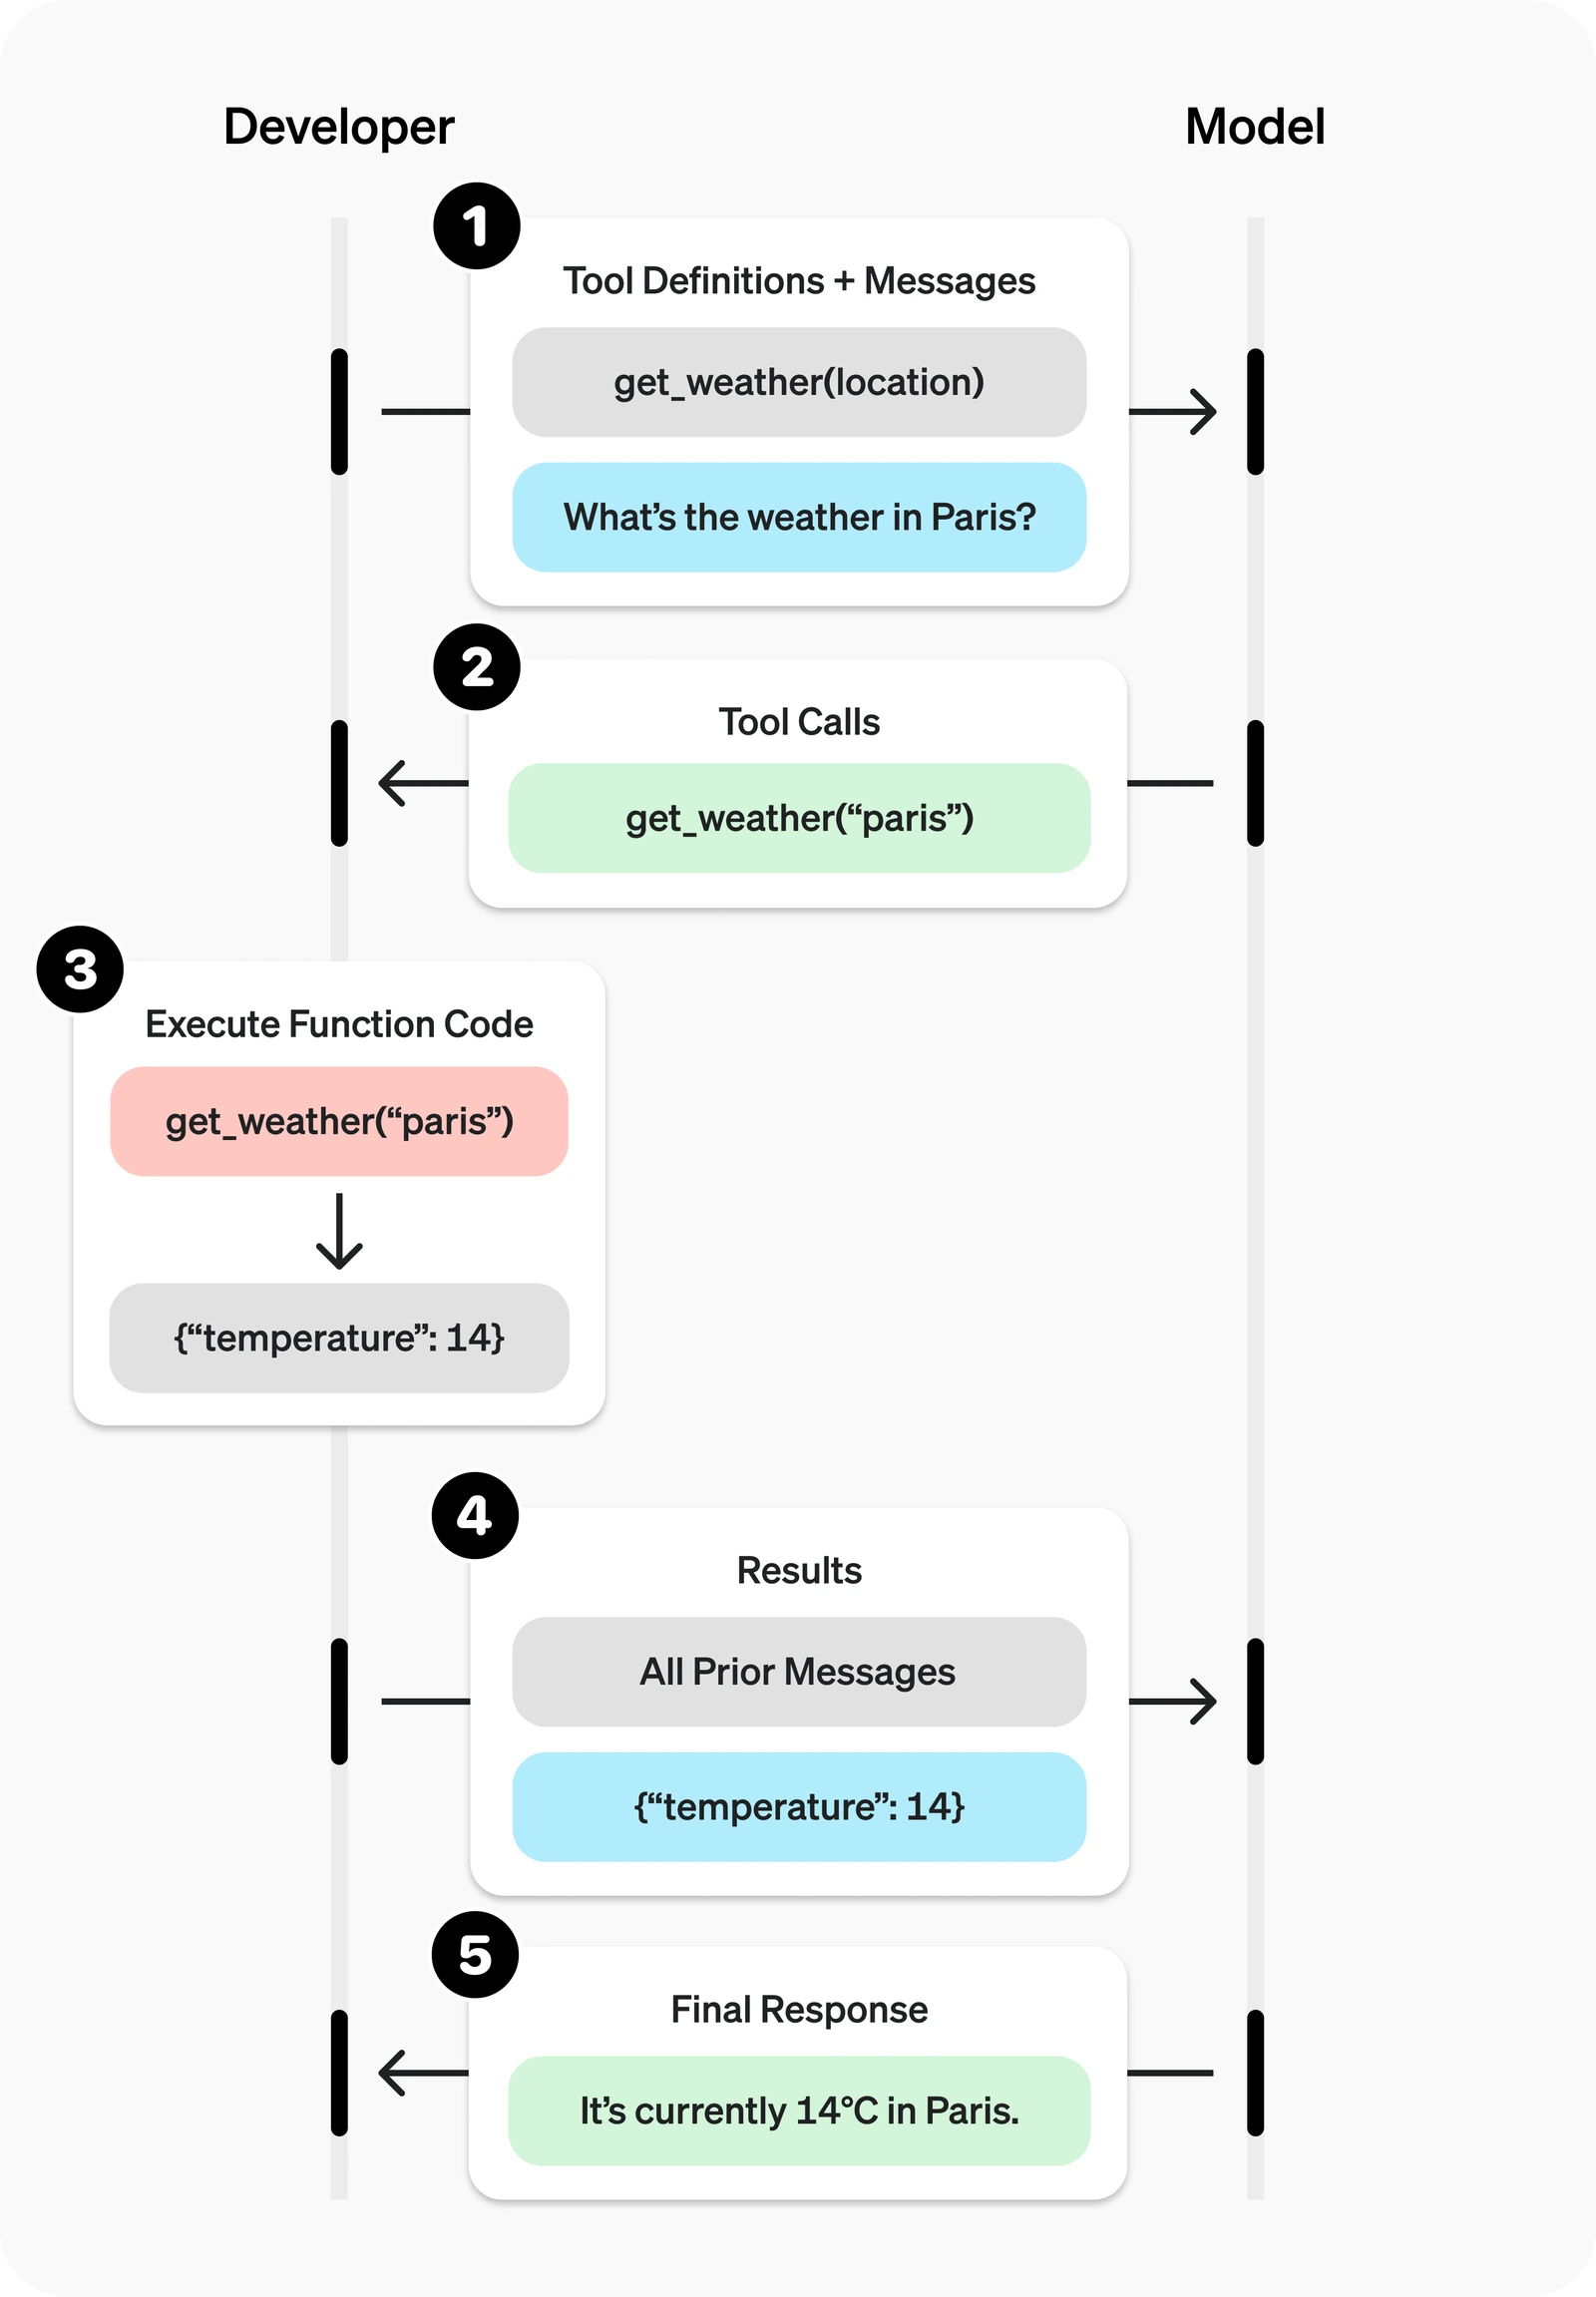
O ciclo de chamada de funções que o GPT-6.1 Sol usa no trabalho com ferramentas. Diagrama da documentação oficial da OpenAI.
Para fazer um teste A/B dos dois no mesmo caminho de código, envia claude-fable-5-2 e gpt-6.1-sol para /v1/chat/completions e muda apenas o campo model. Para a configuração do SDK, o esforço e a cache no Fable, vê o nosso guia da API Claude Fable 5.2; para os limites e as ferramentas do Sol, vê o guia de funcionalidades do GPT-6.1 Sol.
Páginas dos modelos: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Perguntas frequentes
O Fable 5 é melhor do que o GPT-5.6 Sol?
Cada um adequava-se a trabalho diferente. Nos testes de julho de 2026, o Fable 5 passou nos 47 workflows de ferramentas com várias apps da Composio (o GPT-5.6 Sol passou em 45), enquanto o GPT-5.6 Sol obteve a pontuação mais alta nas três tarefas de planeamento de design de sistemas da Kilo, com um preço por token mais baixo. Na geração atual, o Fable 5.2 obtém 65 e o GPT-6.1 Sol 55 no Artificial Analysis Intelligence Index, com o Sol a uma fração do custo por tarefa.
O GPT Astra vai ser melhor do que o Fable?
O GPT-6 Astra já está disponível, a $10 / $50 por milhão de tokens. Na tabela de lançamento do Fable 5.2 da Anthropic, o Fable 5.2 pontua acima do GPT-6 Astra em todos os benchmarks em que ambos foram testados, por exemplo 74,6% vs 68,1% no Terminal-Bench-Science 0.1 e 89,3% vs 79,5% no OSWorld 2.1. São execuções da própria Anthropic; testa os dois nas tuas tarefas antes de decidires.
O GPT-5.6 Luna é melhor?
O Luna é o nível GPT-5.6 mais pequeno e mais acessível, feito para trabalho rápido e de grande volume, enquanto o Sol se adequa a tarefas mais difíceis. Escolhe o Luna pelo débito e pelo custo, e o Sol pela profundidade. Na geração atual, o GPT-6 Luna tem um preço de tabela de $0.10 / $0.50 por milhão de tokens.
Vale a pena o GPT-5.6 Sol?
O GPT-5.6 Sol é a geração anterior. Para projetos novos, o GPT-6.1 Sol é o modelo Sol atual da OpenAI, a $2 / $10 por milhão de tokens em contexto curto, ou $1.60 / $8 na PoYo em toda a janela de contexto. O GPT-5.6 Sol continua a ser uma boa opção para integrações já afinadas para ele.
O Claude Fable 5.2 é melhor do que o GPT-6.1 Sol?
Para a máxima capacidade, a escolha é o Fable 5.2: pontua 10 a 19 pontos acima em todos os níveis de esforço no Artificial Analysis Intelligence Index. Pelo custo, a escolha é o GPT-6.1 Sol: custa um quarto por token e, com esforço máximo, cerca de um vigésimo por tarefa do índice.
Qual é mais barato, o Fable 5.2 ou o GPT-6.1 Sol?
O GPT-6.1 Sol. Os preços oficiais são $2 / $10 por milhão de tokens de entrada/saída, contra $8 / $40 do Fable 5.2. Acima de 272K tokens de entrada, a OpenAI sobe o Sol para $4 / $15 no pedido inteiro, enquanto o Fable se mantém a $8 / $40. Na PoYo, o Sol mantém-se a $1.60 / $8 com qualquer comprimento de prompt.
Qual é melhor para programação?
Os dois fornecedores publicam resultados de programação em benchmarks diferentes. A Anthropic indica 49,1% para o Fable 5.2 no FrontierCode 2.0, à frente do GPT-6 Astra, e a OpenAI criou o GPT-6.1 Sol para programação complexa por um quinto do preço por token do Astra. Uma predefinição sensata é o Sol para programação de rotina em volume e o Fable 5.2 para alterações grandes e demoradas. Corre os dois numa amostra dos teus próprios tickets.
Os dois modelos têm uma janela de contexto de 1M?
Sim, aproximadamente. O Fable 5.2 tem uma janela de 1M tokens. O GPT-6.1 Sol tem uma janela de 1 050 000 tokens, com até 922 000 tokens de entrada. Ambos escrevem até 128K tokens de saída por pedido.