
Das Wichtigste in Kürze
- Fable 5.2 eignet sich für die schwierigste Arbeit, GPT-6.1 Sol für Arbeit mit hohem Volumen. Im Artificial Analysis Intelligence Index erreicht Fable 5.2 bei maximalem Aufwand 65 Punkte und GPT-6.1 Sol 55, wobei Sol jede Index-Aufgabe für einen Bruchteil der Kosten erledigt.
- Offizielle Tokenpreise: $8 / $40 pro Million Eingabe-/Ausgabe-Tokens für Fable 5.2 und $2 / $10 für Sol bei kurzem Kontext, ein Unterschied um den Faktor 4.
- Ein einheitlicher Preis auf PoYo. OpenAI berechnet für die gesamte Anfrage $4 / $15, sobald Sol mehr als 272K Eingabe-Tokens erhält. Auf PoYo kostet GPT-6.1 Sol über das gesamte Kontextfenster $1.60 / $8 und Fable 5.2 über das gesamte 1M-Fenster $6.40 / $32.
- Fable 5.2 steckt mehr Reasoning in jede Aufgabe. Artificial Analysis hat bei maximalem Aufwand $26.54 pro Index-Aufgabe für Fable 5.2 und $1.27 für Sol gemessen.
- Fable 5.2 erreicht schnell starke Werte. Mit Aufwand
lowkommt es auf 54 Punkte, nah an Sols 55 beimax, und erledigt eine Index-Aufgabe in 5.8 statt 23.3 Minuten. - Sie suchen nach „GPT-5.6 Sol vs. Fable 5“? Das war das Duell vom Juli 2026. Beide Modellreihen haben sich seitdem weiterentwickelt; der Abschnitt unten behandelt das alte Paar separat.
Claude Fable 5.2 vs. GPT-6.1 Sol im Überblick
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Entwickler | Anthropic | OpenAI |
| API-Modell-ID | claude-fable-5-2 | gpt-6.1-sol |
| Veröffentlicht | 9. November 2026 | 29. September 2026 |
| Einordnung | Anthropics Spitzenklasse, über Opus | OpenAIs Sol-Stufe, zwischen GPT-6 Astra und GPT-6 Luna |
| Kontextfenster | 1M Tokens | 1.050.000 Tokens (maximal 922.000 Eingabe-Tokens) |
| Maximale Ausgabe | 128K Tokens | 128K Tokens |
| Eingabe → Ausgabe | Text und Bilder → Text | Text und Bilder → Text |
| Reasoning-Steuerung | output_config.effort | reasoning.effort |
| Aufwandsstufen | low bis max, Standard high | low bis max, Standard medium |
| Wissensstand | Juni 2026 | 30. April 2026 |
| Offizielle Eingabe / Ausgabe (pro 1M) | $8 / $40 | $2 / $10 (Eingabe ≤272K) $4 / $15 (Eingabe >272K) |
| Offizieller Cache-Lesezugriff (pro 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| PoYo Eingabe / Ausgabe (pro 1M) | $6.40 / $32 | $1.60 / $8 |
| PoYo-Endpunkte | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs. Fable 5: Welche Versionen vergleichen Sie?
Die meisten Seiten, die zu „GPT-5.6 Sol vs. Fable 5“ ranken, entstanden im Juli 2026, als diese beiden die neuesten Modelle waren. Seitdem haben beide Modellreihen neuere Versionen veröffentlicht:
| Modell | Entwickler | Veröffentlicht | Offizielle Eingabe / Ausgabe zum Start (pro 1M, kurzer Kontext) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9. Juni 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9. Juli 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1. September 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22. September 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29. September 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9. November 2026 | $8 / $40 |
GPT-5.6 Sol vs. Claude Fable 5: das Duell im Juli 2026
Zum Start kostete GPT-5.6 Sol bei der Eingabe halb so viel wie Fable 5 und bei der Ausgabe 40% weniger ($5 / $30 gegenüber $10 / $50, gecachte Eingabe $0.50 gegenüber $1). Die unabhängigen Tests aus diesem Monat kamen zu unterschiedlichen Ergebnissen:
| Test | Aufbau | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: drei Pläne für Systemdesign | Kilo Code CLI, beide mit Max-Reasoning, bewertet nach einer vorab erstellten Rubrik | Bestwert bei allen drei Aufgaben, nachdem es jeden Plan selbst geprüft und überarbeitet hatte; im Schnitt 52 Min. 53 s pro Plan; insgesamt $13.57 | Pläne, die sich laut den Testern am leichtesten umsetzen ließen; im Schnitt 15 Min. 27 s pro Plan; insgesamt $12.02 |
| Composio: Golden Eval, 47 Tool-Workflows über mehrere Apps | Fable 5 in Claude Code; Sol in Codex CLI mit high | 45 von 47 bestanden (95.7%); im Schnitt 223.779 Tokens und 79.6 s pro Aufgabe | 47 von 47 bestanden (100%); im Schnitt 276.957 Tokens und 84.4 s pro Aufgabe |
| Analytics Vidhya: Web-App, Datenanalyse, Investorenpräsentation | Gleiche Prompts, neue Chats, Standard-Reasoning | Vergleichbare Qualität bei etwa doppelter Laufzeit | Vergleichbare Qualität und schnellere Durchläufe; die Wahl des Autors für lange, komplexe Arbeit, die in einem Zug übergeben wird |
Das Muster im Juli: GPT-5.6 Sol eignete sich für Planung und Coding zu einem niedrigeren Tokenpreis und nahm sich zusätzliche Zeit, um die eigene Arbeit zu prüfen; Fable 5 eignete sich für lange Tool-Workflows und schrieb Pläne, die sich leicht umsetzen ließen.
Diese Ergebnisse beziehen sich auf die Modelle vom Juli, die inzwischen zur vorherigen Generation gehören. Seitdem ist der Preisabstand zugunsten von Sol gewachsen: Fable 5.2 kostet pro Token das Vierfache von GPT-6.1 Sol, während Fable 5 bei der Eingabe das Doppelte und bei der Ausgabe etwa das 1.7-Fache von GPT-5.6 Sol kostete. Der Rest dieses Artikels vergleicht das aktuelle Paar. Auf PoYo ist GPT-5.6 Sol über die Responses API für Integrationen verfügbar, die bereits darauf abgestimmt sind.
Was beide Modelle gemeinsam haben und worin sie sich unterscheiden
Gemeinsam:
- Rund 1M Tokens Kontext und 128K Ausgabe-Tokens pro Anfrage.
- Text- und Bildeingabe, Textausgabe.
- Fünf Aufwandsstufen, von
lowbismax. Jeder Anbieter kalibriert seine Stufen selbst; vergleichen Sie daher Ergebnisse statt Bezeichnungen. - Prompt-Caching, Streaming und strukturierte Ausgaben.
Unterschiedlich:
- Standard-Aufwand. Fable 5.2 nutzt standardmäßig
high, Sol dagegenmedium. Setzen Sie den Aufwand in direkten Vergleichstests explizit, damit beide auf der gewünschten Stufe laufen. - Thinking-Steuerung. Fable 5.2 denkt immer adaptiv und akzeptiert für
tool_choicedie Werteautoodernone. Sol wird überreasoning.effortkonfiguriert, und seine gehosteten Tools (Websuche, Dateisuche, Code Interpreter, Hosted Shell, Apply Patch, Computersteuerung, MCP, Tool Search) laufen über OpenAIs Responses API. - Wissensstand. Juni 2026 bei Fable 5.2; 30. April 2026 bei Sol.
- Datenaufbewahrung. Fable 5.2 läuft über Anthropics API mit 30 Tagen Datenaufbewahrung.
Preise: 4× pro Token, 2× bei langen Prompts
Offizielle Preise (USD pro 1M Tokens)
| Posten | Claude Fable 5.2 | GPT-6.1 Sol, Eingabe ≤272K | GPT-6.1 Sol, Eingabe >272K |
|---|---|---|---|
| Eingabe | $8.00 | $2.00 | $4.00 |
| Ausgabe | $40.00 | $10.00 | $15.00 |
| Cache-Lesezugriff | $0.20 | $0.10 | $0.20 |
| Cache-Schreibzugriff | $10 (5 Min.) / $16 (1 Stunde) | $2.50 (30 Min.) / $5.00 (12 Stunden) | $5.00 (30 Min.) / $10.00 (12 Stunden) |
OpenAI berechnet für Prompts mit mehr als 272K Eingabe-Tokens das 2-Fache der Eingabe- und Cache-Preise und das 1.5-Fache des Ausgabepreises, und zwar für die gesamte Anfrage. Anthropic rechnet das volle 1M-Fenster von Fable 5.2 zu Standardpreisen ab. Auf PoYo gilt für beide Modelle ein einheitlicher Preis über das gesamte Kontextfenster, sodass GPT-6.1 Sol unabhängig von der Prompt-Länge bei $1.60 / $8 bleibt. Die Preise aller Claude-Modelle finden Sie in unserem Preisleitfaden zur Claude API.
Kosten pro Anfrage
Diese Beispiele gehen davon aus, dass beide Modelle gleich viele Tokens verbrauchen; der tatsächliche Verbrauch unterscheidet sich je nach Modell (siehe nächster Abschnitt). Kosten für Cache-Schreibzugriffe sind bei beiden nicht berücksichtigt.
| Szenario | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Chat-Antwort: 20K Eingabe + 4K Ausgabe | Offiziell: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Offiziell: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Coding-Aufgabe: 100K Eingabe + 10K Ausgabe | Offiziell: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Offiziell: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Langes Dokument: 500K Eingabe + 20K Ausgabe | Offiziell: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Offiziell: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Agenten-Sitzung: 2M Cache-Lesezugriffe + 300K neue Eingabe + 150K Ausgabe, jede Anfrage unter 272K | Offiziell: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Offiziell: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
Bei einem Prompt mit 500K Tokens verringert Sols offizieller Preis für lange Kontexte den Abstand von 4× auf etwa 2.1×. Auf PoYo kostet dieselbe Anfrage mit GPT-6.1 Sol $0.96, weil PoYo Sol zu einem einheitlichen Preis ohne Multiplikator für lange Kontexte abrechnet.
Kosten pro abgeschlossener Aufgabe
Der Tokenpreis ist nur die halbe Rechnung. Artificial Analysis lässt beide Modelle dieselben Aufgaben des Intelligence Index lösen und veröffentlicht die Kosten:
| Maximaler Aufwand | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Kosten pro Index-Aufgabe | $26.54 | $1.27 |
| Zeit pro Index-Aufgabe | 45.3 Min. | 23.3 Min. |
| Index-Wert | 65 | 55 |
Der Kostenabstand liegt bei etwa 21×, der Preisabstand bei 4×: Fable 5.2 steckt deutlich mehr Reasoning in jede Aufgabe, und genau daher stammen seine höheren Werte, während Sol Aufgaben mit weit weniger Tokens abschließt. Vergleichen Sie bei echten Workloads die Gesamtkosten pro akzeptierter Aufgabe zusätzlich zum Tokenpreis.
Benchmarks
Gleicher Aufbau: Artificial Analysis Intelligence Index
Artificial Analysis bewertet beide Modelle mit denselben Aufgaben und demselben Harness, sodass sich die Werte direkt vergleichen lassen. Intelligence Index v5.0.1, abgerufen am 14. November 2026:
| Aufwand | Wert Fable 5.2 | Wert GPT-6.1 Sol | Zeit pro Aufgabe Fable 5.2 | Zeit pro Aufgabe Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 Min. | 2.0 Min. |
medium | 56 | 46 | 7.7 Min. | 4.6 Min. |
high | 62 | 50 | 16.2 Min. | 7.9 Min. |
xhigh | 62 | 52 | 27.9 Min. | 10.7 Min. |
max | 65 | 55 | 45.3 Min. | 23.3 Min. |
So lesen Sie die Tabelle:
- Fable 5.2 erzielt auf jeder Stufe höhere Werte, mit 10 bis 19 Punkten Vorsprung. Das passt zu Arbeit, bei der die Qualität der Antwort am meisten zählt.
- Fable 5.2 mit
lowkommt nah an Sol mitmaxheran (54 vs. 55), in einem Viertel der Zeit. - Sol liefert seine Werte zu niedrigen Kosten: $1.27 pro Index-Aufgabe bei maximalem Aufwand. Das passt zu Arbeit mit hohem Volumen und knappem Budget.
- Fable erzeugt Tokens schneller: etwa 94–102 Ausgabe-Tokens pro Sekunde gegenüber 47–49 bei Sol.
- Artificial Analysis kennzeichnet seine Durchläufe mit Fable 5.2 als „Default Fallback“, das heißt, Anthropics Fallback bei Ablehnungen war während der Tests aktiviert.
Anthropics Launch-Ergebnisse
Anthropics Tabelle zu Fable 5.2 vergleicht das Modell mit GPT-6 Astra, OpenAIs Spitzenklasse. Jedes Modell lief mit dem höchsten verfügbaren Aufwand, sofern nicht anders angegeben:
| Benchmark | Was gemessen wird | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Agentisches Coding | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Softwareentwicklung | 69.9% | 65.5% |
| AutomationBench | Geschäftsabläufe | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Agentische Wissenschaft | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Computersteuerung | 89.3% | 79.5% |
| Remote Labor Index | Echte bezahlte Aufträge | 41.3% (high) | 20.8% |
| Humanity's Last Exam (mit Tools) | Anspruchsvolles Reasoning | 74.2% | 57.2% |
| Chartography (ohne Tools) | Diagramm-Reasoning | 73.4% | 71.0% |

Ergebnis bei FrontierCode 2.0 gegenüber den Kosten pro Aufgabe auf jeder Aufwandsstufe. Diagramm aus Anthropics Launch-Materialien zu Claude Fable 5.2.
OpenAIs Launch-Ergebnisse
OpenAI hat GPT-6.1 Sol am 29. September 2026 veröffentlicht, sechs Wochen vor Fable 5.2, und es mit den eigenen GPT-6-Modellen verglichen. OpenAI positioniert es für komplexes Coding, Computersteuerung und professionelle Arbeit, mit einer Leistung nahe an GPT-6 Astra zu einem Fünftel von dessen Tokenpreis ($2 / $10 gegenüber $10 / $50). Die Launch-Evaluierungen umfassen Softwareentwicklung, Dokumentenverständnis, Geschäftsautomatisierung und Computersteuerung.
Jeder Anbieter führt Benchmarks mit eigenem Harness und eigener Testversion durch. Vergleichen Sie Werte daher innerhalb der Tabelle eines Anbieters und nutzen Sie für den direkten Vergleich den oben genannten Index von Artificial Analysis.
Welches Modell sollten Sie wählen?
| Ihr Workload | Starten mit | Warum |
|---|---|---|
| Chat, Extraktion, Routing in großem Umfang | GPT-6.1 Sol mit medium (oder ein kleineres Modell) | Erledigt kurze Aufgaben zu einem Viertel des Tokenpreises von Fable |
| Alltägliches Coding und Agenten-Loops mit begrenztem Budget | GPT-6.1 Sol | Für Coding und Agentenarbeit gebaut, zu $2 / $10 offiziell und $1.60 / $8 auf PoYo |
| Anspruchsvollstes Reasoning, Forschung, lange autonome Läufe | Fable 5.2 | 65 vs. 55 im Intelligence Index; führt in Anthropics Tabelle durchgehend vor GPT-6 Astra |
| Schwierige Probleme, bei denen Wartezeit teuer ist | Fable 5.2 mit low oder medium | Nah am Höchstwert von Sol in einem Viertel der Zeit |
| Computersteuerung, Diagramme, dichte visuelle Dokumente | Fable 5.2 | 89.3% bei OSWorld 2.1 und 73.4% bei Chartography in Anthropics Tabelle |
| Prompts regelmäßig über 272K Tokens | GPT-6.1 Sol auf PoYo für niedrige Kosten, Fable 5.2 für Tiefe | Auf PoYo behalten beide einen einheitlichen Preis über das gesamte Fenster: $1.60 / $8 für Sol, $6.40 / $32 für Fable |
| Aufgebaut auf OpenAIs gehosteten Tools (Shell, Websuche, MCP) | GPT-6.1 Sol | Diese Tools laufen nativ über die Responses API |
| Claude-Qualität zu einem niedrigeren Preis | Claude Opus 5.5 | $4 / $20; siehe Claude Fable 5.2 vs. Opus 5.5 |
Lange autonome Läufe liegen Fable 5.2: Seine Agenten haben diesen Betriebssystem-Prototyp gebaut, der hier auf einem Laptop läuft. Video aus Anthropics Launch-Materialien zu Claude Fable 5.2.
Ein praxistaugliches Routing: Schicken Sie den Routine-Traffic an GPT-6.1 Sol mit medium, notieren Sie, welche Aufgabentypen von tieferem Reasoning profitieren, und leiten Sie diese an Fable 5.2 mit medium weiter. Vergleichen Sie nach einer Woche die Kosten pro akzeptierter Aufgabe statt der Tokenpreise. Den Vergleich der Claude-Option im mittleren Preissegment mit Sol finden Sie unter GPT-6.1 Sol vs. Claude Opus 5.5.
Beide Modelle auf PoYo nutzen
Mit PoYo setzen Sie beide Modelle ganz einfach ein:
- Ein API-Schlüssel für Fable 5.2, GPT-6.1 Sol und alle weiteren Chat-, Bild-, Video- und Audiomodelle.
- Nutzungsbasierte Abrechnung, pro Token in Credits, ganz ohne Abo.
- Beide API-Formate: Anthropic Messages sowie OpenAI Chat Completions und Responses.
- Ein einheitlicher Preis pro Modell über das gesamte Kontextfenster, 20% unter dem jeweiligen offiziellen Preis für kurze Kontexte:
| Posten (pro 1M Tokens) | Claude Fable 5.2 auf PoYo | GPT-6.1 Sol auf PoYo |
|---|---|---|
| Eingabe | $6.40 | $1.60 |
| Ausgabe | $32.00 | $8.00 |
| Cache-Lesezugriff | $0.16 | $0.08 |
| Cache-Schreibzugriff | $8.00 (5 Min.) / $12.80 (1 Stunde) | $2.00 |
Fable 5.2 über das Anthropic-Messages-Format:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Prüfe diesen Diff auf Nebenläufigkeitsfehler: ..."}]
  }'
GPT-6.1 Sol über die Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Prüfe diesen Diff auf Nebenläufigkeitsfehler: ..."
  }'
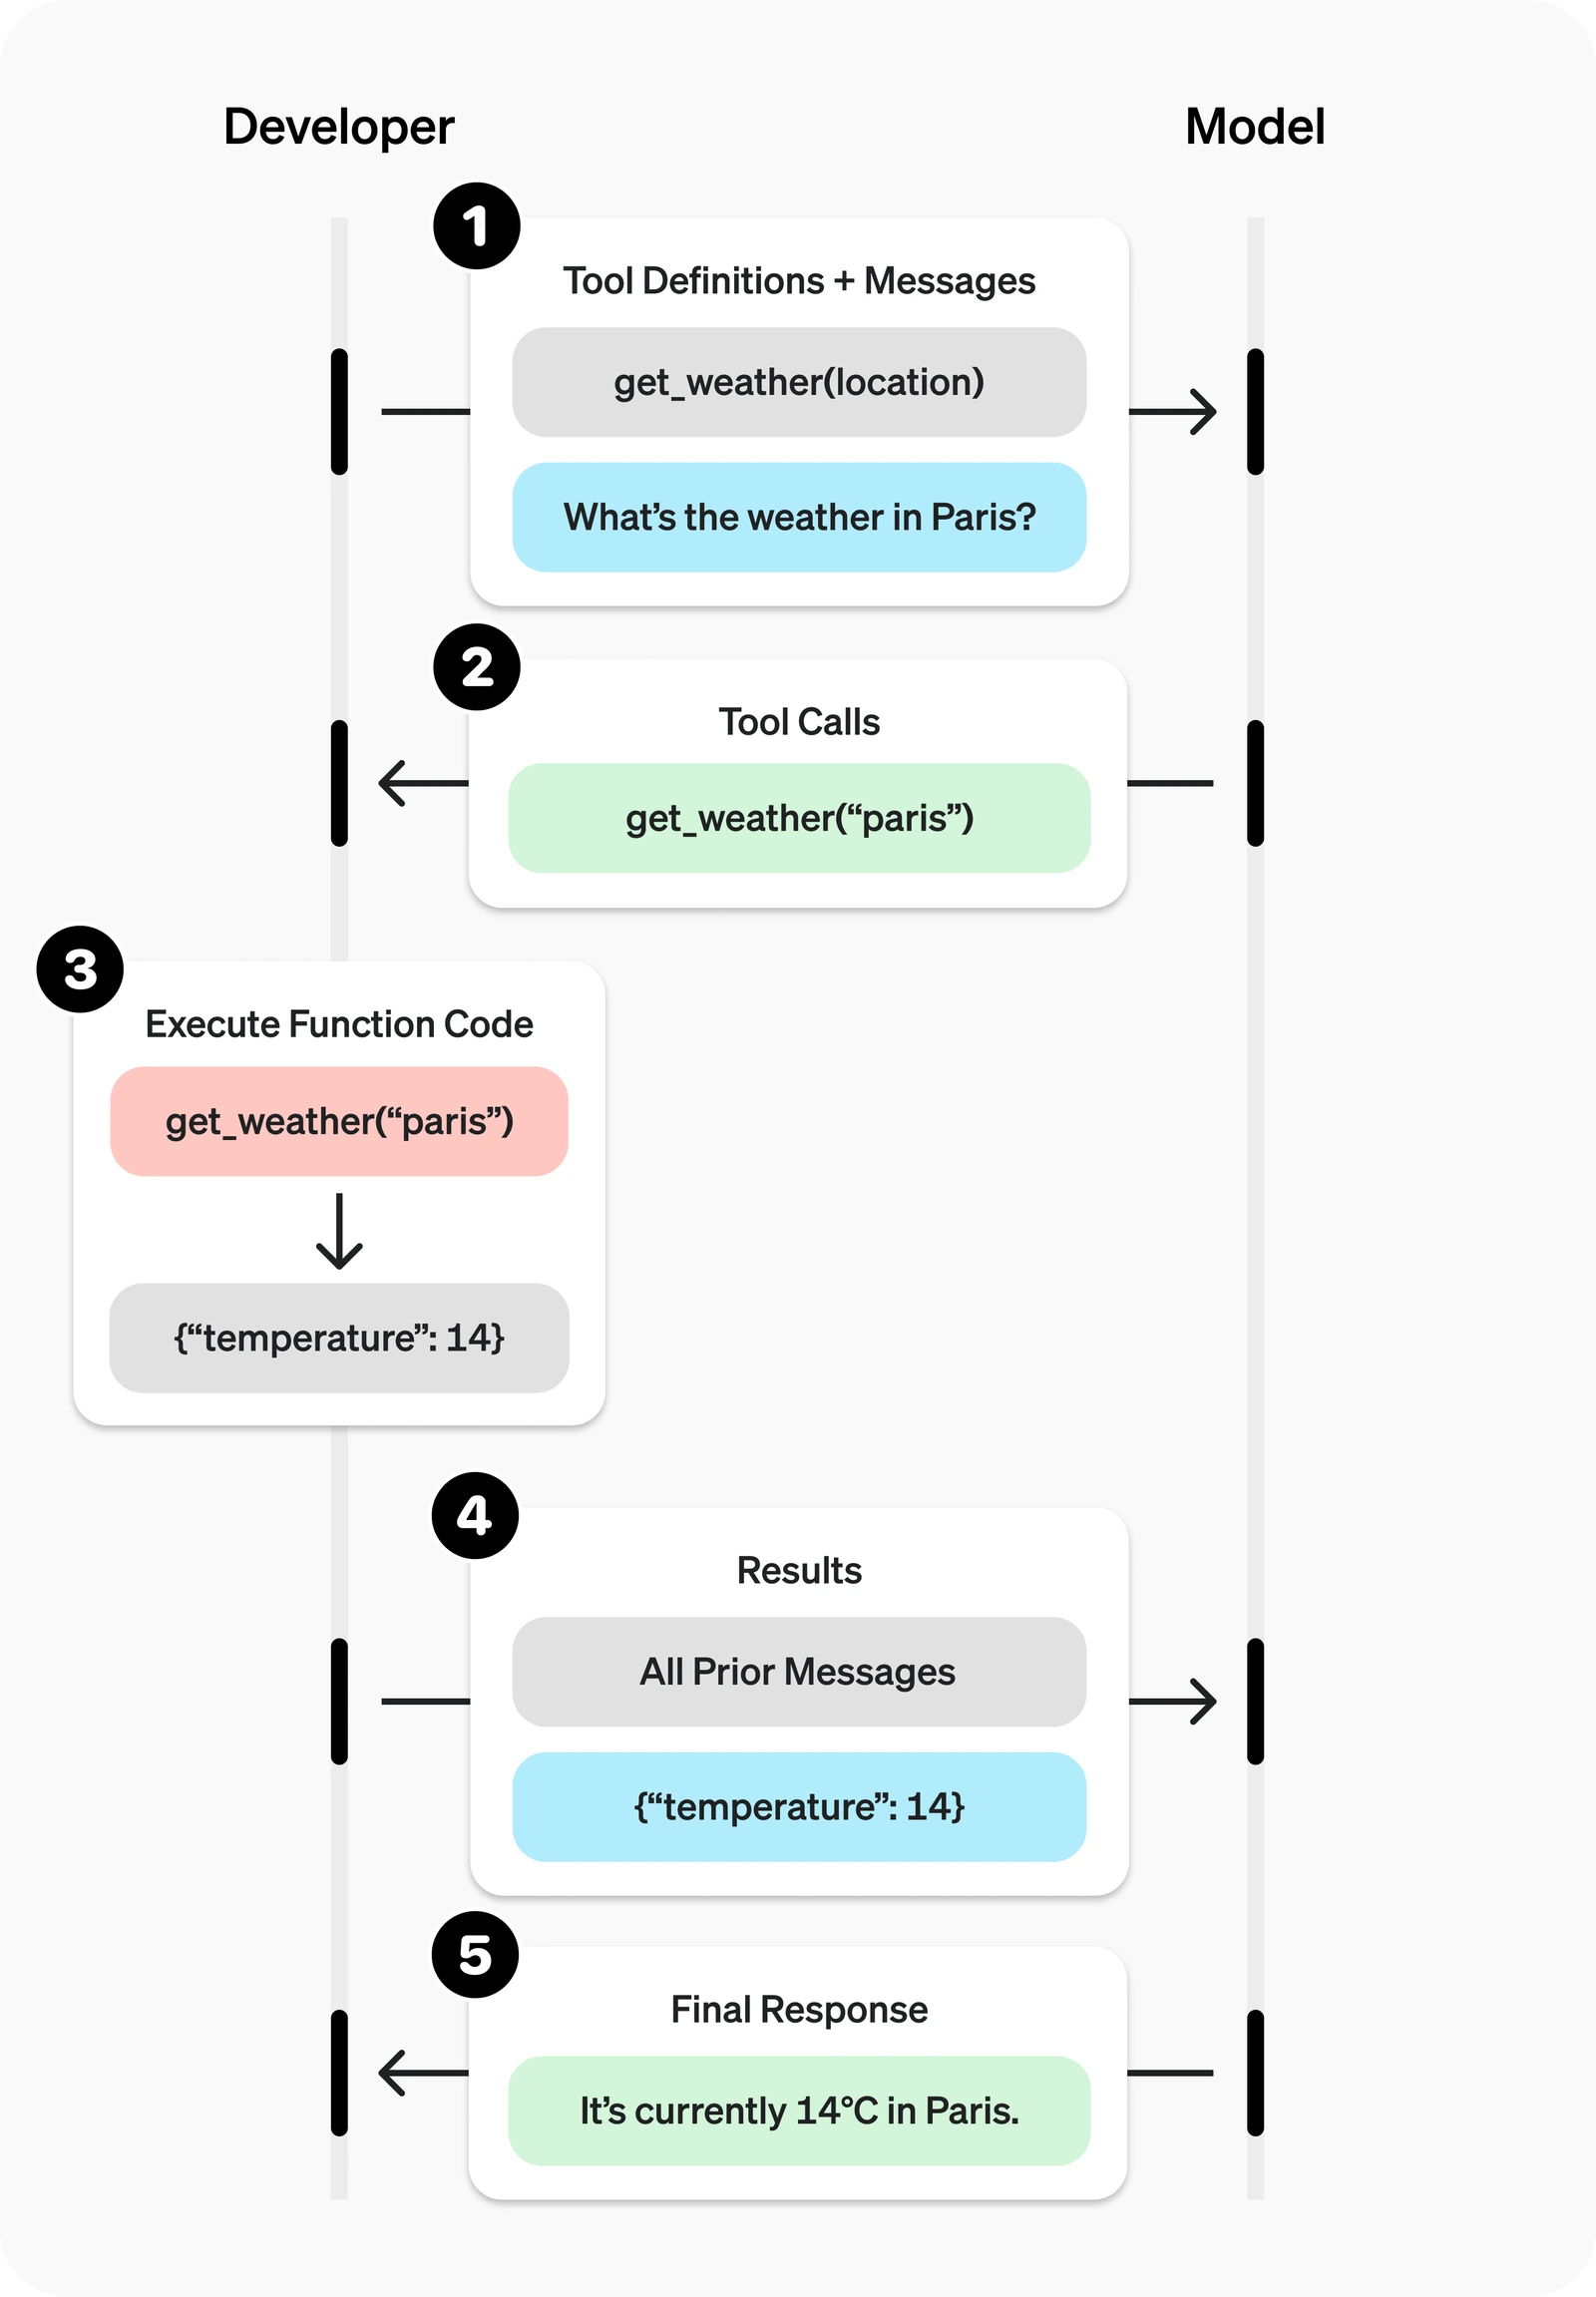
Der Function-Calling-Ablauf, den GPT-6.1 Sol für die Arbeit mit Tools nutzt. Diagramm aus der offiziellen Dokumentation von OpenAI.
Für einen A/B-Test beider Modelle im selben Code-Pfad senden Sie claude-fable-5-2 und gpt-6.1-sol an /v1/chat/completions und ändern nur das Feld model. Einrichtung des SDK, Aufwand und Caching bei Fable erklärt unser Leitfaden zur Claude Fable 5.2 API; Limits und Tools von Sol finden Sie im Leitfaden zu den Funktionen von GPT-6.1 Sol.
Modellseiten: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
FAQ
Ist Fable 5 besser als GPT-5.6 Sol?
Jedes Modell eignete sich für andere Arbeit. In Tests vom Juli 2026 bestand Fable 5 alle 47 Tool-Workflows über mehrere Apps von Composio (GPT-5.6 Sol bestand 45), während GPT-5.6 Sol bei allen drei Planungsaufgaben zum Systemdesign von Kilo die besten Werte zu einem niedrigeren Tokenpreis erzielte. In der aktuellen Generation erreicht Fable 5.2 im Artificial Analysis Intelligence Index 65 Punkte und GPT-6.1 Sol 55, wobei Sol pro Aufgabe nur einen Bruchteil kostet.
Wird GPT Astra besser sein als Fable?
GPT-6 Astra ist bereits verfügbar, zu $10 / $50 pro Million Tokens. In Anthropics Launch-Tabelle zu Fable 5.2 erzielt Fable 5.2 bei jedem Benchmark, auf dem beide getestet wurden, höhere Werte als GPT-6 Astra, zum Beispiel 74.6% vs. 68.1% bei Terminal-Bench-Science 0.1 und 89.3% vs. 79.5% bei OSWorld 2.1. Es handelt sich um Anthropics eigene Durchläufe; testen Sie beide mit Ihren Aufgaben, bevor Sie sich entscheiden.
Ist GPT-5.6 Luna besser?
Luna ist die kleinste und günstigste Stufe von GPT-5.6, gebaut für schnelle Arbeit mit hohem Volumen, während Sol sich für schwierigere Aufgaben eignet. Wählen Sie Luna für Durchsatz und Kosten, Sol für Tiefe. In der aktuellen Generation kostet GPT-6 Luna laut Preisliste $0.10 / $0.50 pro Million Tokens.
Lohnt sich GPT-5.6 Sol?
GPT-5.6 Sol gehört zur vorherigen Generation. Für neue Projekte ist GPT-6.1 Sol OpenAIs aktuelles Sol-Modell, zu $2 / $10 pro Million Tokens bei kurzem Kontext oder zu $1.60 / $8 auf PoYo über das gesamte Kontextfenster. Für Integrationen, die bereits auf GPT-5.6 Sol abgestimmt sind, bleibt es eine gute Wahl.
Ist Claude Fable 5.2 besser als GPT-6.1 Sol?
Für maximale Leistung ist Fable 5.2 die richtige Wahl: Im Artificial Analysis Intelligence Index liegt es auf jeder Aufwandsstufe 10 bis 19 Punkte vorn. Bei den Kosten ist GPT-6.1 Sol die richtige Wahl: Es kostet pro Token ein Viertel und bei maximalem Aufwand pro Index-Aufgabe etwa ein Zwanzigstel.
Was ist günstiger, Fable 5.2 oder GPT-6.1 Sol?
GPT-6.1 Sol. Die offiziellen Preise liegen bei $2 / $10 pro Million Eingabe-/Ausgabe-Tokens gegenüber $8 / $40 bei Fable 5.2. Über 272K Eingabe-Tokens erhöht OpenAI den Preis von Sol für die gesamte Anfrage auf $4 / $15, während Fable bei $8 / $40 bleibt. Auf PoYo bleibt Sol bei jeder Prompt-Länge bei $1.60 / $8.
Welches Modell ist besser für Coding?
Die beiden Anbieter geben Coding-Ergebnisse auf unterschiedlichen Benchmarks an. Anthropic nennt für Fable 5.2 49.1% bei FrontierCode 2.0, vor GPT-6 Astra, und OpenAI hat GPT-6.1 Sol für komplexes Coding zu einem Fünftel des Tokenpreises von Astra gebaut. Ein sinnvoller Standard: Sol für Routine-Coding in großem Umfang und Fable 5.2 für große, lang laufende Änderungen. Testen Sie beide mit einer Stichprobe Ihrer eigenen Tickets.
Haben beide Modelle ein Kontextfenster von 1M Tokens?
Ja, ungefähr. Fable 5.2 hat ein Fenster von 1M Tokens. GPT-6.1 Sol hat ein Fenster von 1.050.000 Tokens mit bis zu 922.000 Eingabe-Tokens. Beide schreiben bis zu 128K Ausgabe-Tokens pro Anfrage.