
핵심 요약
- 가장 어려운 작업에는 Fable 5.2, 대량 작업에는 GPT-6.1 Sol이 어울립니다. Artificial Analysis Intelligence Index에서 max effort 기준 Fable 5.2는 65점, GPT-6.1 Sol은 55점이며, Sol은 인덱스 작업 하나를 훨씬 적은 비용으로 완료합니다.
- 공식 토큰 가격: 입력/출력 토큰 100만 개당 Fable 5.2는 $8 / $40, Sol은 짧은 컨텍스트 기준 $2 / $10으로 4배 차이입니다.
- PoYo에서는 단일 요금입니다. OpenAI는 입력이 272K 토큰을 넘으면 Sol의 요청 전체를 $4 / $15로 올립니다. PoYo에서는 GPT-6.1 Sol이 컨텍스트 윈도우 전체에서 $1.60 / $8, Fable 5.2가 1M 윈도우 전체에서 $6.40 / $32입니다.
- Fable 5.2는 작업마다 더 많은 추론을 투입합니다. Artificial Analysis가 측정한 max effort 기준 인덱스 작업당 비용은 Fable 5.2가 $26.54, Sol이 $1.27이었습니다.
- Fable 5.2는 높은 점수에 빠르게 도달합니다.
loweffort에서 54점으로max의 Sol(55점)에 근접하며, 인덱스 작업 하나를 23.3분이 아닌 5.8분 만에 끝냅니다. - "GPT-5.6 Sol vs Fable 5"를 찾고 계신가요? 이는 2026년 7월의 대결입니다. 두 모델 라인 모두 이후 새 버전이 나왔으며, 이전 조합은 아래 섹션에서 따로 다룹니다.
Claude Fable 5.2 vs GPT-6.1 Sol 한눈에 보기
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| 개발사 | Anthropic | OpenAI |
| API 모델 ID | claude-fable-5-2 | gpt-6.1-sol |
| 출시일 | 2026년 11월 9일 | 2026년 9월 29일 |
| 포지션 | Anthropic 최상위 등급(Opus보다 위) | OpenAI Sol 등급(GPT-6 Astra와 GPT-6 Luna 사이) |
| 컨텍스트 윈도우 | 1M 토큰 | 1,050,000 토큰(최대 입력 922,000) |
| 최대 출력 | 128K 토큰 | 128K 토큰 |
| 입력 → 출력 | 텍스트 및 이미지 → 텍스트 | 텍스트 및 이미지 → 텍스트 |
| 추론 제어 | output_config.effort | reasoning.effort |
| effort 수준 | low–max, 기본값 high | low–max, 기본값 medium |
| 지식 컷오프 | 2026년 6월 | 2026년 4월 30일 |
| 공식 입력 / 출력(100만 토큰당) | $8 / $40 | $2 / $10(입력 ≤272K) $4 / $15(입력 >272K) |
| 공식 캐시 읽기(100만 토큰당) | $0.20 | $0.10(≤272K) / $0.20(>272K) |
| PoYo 입력 / 출력(100만 토큰당) | $6.40 / $32 | $1.60 / $8 |
| PoYo 엔드포인트 | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs Fable 5: 어떤 버전을 비교하고 있나요?
"GPT-5.6 Sol vs Fable 5"로 검색되는 페이지는 대부분 두 모델이 최신이던 2026년 7월에 작성되었습니다. 그 이후 두 라인 모두 새 버전을 출시했습니다.
| 모델 | 개발사 | 출시일 | 출시 당시 공식 입력 / 출력(100만 토큰당, 짧은 컨텍스트) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 2026년 6월 9일 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 2026년 7월 9일 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 2026년 9월 1일 | $10 / $50 |
| GPT-6 Sol | OpenAI | 2026년 9월 22일 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 2026년 9월 29일 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 2026년 11월 9일 | $8 / $40 |
GPT-5.6 Sol vs Claude Fable 5: 2026년 7월의 대결
출시 당시 GPT-5.6 Sol은 Fable 5보다 입력이 절반, 출력이 40% 저렴했습니다($5 / $30 대 $10 / $50, 캐시 입력은 $0.50 대 $1). 그달 공개된 독립 테스트에서는 결과가 엇갈렸습니다.
| 테스트 | 설정 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: 시스템 설계 계획 세 건 | Kilo Code CLI, 두 모델 모두 Max 추론, 미리 작성한 루브릭으로 채점 | 각 계획을 스스로 검토하고 수정한 끝에 세 작업 모두 최고 점수, 계획당 평균 52분 53초, 총 $13.57 | 테스터들이 구현하기 가장 쉽다고 평가한 계획, 계획당 평균 15분 27초, 총 $12.02 |
| Composio: Golden Eval, 여러 앱을 오가는 도구 워크플로 47개 | Fable 5는 Claude Code, Sol은 Codex CLI의 high | 47개 중 45개 통과(95.7%), 작업당 평균 223,779 토큰, 79.6초 | 47개 중 47개 통과(100%), 작업당 평균 276,957 토큰, 84.4초 |
| Analytics Vidhya: 웹 앱, 데이터 분석, 투자자용 자료 | 같은 프롬프트, 새 채팅, 기본 추론 | 비슷한 품질, 실행 시간은 약 2배 | 비슷한 품질에 더 빠른 실행, 한 번에 맡기는 길고 복잡한 작업에 작성자가 고른 모델 |
7월의 패턴은 이렇습니다. GPT-5.6 Sol은 더 낮은 토큰 가격으로 기획과 코딩에 잘 맞았고, 자기 작업을 점검하는 데 시간을 더 썼습니다. Fable 5는 긴 도구 워크플로에 잘 맞았고, 바로 구현하기 쉬운 계획을 작성했습니다.
이 결과는 7월 모델에 관한 것이며, 지금은 이전 세대입니다. 그 이후 가격 차이는 Sol 쪽으로 더 벌어졌습니다. Fable 5는 GPT-5.6 Sol 대비 입력 2배, 출력 약 1.7배였지만, Fable 5.2는 GPT-6.1 Sol의 토큰당 4배입니다. 이 글의 나머지 부분은 현재 조합을 비교합니다. PoYo에서는 GPT-5.6 Sol에 맞춰 조정해 둔 기존 연동을 위해 Responses API로 GPT-5.6 Sol도 제공합니다.
두 모델의 공통점과 차이점
공통점:
- 요청당 약 1M 토큰의 컨텍스트와 128K 출력 토큰.
- 텍스트와 이미지 입력, 텍스트 출력.
low부터max까지 다섯 단계의 effort. 단계의 기준은 업체마다 따로 정하므로 이름이 아니라 결과로 비교하세요.- 프롬프트 캐싱, 스트리밍, 구조화된 출력.
차이점:
- 기본 effort. Fable 5.2의 기본값은
high, Sol은medium입니다. 나란히 비교할 때는 두 모델이 의도한 수준으로 실행되도록 effort를 명시적으로 설정하세요. - 사고 제어. Fable 5.2는 항상 적응형으로 사고하며
tool_choice로auto또는none을 받습니다. Sol은reasoning.effort로 설정하며, 호스팅 도구(웹 검색, 파일 검색, 코드 인터프리터, 호스팅 셸, apply patch, 컴퓨터 사용, MCP, 도구 검색)는 OpenAI Responses API를 통해 실행됩니다. - 지식 컷오프. Fable 5.2는 2026년 6월, Sol은 2026년 4월 30일입니다.
- 데이터 보존. Fable 5.2는 Anthropic API에서 30일 데이터 보존으로 운영됩니다.
가격: 토큰당 4배, 긴 프롬프트에서는 2배
공식 요금(미국 달러, 100만 토큰당)
| 요금 항목 | Claude Fable 5.2 | GPT-6.1 Sol, 입력 ≤272K | GPT-6.1 Sol, 입력 >272K |
|---|---|---|---|
| 입력 | $8.00 | $2.00 | $4.00 |
| 출력 | $40.00 | $10.00 | $15.00 |
| 캐시 읽기 | $0.20 | $0.10 | $0.20 |
| 캐시 쓰기 | $10(5분) / $16(1시간) | $2.50(30분) / $5.00(12시간) | $5.00(30분) / $10.00(12시간) |
OpenAI는 입력 토큰이 272K를 넘는 프롬프트에 대해 요청 전체의 입력과 캐시 요금을 2배, 출력 요금을 1.5배로 청구합니다. Anthropic은 Fable 5.2의 1M 윈도우 전체를 표준 요금으로 청구합니다. PoYo에서는 두 모델 모두 컨텍스트 윈도우 전체에 단일 요금을 적용하므로, GPT-6.1 Sol은 프롬프트 길이와 관계없이 $1.60 / $8입니다. 모든 Claude 모델의 요금은 Claude API 가격 가이드를 참고하세요.
요청당 비용
아래 예시는 두 모델이 같은 수의 토큰을 쓴다고 가정합니다. 실제 사용량은 모델마다 다릅니다(다음 섹션 참고). 캐시 쓰기 요금은 두 모델 모두 제외했습니다.
| 시나리오 | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| 채팅 답변: 입력 20K + 출력 4K | 공식: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | 공식: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| 코딩 작업: 입력 100K + 출력 10K | 공식: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | 공식: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| 긴 문서: 입력 500K + 출력 20K | 공식: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | 공식: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| 에이전트 세션: 캐시 읽기 2M + 새 입력 300K + 출력 150K, 모든 요청 272K 미만 | 공식: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | 공식: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
500K 토큰 프롬프트에서는 Sol의 공식 긴 컨텍스트 요금 때문에 격차가 4배에서 약 2.1배로 줄어듭니다. PoYo에서는 같은 요청이 GPT-6.1 Sol 기준 $0.96입니다. PoYo는 Sol을 긴 컨텍스트 배율 없이 단일 요금으로 청구하기 때문입니다.
완료된 작업당 비용
토큰 단가는 청구액의 절반일 뿐입니다. Artificial Analysis는 두 모델을 같은 Intelligence Index 작업으로 실행하고 그 비용을 공개합니다.
| Max effort | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| 인덱스 작업당 비용 | $26.54 | $1.27 |
| 인덱스 작업당 시간 | 45.3분 | 23.3분 |
| 인덱스 점수 | 65 | 55 |
가격 차이는 4배인데 비용 차이는 약 21배입니다. Fable 5.2는 작업마다 훨씬 많은 추론을 투입하고 이것이 높은 점수로 이어지는 반면, Sol은 훨씬 적은 토큰으로 작업을 끝냅니다. 실제 워크로드에서는 토큰 단가와 함께 승인된 작업당 총 청구액을 비교하세요.
벤치마크
같은 조건: Artificial Analysis Intelligence Index
Artificial Analysis는 같은 작업과 하네스로 두 모델을 평가하므로 수치를 바로 비교할 수 있습니다. 2026년 11월 14일에 확인한 Intelligence Index v5.0.1 결과입니다.
| effort | Fable 5.2 점수 | GPT-6.1 Sol 점수 | Fable 5.2 작업당 시간 | Sol 작업당 시간 |
|---|---|---|---|---|
low | 54 | 35 | 5.8분 | 2.0분 |
medium | 56 | 46 | 7.7분 | 4.6분 |
high | 62 | 50 | 16.2분 | 7.9분 |
xhigh | 62 | 52 | 27.9분 | 10.7분 |
max | 65 | 55 | 45.3분 | 23.3분 |
표를 읽는 방법:
- Fable 5.2는 모든 수준에서 10–19점 더 높으며, 답변 품질이 가장 중요한 작업에 잘 맞습니다.
low의 Fable 5.2는max의 Sol에 근접한 점수(54 대 55)를 4분의 1의 시간에 냅니다.- Sol은 낮은 비용으로 점수를 냅니다. max effort에서 인덱스 작업당 $1.27로, 대량 처리와 예산에 민감한 작업에 잘 맞습니다.
- Fable은 토큰을 더 빠르게 생성합니다. 초당 출력 토큰이 약 94–102개로, Sol의 47–49개보다 많습니다.
- Artificial Analysis는 Fable 5.2 실행에 "Default Fallback" 표시를 붙였습니다. 테스트 중 Anthropic의 거절 대체 기능이 켜져 있었다는 뜻입니다.
Anthropic의 출시 결과
Anthropic의 Fable 5.2 표는 OpenAI 최상위 등급인 GPT-6 Astra와 비교합니다. 별도 표기가 없으면 각 모델의 사용 가능한 최고 effort 기준입니다.
| 벤치마크 | 측정 대상 | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | 에이전트 코딩 | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | 소프트웨어 엔지니어링 | 69.9% | 65.5% |
| AutomationBench | 비즈니스 워크플로 | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | 에이전트 기반 과학 연구 | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | 컴퓨터 사용 | 89.3% | 79.5% |
| Remote Labor Index | 실제 유료 작업 | 41.3% (high) | 20.8% |
| Humanity's Last Exam (도구 사용) | 고난도 추론 | 74.2% | 57.2% |
| Chartography (도구 미사용) | 차트 추론 | 73.4% | 71.0% |

effort 수준별 FrontierCode 2.0 점수와 작업당 비용. Anthropic의 Claude Fable 5.2 출시 자료 차트입니다.
OpenAI의 출시 결과
OpenAI는 Fable 5.2보다 6주 앞선 2026년 9월 29일에 GPT-6.1 Sol을 출시하고 자사 GPT-6 모델과 비교했습니다. OpenAI는 이 모델을 복잡한 코딩, 컴퓨터 사용, 전문 업무용으로 소개하며, GPT-6 Astra에 근접한 능력을 Astra 토큰 가격의 5분의 1($2 / $10 대 $10 / $50)로 제공한다고 설명합니다. 출시 평가는 소프트웨어 엔지니어링, 문서 이해, 비즈니스 자동화, 컴퓨터 사용을 다룹니다.
업체마다 자체 하네스와 테스트 버전으로 벤치마크를 실행하므로, 점수는 한 업체의 표 안에서 비교하고 직접 비교에는 위의 Artificial Analysis 인덱스를 활용하세요.
무엇을 선택해야 할까요?
| 워크로드 | 먼저 사용할 모델 | 이유 |
|---|---|---|
| 대량 채팅, 정보 추출, 라우팅 | medium의 GPT-6.1 Sol(또는 더 작은 모델) | Fable 토큰 가격의 4분의 1로 짧은 작업 처리 |
| 예산에 맞춘 일상적인 코딩과 에이전트 루프 | GPT-6.1 Sol | 코딩과 에이전트 작업용으로 설계, 공식 $2 / $10, PoYo $1.60 / $8 |
| 가장 어려운 추론, 연구, 장시간 자율 실행 | Fable 5.2 | Intelligence Index 65 대 55, Anthropic 표 전반에서 GPT-6 Astra를 앞섬 |
| 대기 시간이 비용으로 이어지는 어려운 문제 | low 또는 medium의 Fable 5.2 | 4분의 1의 시간으로 Sol 최고 점수에 근접 |
| 컴퓨터 사용, 차트, 밀도 높은 시각 문서 | Fable 5.2 | Anthropic 표에서 OSWorld 2.1 89.3%, Chartography 73.4% |
| 프롬프트가 자주 272K 토큰을 넘는 경우 | 비용은 PoYo의 GPT-6.1 Sol, 깊이는 Fable 5.2 | PoYo에서는 두 모델 모두 윈도우 전체에 단일 요금: Sol $1.60 / $8, Fable $6.40 / $32 |
| OpenAI 호스팅 도구(셸, 웹 검색, MCP) 기반 | GPT-6.1 Sol | 이 도구들이 Responses API에서 네이티브로 실행 |
| 더 낮은 가격으로 Claude 품질이 필요할 때 | Claude Opus 5.5 | $4 / $20, Claude Fable 5.2 vs Opus 5.5 참고 |
장시간 자율 실행은 Fable 5.2에 잘 맞습니다. Fable 5.2 에이전트가 만든 운영체제 프로토타입이 노트북에서 실행되는 모습입니다. Anthropic의 Claude Fable 5.2 출시 자료 영상입니다.
실용적인 라우팅 방법은 이렇습니다. 일상적인 트래픽은 medium의 GPT-6.1 Sol로 보내고, 더 깊은 추론이 도움이 되는 작업 유형을 기록해 두었다가 그런 작업을 medium의 Fable 5.2로 보냅니다. 일주일 뒤에는 토큰 가격이 아니라 승인된 작업당 비용을 비교하세요. Sol과 비교할 중간 가격대 Claude 모델은 GPT-6.1 Sol vs Claude Opus 5.5를 참고하세요.
PoYo에서 두 모델 모두 사용하기
PoYo에서는 두 모델을 간편하게 함께 쓸 수 있습니다.
- API 키 하나로 Fable 5.2, GPT-6.1 Sol을 비롯한 모든 채팅·이미지·영상·오디오 모델을 사용합니다.
- 사용한 만큼만 냅니다. 토큰 단위로 크레딧이 청구되며 구독이 필요 없습니다.
- 두 API 형식을 모두 지원합니다. Anthropic Messages, OpenAI Chat Completions와 Responses를 사용할 수 있습니다.
- 모델마다 컨텍스트 윈도우 전체에 단일 요금을 적용하며, 각 공식 짧은 컨텍스트 요금보다 20% 저렴합니다.
| 요금 항목(100만 토큰당) | PoYo의 Claude Fable 5.2 | PoYo의 GPT-6.1 Sol |
|---|---|---|
| 입력 | $6.40 | $1.60 |
| 출력 | $32.00 | $8.00 |
| 캐시 읽기 | $0.16 | $0.08 |
| 캐시 쓰기 | $8.00(5분) / $12.80(1시간) | $2.00 |
Anthropic Messages 형식으로 호출하는 Fable 5.2:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "이 diff에 동시성 버그가 있는지 검토해 주세요: ..."}]
  }'
Responses API로 호출하는 GPT-6.1 Sol:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "이 diff에 동시성 버그가 있는지 검토해 주세요: ..."
  }'
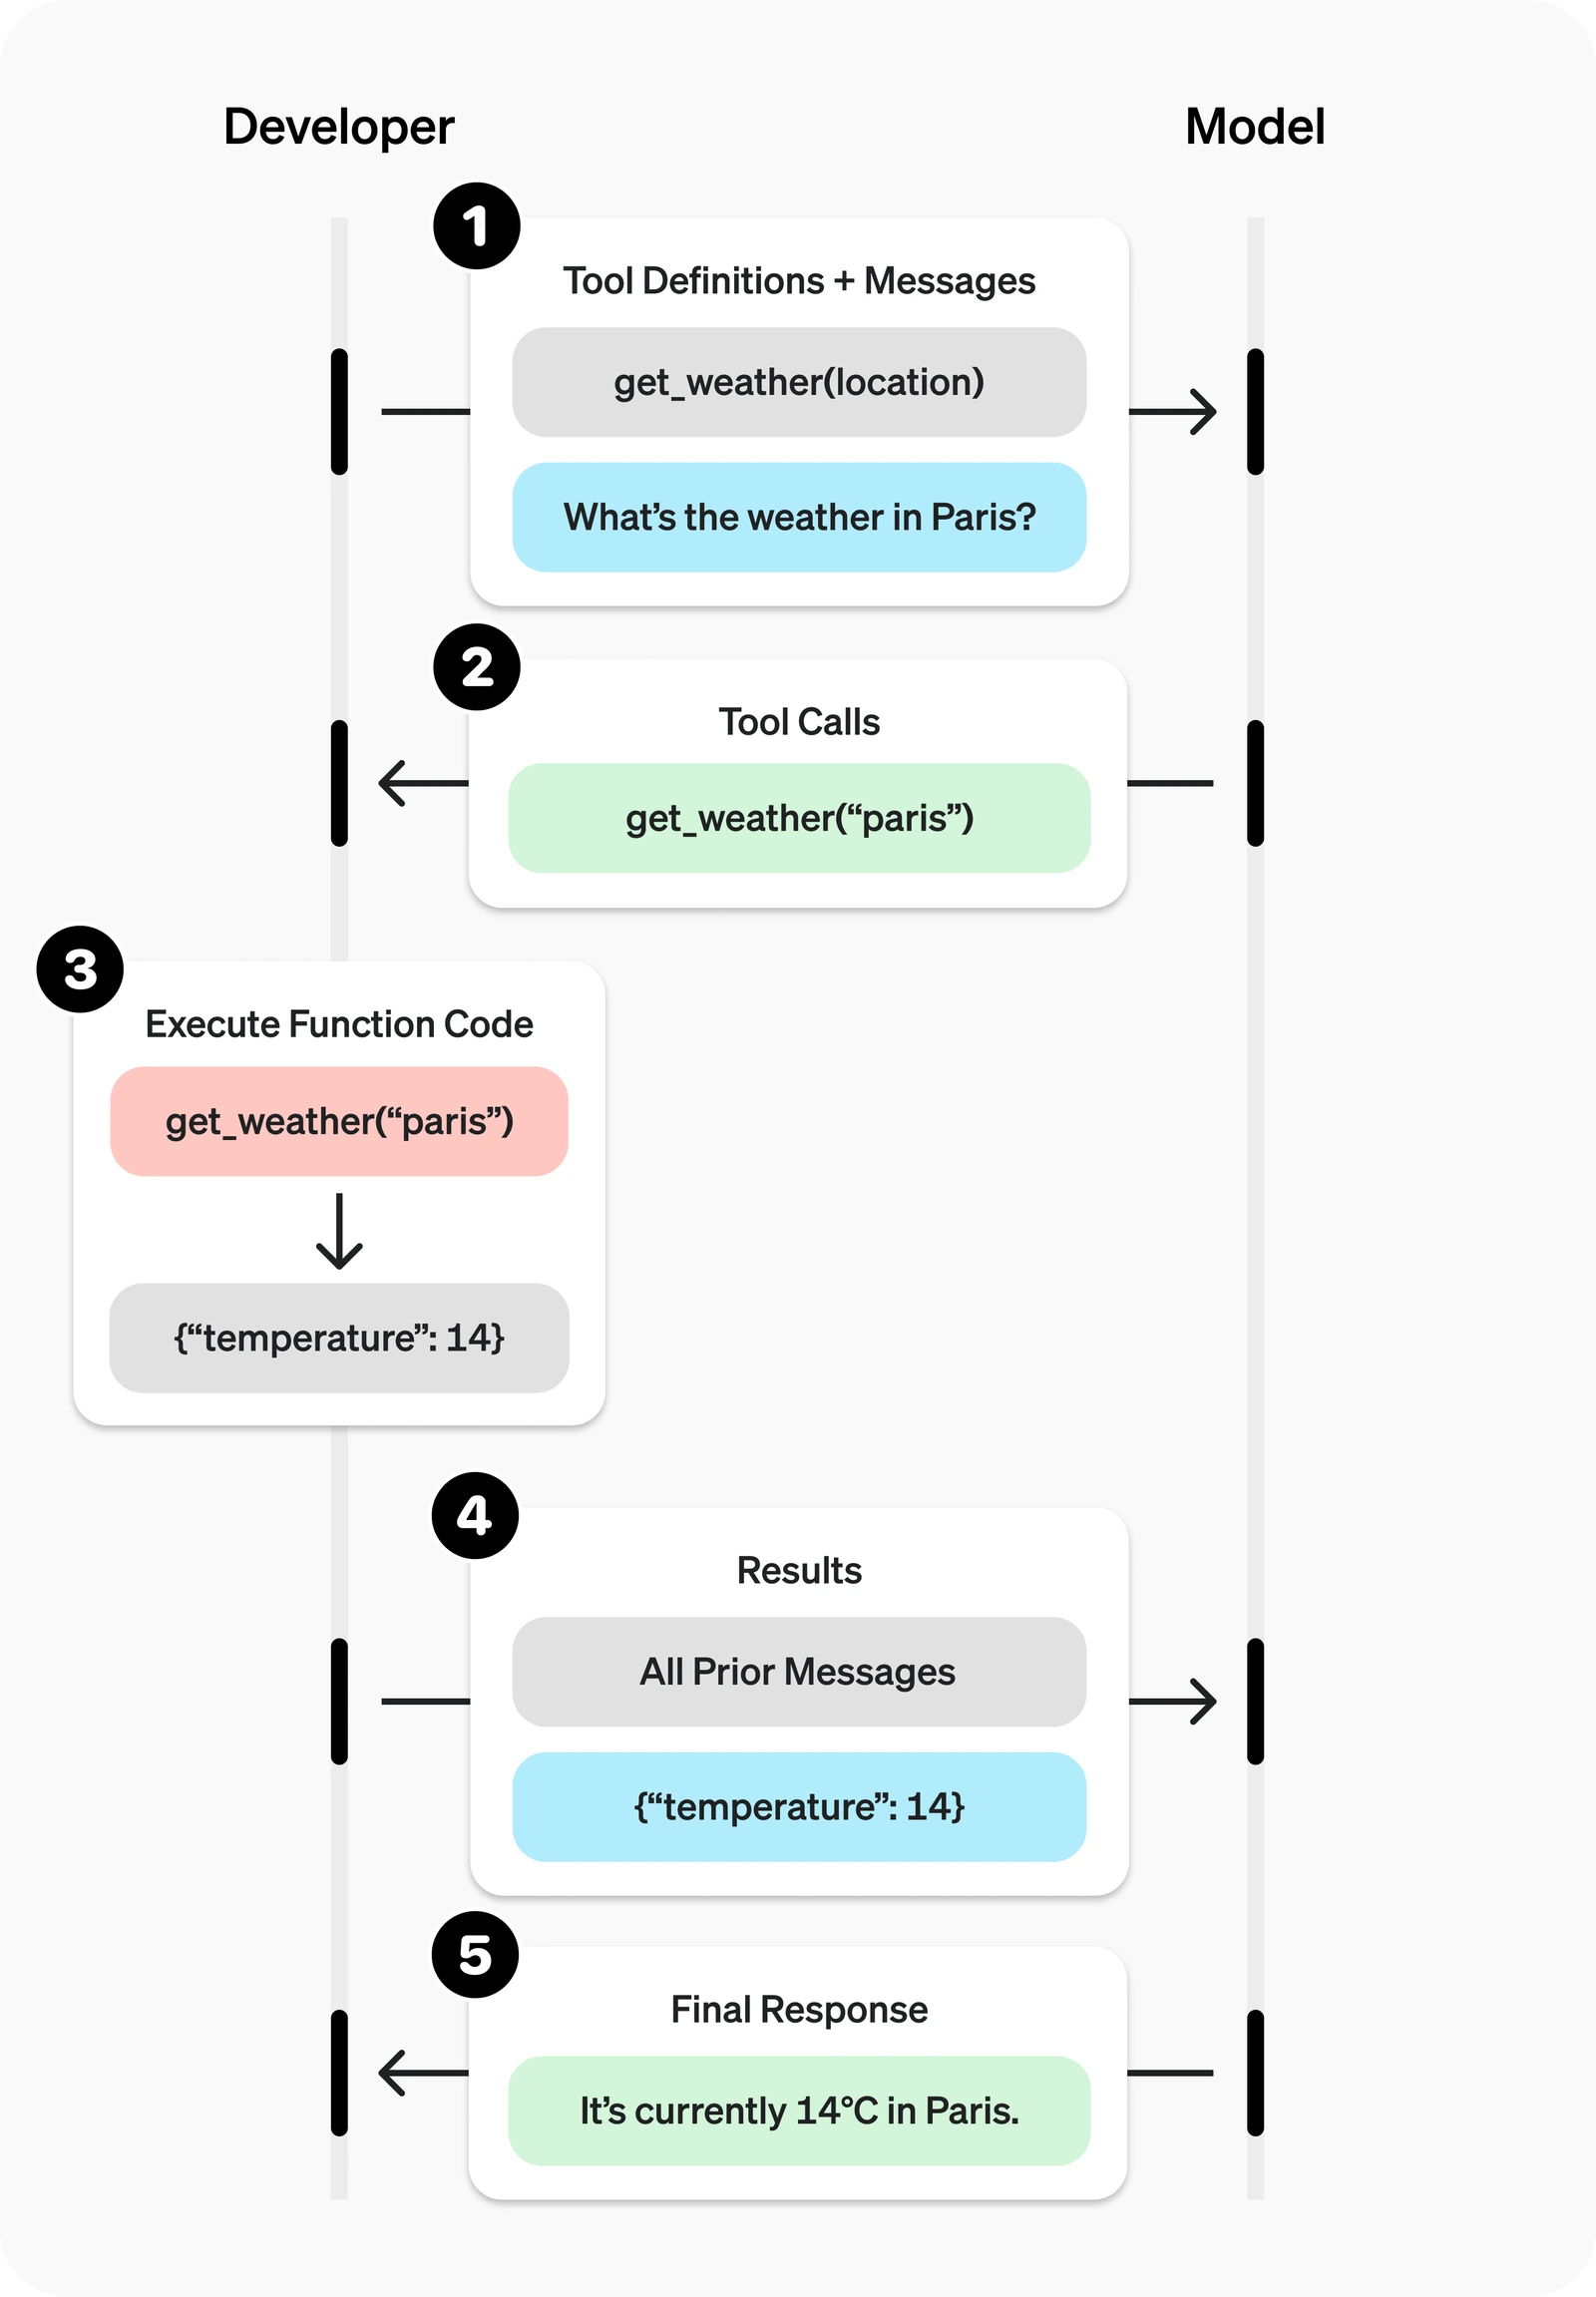
GPT-6.1 Sol이 도구 작업에 사용하는 함수 호출 루프. OpenAI 공식 문서의 다이어그램입니다.
하나의 코드 경로에서 두 모델을 A/B 테스트하려면 claude-fable-5-2와 gpt-6.1-sol을 /v1/chat/completions로 보내고 model 필드만 바꾸세요. Fable의 SDK 설정, effort, 캐싱은 Claude Fable 5.2 API 가이드를, Sol의 한도와 도구는 GPT-6.1 Sol 기능 가이드를 참고하세요.
모델 페이지: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
자주 묻는 질문
Fable 5가 GPT-5.6 Sol보다 나은가요?
두 모델은 잘 맞는 작업이 달랐습니다. 2026년 7월 테스트에서 Fable 5는 Composio의 다중 앱 도구 워크플로 47개를 모두 통과했고(GPT-5.6 Sol은 45개), GPT-5.6 Sol은 Kilo의 시스템 설계 기획 작업 세 건 모두에서 더 낮은 토큰 가격으로 최고 점수를 받았습니다. 현재 세대에서는 Artificial Analysis Intelligence Index에서 Fable 5.2가 65점, GPT-6.1 Sol이 55점이며, Sol의 작업당 비용은 훨씬 적습니다.
GPT Astra가 Fable보다 나을까요?
GPT-6 Astra는 이미 100만 토큰당 $10 / $50으로 제공되고 있습니다. Anthropic의 Fable 5.2 출시 표에서는 두 모델이 함께 측정된 모든 벤치마크에서 Fable 5.2가 GPT-6 Astra보다 높은 점수를 기록했습니다. 예를 들어 Terminal-Bench-Science 0.1에서 74.6% 대 68.1%, OSWorld 2.1에서 89.3% 대 79.5%입니다. 이는 Anthropic이 직접 실행한 결과이므로, 결정하기 전에 실제 작업으로 두 모델을 테스트해 보세요.
GPT-5.6 Luna가 더 나은가요?
Luna는 GPT-5.6에서 가장 작고 가장 경제적인 등급으로 빠른 대량 작업용이며, Sol은 더 어려운 작업에 어울립니다. 처리량과 비용을 중시한다면 Luna, 깊이를 중시한다면 Sol을 고르세요. 현재 세대에서 GPT-6 Luna의 정가는 100만 토큰당 $0.10 / $0.50입니다.
GPT-5.6 Sol은 쓸 만한가요?
GPT-5.6 Sol은 이전 세대 모델입니다. 새 프로젝트라면 OpenAI의 현재 Sol 모델인 GPT-6.1 Sol을 추천합니다. 짧은 컨텍스트 기준 100만 토큰당 $2 / $10이며, PoYo에서는 컨텍스트 윈도우 전체에서 $1.60 / $8입니다. GPT-5.6 Sol은 이미 이 모델에 맞춰 조정된 연동에 여전히 잘 맞습니다.
Claude Fable 5.2가 GPT-6.1 Sol보다 나은가요?
최대 성능이 목표라면 Fable 5.2를 고르세요. Artificial Analysis Intelligence Index의 모든 effort 수준에서 10–19점 더 높습니다. 비용이 우선이라면 GPT-6.1 Sol을 고르세요. 토큰 단가는 4분의 1이고, max effort에서 인덱스 작업당 비용은 약 20분의 1입니다.
Fable 5.2와 GPT-6.1 Sol 중 어느 쪽이 더 저렴한가요?
GPT-6.1 Sol입니다. 공식 가격은 입력/출력 토큰 100만 개당 $2 / $10이고, Fable 5.2는 $8 / $40입니다. 입력이 272K 토큰을 넘으면 OpenAI는 Sol의 요청 전체를 $4 / $15로 올리고, Fable은 $8 / $40을 유지합니다. PoYo에서는 Sol이 프롬프트 길이와 관계없이 $1.60 / $8입니다.
코딩에는 어느 쪽이 더 좋은가요?
두 업체는 서로 다른 벤치마크로 코딩 결과를 발표합니다. Anthropic은 Fable 5.2가 FrontierCode 2.0에서 49.1%로 GPT-6 Astra를 앞선다고 발표했고, OpenAI는 GPT-6.1 Sol을 Astra 토큰 가격의 5분의 1로 복잡한 코딩을 처리하도록 만들었습니다. 무난한 기본 구성은 대량의 일상적인 코딩에는 Sol, 크고 오래 걸리는 변경에는 Fable 5.2를 쓰는 것입니다. 실제 티켓 일부로 두 모델을 모두 실행해 보세요.
두 모델 모두 1M 컨텍스트 윈도우를 지원하나요?
네, 대략 그렇습니다. Fable 5.2는 1M 토큰 윈도우를 갖추고 있습니다. GPT-6.1 Sol은 1,050,000 토큰 윈도우에 최대 922,000 입력 토큰을 지원합니다. 두 모델 모두 요청당 최대 128K 출력 토큰을 생성합니다.