
Det viktigste
- Fable 5.2 passer til det mest krevende arbeidet; GPT-6.1 Sol passer til arbeid i store volum. På Artificial Analysis Intelligence Index får Fable 5.2 65 og GPT-6.1 Sol 55 på maks effort, og Sol løser hver indeksoppgave for en brøkdel av kostnaden.
- Offisielle tokenpriser: $8 / $40 per million input-/outputtokens for Fable 5.2 og $2 / $10 for Sol med kort kontekst, en forskjell på 4×.
- Én fast pris hos PoYo. OpenAI øker prisen for hele forespørselen til Sol til $4 / $15 over 272K inputtokens. Hos PoYo koster GPT-6.1 Sol $1.60 / $8 i hele kontekstvinduet, og Fable 5.2 koster $6.40 / $32 i hele vinduet på 1M.
- Fable 5.2 legger mer resonnering i hver oppgave. Artificial Analysis målte $26.54 per indeksoppgave for Fable 5.2 på maks effort og $1.27 for Sol.
- Fable 5.2 når sterke resultater raskt. På
loweffort får den 54, nær Sols 55 påmax, og fullfører en indeksoppgave på 5.8 minutter mot 23.3. - Søker du etter «GPT-5.6 Sol vs Fable 5»? Det var oppgjøret i juli 2026. Begge modellfamiliene har gått videre; avsnittet nedenfor tar for seg det gamle paret for seg.
Claude Fable 5.2 vs GPT-6.1 Sol i korte trekk
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Utvikler | Anthropic | OpenAI |
| Modell-ID i API-et | claude-fable-5-2 | gpt-6.1-sol |
| Lansert | 9. november 2026 | 29. september 2026 |
| Plassering | Anthropics toppnivå, over Opus | OpenAIs Sol-nivå, mellom GPT-6 Astra og GPT-6 Luna |
| Kontekstvindu | 1M tokens | 1 050 000 tokens (maks input 922 000) |
| Maks output | 128K tokens | 128K tokens |
| Input → output | Tekst og bilder → tekst | Tekst og bilder → tekst |
| Styring av resonnering | output_config.effort | reasoning.effort |
| Effort-nivåer | low til max, standard high | low til max, standard medium |
| Kunnskapsgrense | juni 2026 | 30. april 2026 |
| Offisiell input / output (per 1M) | $8 / $40 | $2 / $10 (input ≤272K) $4 / $15 (input >272K) |
| Offisiell cachelesing (per 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| PoYo input / output (per 1M) | $6.40 / $32 | $1.60 / $8 |
| Endepunkter hos PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs Fable 5: hvilke versjoner sammenligner du?
De fleste sidene som rangerer for «GPT-5.6 Sol vs Fable 5», ble skrevet i juli 2026, da de to var de nyeste modellene. Siden har begge modellfamiliene fått nyere versjoner:
| Modell | Utvikler | Lansert | Offisiell input / output ved lansering (per 1M, kort kontekst) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9. juni 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9. juli 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1. september 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22. september 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29. september 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9. november 2026 | $8 / $40 |
GPT-5.6 Sol vs Claude Fable 5: oppgjøret i juli 2026
Ved lanseringen kostet GPT-5.6 Sol halvparten så mye som Fable 5 for input og 40 % mindre for output ($5 / $30 mot $10 / $50, med cachet input til $0.50 mot $1). Uavhengige tester fra samme måned ga ulike konklusjoner:
| Test | Oppsett | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: tre planer for systemdesign | Kilo Code CLI, begge på Max-resonnering, vurdert etter en rubric skrevet på forhånd | Toppresultat på alle tre oppgavene, etter at modellen selv hadde gjennomgått og revidert hver plan; i snitt 52 min 53 s per plan; $13.57 totalt | Planene testerne syntes det var lettest å bygge videre på; i snitt 15 min 27 s per plan; $12.02 totalt |
| Composio: Golden Eval, 47 verktøyarbeidsflyter på tvers av apper | Fable 5 i Claude Code; Sol i Codex CLI på high | 45 av 47 bestått (95.7%); i snitt 223 779 tokens og 79.6 s per oppgave | 47 av 47 bestått (100%); i snitt 276 957 tokens og 84.4 s per oppgave |
| Analytics Vidhya: nettapp, dataanalyse, investorpresentasjon | Samme prompter, nye chatter, standard resonnering | Sammenlignbar kvalitet, med omtrent dobbel kjøretid | Sammenlignbar kvalitet og raskere kjøringer; forfatterens valg for langt, komplekst arbeid som overlates i ett stykke |
Mønsteret i juli: GPT-5.6 Sol passet til planlegging og koding til en lavere tokenpris og brukte ekstra tid på å kontrollere sitt eget arbeid; Fable 5 passet til lange verktøyarbeidsflyter og skrev planer det var lett å bygge videre på.
Disse resultatene gjelder modellene fra juli, som nå er forrige generasjon. Siden har prisforskjellen økt i Sols favør: Fable 5.2 koster 4× så mye som GPT-6.1 Sol per token, mens Fable 5 kostet 2× så mye som GPT-5.6 Sol for input og omtrent 1.7× for output. Resten av artikkelen sammenligner det nåværende paret. Hos PoYo er GPT-5.6 Sol tilgjengelig via Responses API for integrasjoner som allerede er tilpasset den.
Dette har de to modellene felles, og her skiller de seg
Felles:
- Omtrent 1M tokens kontekst og 128K outputtokens per forespørsel.
- Tekst- og bildeinput, tekstoutput.
- Fem effort-nivåer, fra
lowtilmax. Hver leverandør kalibrerer sine egne nivåer, så sammenlign resultater i stedet for etiketter. - Prompt caching, strømming og strukturert output.
Forskjeller:
- Standard-effort. Fable 5.2 bruker
highsom standard; Sol brukermedium. Sett effort eksplisitt i tester side om side, slik at begge kjører på nivået du ønsker. - Styring av tenking. Fable 5.2 tenker alltid adaptivt og godtar
tool_choicemedautoellernone. Sol konfigureres viareasoning.effort, og de hostede verktøyene (nettsøk, filsøk, kodetolker, hostet shell, apply patch, datamaskinbruk, MCP, verktøysøk) kjører via OpenAIs Responses API. - Kunnskapsgrense. Juni 2026 for Fable 5.2; 30. april 2026 for Sol.
- Datalagring. Fable 5.2 kjører med datalagring i 30 dager i Anthropics API.
Priser: 4× per token, 2× på lange prompter
Offisielle priser (USD per 1M tokens)
| Kostnad | Claude Fable 5.2 | GPT-6.1 Sol, input ≤272K | GPT-6.1 Sol, input >272K |
|---|---|---|---|
| Input | $8.00 | $2.00 | $4.00 |
| Output | $40.00 | $10.00 | $15.00 |
| Cachelesing | $0.20 | $0.10 | $0.20 |
| Cacheskriving | $10 (5 min) / $16 (1 time) | $2.50 (30 min) / $5.00 (12 timer) | $5.00 (30 min) / $10.00 (12 timer) |
OpenAI priser prompter med mer enn 272K inputtokens til 2× input- og cacheprisene og 1.5× outputprisen, for hele forespørselen. Anthropic fakturerer hele vinduet på 1M for Fable 5.2 til standardpris. Hos PoYo bruker begge modellene én pris i hele kontekstvinduet, så GPT-6.1 Sol blir værende på $1.60 / $8 uansett hvor lang prompten er. For prisene på alle Claude-modeller, se prisguiden vår for Claude API-et.
Kostnad per forespørsel
Eksemplene forutsetter at begge modellene bruker like mange tokens; det faktiske forbruket varierer fra modell til modell (se neste avsnitt). Kostnader for cacheskriving er holdt utenfor for begge.
| Scenario | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Chatsvar: 20K input + 4K output | Offisielt: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Offisielt: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Kodeoppgave: 100K input + 10K output | Offisielt: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Offisielt: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Langt dokument: 500K input + 20K output | Offisielt: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Offisielt: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Agentøkt: 2M cachede lesinger + 300K ny input + 150K output, hver forespørsel under 272K | Offisielt: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Offisielt: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
På en prompt på 500K tokens reduserer Sols offisielle pris for lang kontekst forskjellen fra 4× til omtrent 2.1×. Hos PoYo koster den samme forespørselen $0.96 på GPT-6.1 Sol, fordi PoYo fakturerer Sol til én pris uten multiplikator for lang kontekst.
Kostnad per fullført oppgave
Tokenprisen er bare halve regningen. Artificial Analysis kjører begge modellene gjennom de samme oppgavene i Intelligence Index og publiserer kostnaden:
| Maks effort | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Kostnad per indeksoppgave | $26.54 | $1.27 |
| Tid per indeksoppgave | 45.3 min | 23.3 min |
| Indeksresultat | 65 | 55 |
Kostnadsforskjellen er omtrent 21×, mot en prisforskjell på 4×: Fable 5.2 legger langt mer resonnering i hver oppgave, og det er der de høyere resultatene kommer fra, mens Sol fullfører oppgavene med langt færre tokens. På ekte arbeidsmengder bør du sammenligne den totale regningen per godkjent oppgave sammen med tokenprisen.
Benchmarks
Samme oppsett: Artificial Analysis Intelligence Index
Artificial Analysis evaluerer begge modellene med de samme oppgavene og det samme testoppsettet, så tallene kan sammenlignes direkte. Intelligence Index v5.0.1, avlest 14. november 2026:
| Effort | Resultat for Fable 5.2 | Resultat for GPT-6.1 Sol | Tid per oppgave for Fable 5.2 | Tid per oppgave for Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 min | 2.0 min |
medium | 56 | 46 | 7.7 min | 4.6 min |
high | 62 | 50 | 16.2 min | 7.9 min |
xhigh | 62 | 52 | 27.9 min | 10.7 min |
max | 65 | 55 | 45.3 min | 23.3 min |
Slik leser du tabellen:
- Fable 5.2 scorer høyere på hvert nivå, med 10 til 19 poeng, noe som passer til arbeid der kvaliteten på svaret betyr mest.
- Fable 5.2 på
lowscorer nær Sol påmax(54 mot 55) på en firedel av tiden. - Sol leverer resultatene sine til lav kostnad: $1.27 per indeksoppgave på maks effort, noe som passer til arbeid i store volum og med stram budsjettramme.
- Fable genererer tokens raskere: omtrent 94–102 outputtokens per sekund mot 47–49 for Sol.
- Artificial Analysis merker kjøringene av Fable 5.2 med «Default Fallback», som betyr at Anthropics reserveløsning ved avslag var slått på under testingen.
Anthropics lanseringsresultater
Anthropics tabell for Fable 5.2 sammenligner den med GPT-6 Astra, OpenAIs toppnivå. Hver modell kjørte på høyeste tilgjengelige effort med mindre annet er oppgitt:
| Benchmark | Hva den måler | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Agentbasert koding | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Programvareutvikling | 69.9% | 65.5% |
| AutomationBench | Forretningsarbeidsflyter | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Agentbasert forskning | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Datamaskinbruk | 89.3% | 79.5% |
| Remote Labor Index | Ekte betalte oppgaver | 41.3% (high) | 20.8% |
| Humanity's Last Exam (med verktøy) | Krevende resonnering | 74.2% | 57.2% |
| Chartography (uten verktøy) | Resonnering om diagrammer | 73.4% | 71.0% |

Resultat på FrontierCode 2.0 mot kostnad per oppgave på hvert effort-nivå. Diagram fra Anthropics lanseringsmateriale for Claude Fable 5.2.
OpenAIs lanseringsresultater
OpenAI lanserte GPT-6.1 Sol 29. september 2026, seks uker før Fable 5.2, og sammenlignet den med sine egne GPT-6-modeller. OpenAI posisjonerer den for kompleks koding, datamaskinbruk og profesjonelt arbeid, med kapasitet som nærmer seg GPT-6 Astra til en femtedel av Astras tokenpris ($2 / $10 mot $10 / $50). Lanseringsevalueringene dekker programvareutvikling, dokumentforståelse, forretningsautomatisering og datamaskinbruk.
Hver leverandør kjører benchmarks i sitt eget testoppsett og sin egen testversjon, så sammenlign resultater innenfor én leverandørs tabell, og bruk indeksen fra Artificial Analysis over for en direkte sammenligning.
Hvilken bør du velge?
| Arbeidsmengden din | Start med | Hvorfor |
|---|---|---|
| Chat, uttrekk og ruting i store volum | GPT-6.1 Sol på medium (eller en mindre modell) | Håndterer korte oppgaver til en firedel av Fables tokenpris |
| Daglig koding og agentløkker med stramt budsjett | GPT-6.1 Sol | Laget for koding og agentarbeid, til $2 / $10 offisielt og $1.60 / $8 hos PoYo |
| Den mest krevende resonneringen, forskning, lange autonome kjøringer | Fable 5.2 | 65 mot 55 på Intelligence Index; leder over GPT-6 Astra i hele Anthropics tabell |
| Krevende problemer der venting koster | Fable 5.2 på low eller medium | Scorer nær Sols maks på en firedel av tiden |
| Datamaskinbruk, diagrammer, tette visuelle dokumenter | Fable 5.2 | 89.3 % på OSWorld 2.1 og 73.4 % på Chartography i Anthropics tabell |
| Prompter som jevnlig går over 272K tokens | GPT-6.1 Sol hos PoYo for kostnad, Fable 5.2 for dybde | Hos PoYo har begge én pris i hele vinduet: $1.60 / $8 for Sol, $6.40 / $32 for Fable |
| Bygget på OpenAIs hostede verktøy (shell, nettsøk, MCP) | GPT-6.1 Sol | Disse verktøyene kjører innebygd via Responses API |
| Claude-kvalitet til lavere pris | Claude Opus 5.5 | $4 / $20; se Claude Fable 5.2 vs Opus 5.5 |
Lange autonome kjøringer passer Fable 5.2: Agentene bygde denne prototypen av et operativsystem, her kjørt på en bærbar PC. Video fra Anthropics lanseringsmateriale for Claude Fable 5.2.
Et praktisk rutingoppsett: Send rutinetrafikk til GPT-6.1 Sol på medium, noter hvilke oppgavetyper som har nytte av dypere resonnering, og rut dem til Fable 5.2 på medium. Etter en uke sammenligner du kostnaden per godkjent oppgave i stedet for tokenprisene. For det mellomprisede Claude-alternativet mot Sol, se GPT-6.1 Sol vs Claude Opus 5.5.
Bruk begge hos PoYo
PoYo gjør det enkelt å kjøre begge:
- Én API-nøkkel for Fable 5.2, GPT-6.1 Sol og alle andre modeller for chat, bilde, video og lyd.
- Betal etter forbruk, fakturert per token i kreditter, uten abonnement.
- Begge API-formatene: Anthropic Messages samt OpenAI Chat Completions og Responses.
- Én pris per modell i hele kontekstvinduet, 20 % under hver offisiell pris for kort kontekst:
| Kostnad (per 1M tokens) | Claude Fable 5.2 hos PoYo | GPT-6.1 Sol hos PoYo |
|---|---|---|
| Input | $6.40 | $1.60 |
| Output | $32.00 | $8.00 |
| Cachelesing | $0.16 | $0.08 |
| Cacheskriving | $8.00 (5 min) / $12.80 (1 time) | $2.00 |
Fable 5.2 via Anthropic Messages-formatet:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Gå gjennom denne diffen og se etter samtidighetsfeil: ..."}]
  }'
GPT-6.1 Sol via Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Gå gjennom denne diffen og se etter samtidighetsfeil: ..."
  }'
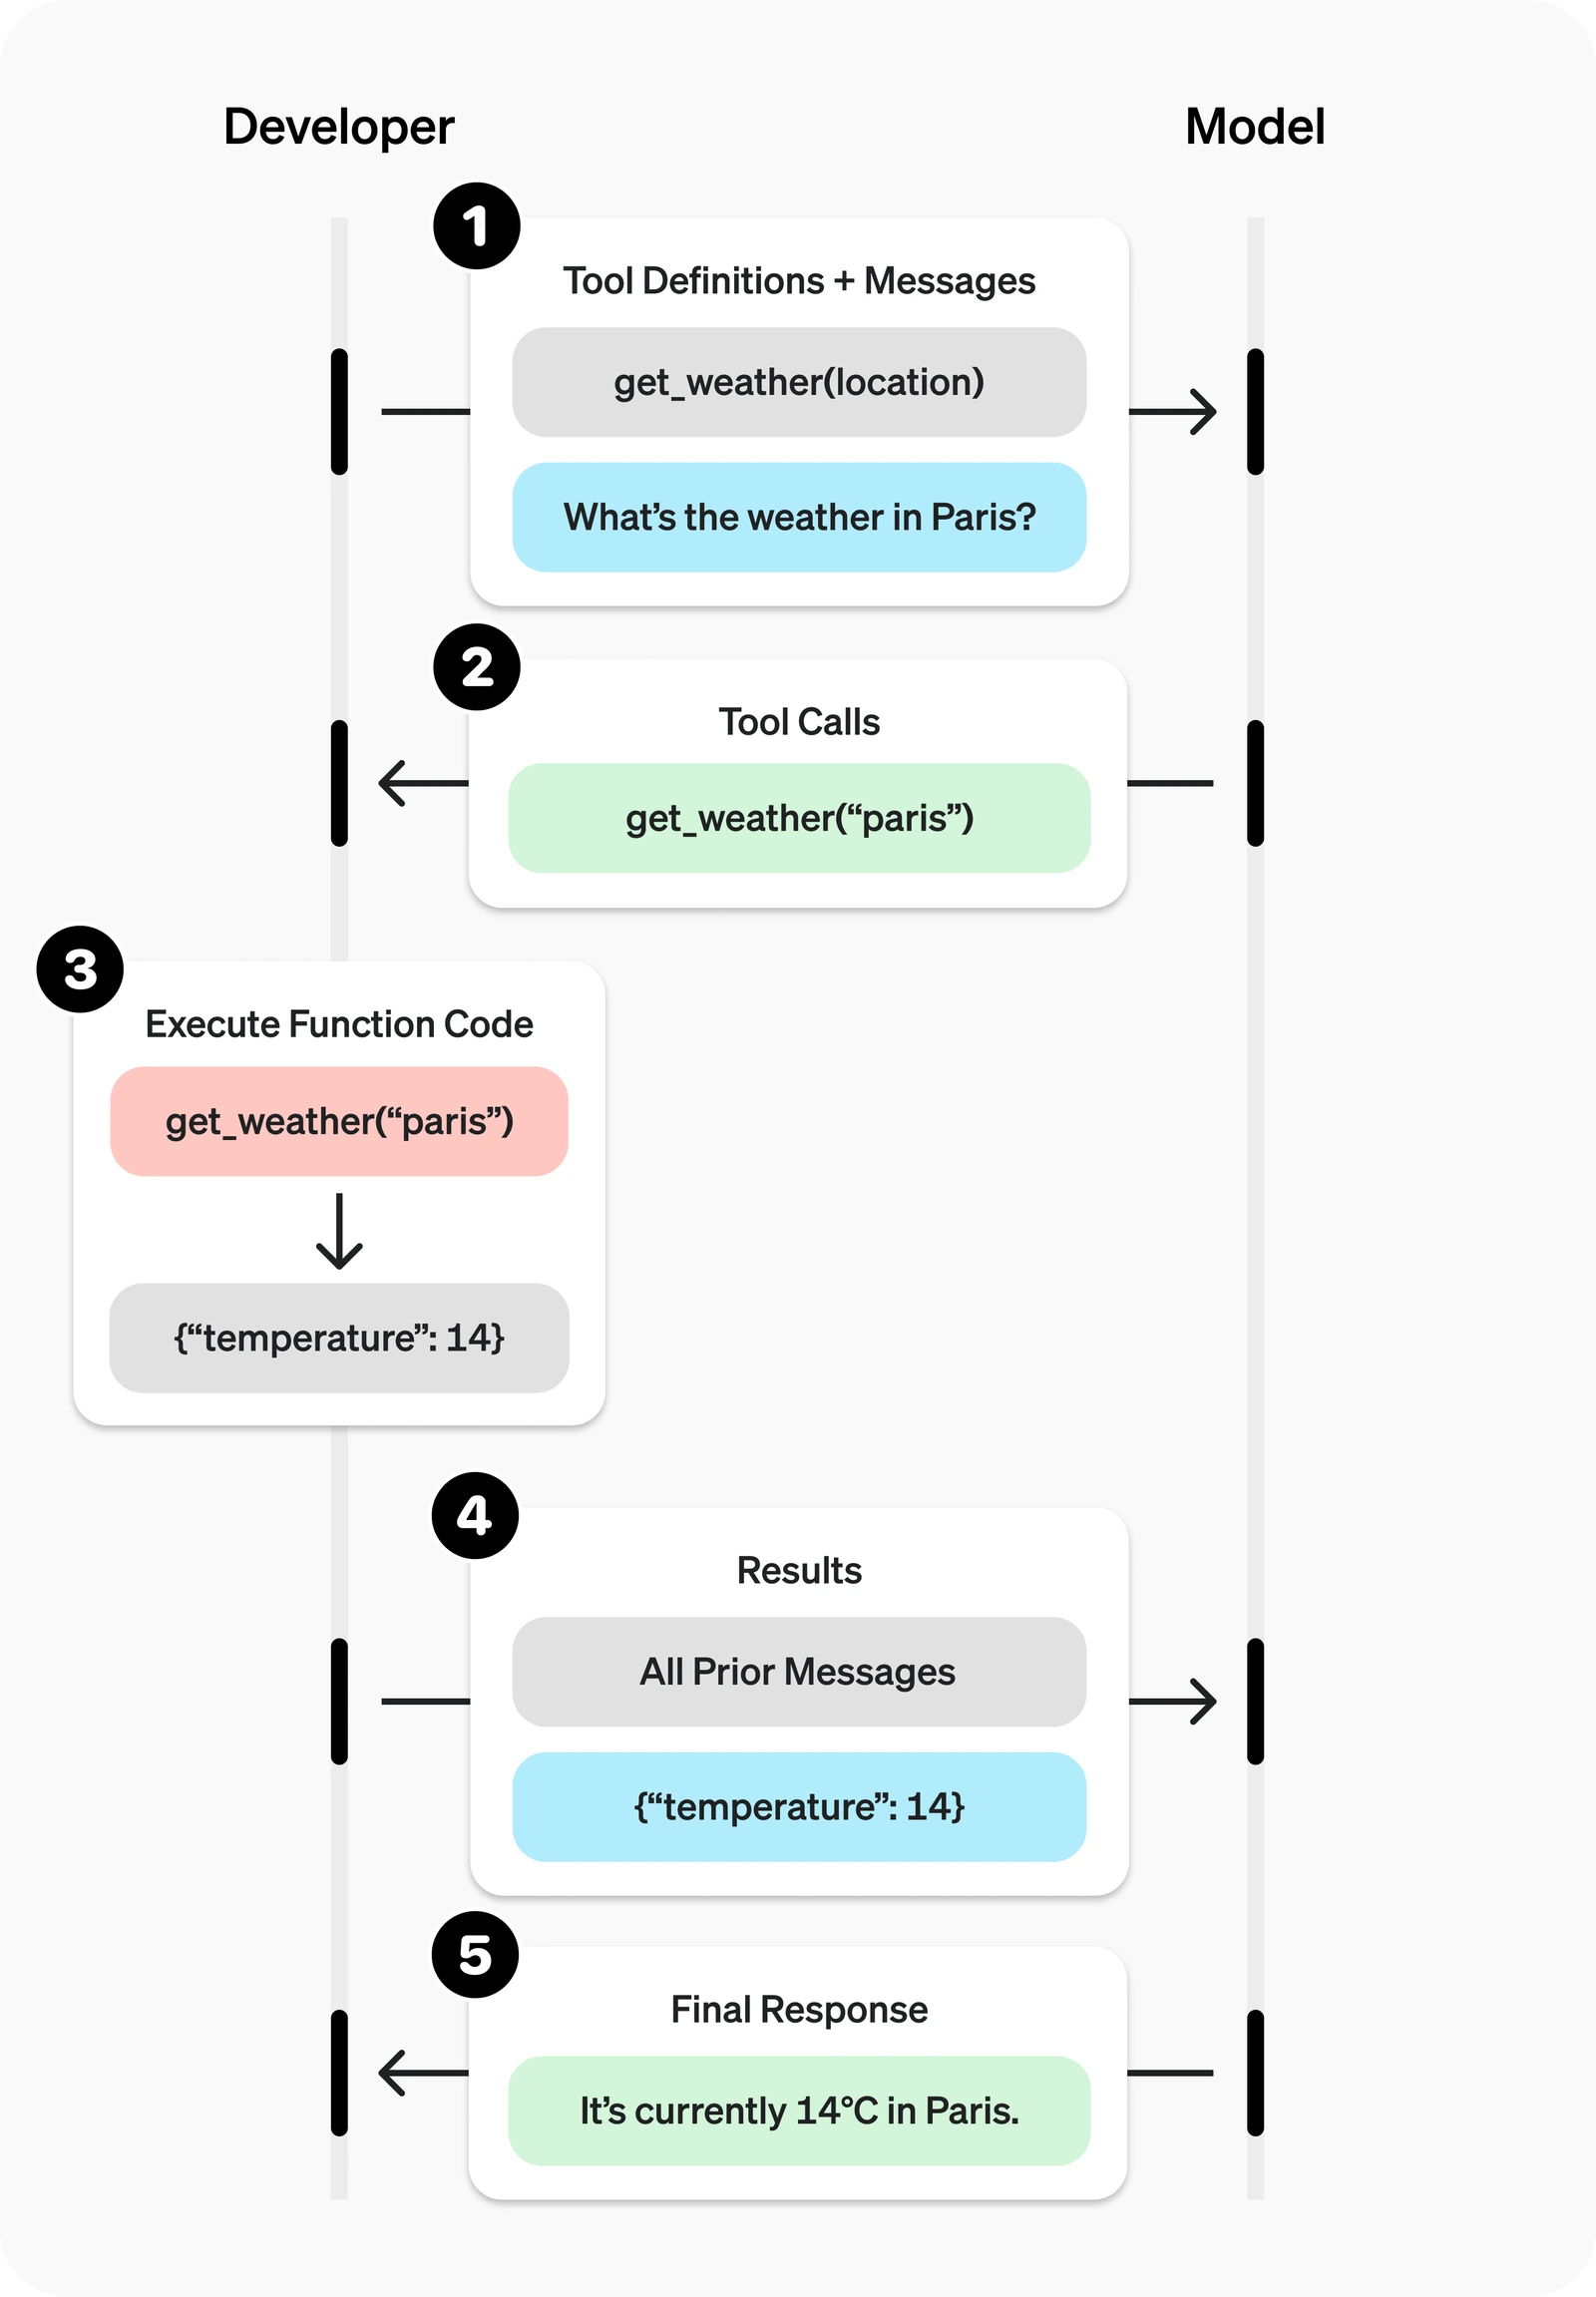
Løkken for funksjonskall som GPT-6.1 Sol bruker til verktøyarbeid. Diagram fra OpenAIs offisielle dokumentasjon.
For å A/B-teste begge i samme kodesti sender du claude-fable-5-2 og gpt-6.1-sol til /v1/chat/completions og endrer bare feltet model. For oppsett av SDK, effort og caching på Fable, se guiden vår til Claude Fable 5.2 API; for grensene og verktøyene til Sol, se guiden til funksjonene i GPT-6.1 Sol.
Modellsider: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Vanlige spørsmål
Er Fable 5 bedre enn GPT-5.6 Sol?
De passet til ulike oppgaver. I testene fra juli 2026 besto Fable 5 alle de 47 verktøyarbeidsflytene på tvers av apper hos Composio (GPT-5.6 Sol besto 45), mens GPT-5.6 Sol fikk høyest resultat på alle de tre planleggingsoppgavene for systemdesign hos Kilo, til en lavere tokenpris. I den nåværende generasjonen får Fable 5.2 65 og GPT-6.1 Sol 55 på Artificial Analysis Intelligence Index, der Sol koster en brøkdel per oppgave.
Blir GPT Astra bedre enn Fable?
GPT-6 Astra er allerede tilgjengelig, til $10 / $50 per million tokens. I Anthropics lanseringstabell for Fable 5.2 scorer Fable 5.2 høyere enn GPT-6 Astra på alle benchmarkene begge ble kjørt på, for eksempel 74.6 % mot 68.1 % på Terminal-Bench-Science 0.1 og 89.3 % mot 79.5 % på OSWorld 2.1. Dette er Anthropics egne kjøringer; test begge på dine egne oppgaver før du bestemmer deg.
Er GPT-5.6 Luna bedre?
Luna er det minste og rimeligste nivået i GPT-5.6, laget for raskt arbeid i store volum, mens Sol passer til mer krevende oppgaver. Velg Luna for gjennomstrømning og kostnad, Sol for dybde. I den nåværende generasjonen har GPT-6 Luna en listepris på $0.10 / $0.50 per million tokens.
Er GPT-5.6 Sol verdt det?
GPT-5.6 Sol er forrige generasjon. For nye prosjekter er GPT-6.1 Sol OpenAIs nåværende Sol-modell, til $2 / $10 per million tokens med kort kontekst, eller $1.60 / $8 hos PoYo i hele kontekstvinduet. GPT-5.6 Sol passer fortsatt godt til integrasjoner som allerede er tilpasset den.
Er Claude Fable 5.2 bedre enn GPT-6.1 Sol?
For maksimal kapasitet er Fable 5.2 valget: Den scorer 10 til 19 poeng høyere på hvert effort-nivå på Artificial Analysis Intelligence Index. For kostnad er GPT-6.1 Sol valget: Den koster en firedel så mye per token og, på maks effort, omtrent en tjuendedel så mye per indeksoppgave.
Hvilken er billigst, Fable 5.2 eller GPT-6.1 Sol?
GPT-6.1 Sol. De offisielle prisene er $2 / $10 per million input-/outputtokens mot $8 / $40 for Fable 5.2. Over 272K inputtokens øker OpenAI prisen på Sol til $4 / $15 for hele forespørselen, mens Fable blir værende på $8 / $40. Hos PoYo blir Sol værende på $1.60 / $8 uansett promptlengde.
Hvilken er best til koding?
De to leverandørene rapporterer koderesultater på ulike benchmarks. Anthropic oppgir at Fable 5.2 får 49.1 % på FrontierCode 2.0, foran GPT-6 Astra, og OpenAI har laget GPT-6.1 Sol for kompleks koding til en femtedel av Astras tokenpris. Et fornuftig standardoppsett er Sol til rutinemessig koding i store volum og Fable 5.2 til store, langvarige endringer. Kjør begge på et utvalg av dine egne saker.
Har begge modellene et kontekstvindu på 1M?
Ja, omtrent. Fable 5.2 har et vindu på 1M tokens. GPT-6.1 Sol har et vindu på 1 050 000 tokens med opptil 922 000 inputtokens. Begge skriver opptil 128K outputtokens per forespørsel.