
Belangrijkste punten
- Fable 5.2 past bij het zwaarste werk; GPT-6.1 Sol past bij werk in grote volumes. Op de Artificial Analysis Intelligence Index scoort Fable 5.2 65 en GPT-6.1 Sol 55 op max effort, en Sol voltooit elke indextaak voor een fractie van de kosten.
- Officiële tokenprijzen: $8 / $40 per miljoen input-/outputtokens voor Fable 5.2 en $2 / $10 voor Sol bij korte context, een verschil van 4×.
- Eén vast tarief op PoYo. OpenAI rekent voor Sol het hele verzoek af tegen $4 / $15 zodra de input boven 272K tokens komt. Op PoYo kost GPT-6.1 Sol $1.60 / $8 over het volledige contextvenster, en Fable 5.2 kost $6.40 / $32 over het volledige venster van 1M.
- Fable 5.2 steekt meer redeneerwerk in elke taak. Artificial Analysis mat $26.54 per indextaak voor Fable 5.2 op max effort en $1.27 voor Sol.
- Fable 5.2 haalt snel sterke scores. Op
loweffort scoort het 54, dicht bij de 55 van Sol opmax, en het rondt een indextaak af in 5,8 minuten tegenover 23,3. - Zoek je op “GPT-5.6 Sol vs Fable 5”? Dat was de krachtmeting van juli 2026. Beide lijnen zijn inmiddels verder; het oude duo komt hieronder in een aparte sectie aan bod.
Claude Fable 5.2 vs GPT-6.1 Sol in één oogopslag
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Ontwikkelaar | Anthropic | OpenAI |
| Model-ID in de API | claude-fable-5-2 | gpt-6.1-sol |
| Uitgebracht | 9 november 2026 | 29 september 2026 |
| Positie | Topniveau van Anthropic, boven Opus | Sol-niveau van OpenAI, tussen GPT-6 Astra en GPT-6 Luna |
| Contextvenster | 1M tokens | 1.050.000 tokens (maximale input 922.000) |
| Maximale output | 128K tokens | 128K tokens |
| Input → output | Tekst en afbeeldingen → tekst | Tekst en afbeeldingen → tekst |
| Instelling voor redeneren | output_config.effort | reasoning.effort |
| Effort-niveaus | low tot max, standaard high | low tot max, standaard medium |
| Kennisgrens | juni 2026 | 30 april 2026 |
| Officiële input / output (per 1M) | $8 / $40 | $2 / $10 (input ≤272K) $4 / $15 (input >272K) |
| Officieel cache lezen (per 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| Input / output op PoYo (per 1M) | $6.40 / $32 | $1.60 / $8 |
| Endpoints op PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs Fable 5: welke versies vergelijk je?
De meeste pagina's die scoren op “GPT-5.6 Sol vs Fable 5” zijn in juli 2026 geschreven, toen dat de twee nieuwste modellen waren. Sindsdien hebben beide lijnen nieuwere versies uitgebracht:
| Model | Ontwikkelaar | Uitgebracht | Officiële input / output bij lancering (per 1M, korte context) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9 juni 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9 juli 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1 september 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22 september 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29 september 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9 november 2026 | $8 / $40 |
GPT-5.6 Sol vs Claude Fable 5: de krachtmeting van juli 2026
Bij de lancering kostte GPT-5.6 Sol voor input de helft van Fable 5 en voor output 40% minder ($5 / $30 vs $10 / $50, met gecachete input voor $0.50 vs $1). Onafhankelijke tests uit die maand kwamen tot een verdeeld oordeel:
| Test | Opzet | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: drie plannen voor systeemontwerp | Kilo Code CLI, beide op Max reasoning, beoordeeld met een vooraf opgestelde rubric | Topscore op alle drie de taken, nadat het elk plan zelf had nagelopen en herzien; gemiddeld 52 min 53 s per plan; $13.57 totaal | Plannen waarmee de testers het makkelijkst verder konden bouwen; gemiddeld 15 min 27 s per plan; $12.02 totaal |
| Composio: Golden Eval, 47 toolworkflows over meerdere apps | Fable 5 in Claude Code; Sol in Codex CLI op high | 45 van 47 geslaagd (95.7%); gemiddeld 223.779 tokens en 79.6 s per taak | 47 van 47 geslaagd (100%); gemiddeld 276.957 tokens en 84.4 s per taak |
| Analytics Vidhya: webapp, data-analyse, investeerderspresentatie | Dezelfde prompts, nieuwe chats, standaardinstelling voor reasoning | Vergelijkbare kwaliteit, met ongeveer twee keer zo lange looptijd | Vergelijkbare kwaliteit en snellere runs; de keuze van de auteur voor lang, complex werk dat in één keer wordt overgedragen |
Het patroon in juli: GPT-5.6 Sol paste bij plannen en coderen tegen een lagere tokenprijs en nam extra tijd om zijn eigen werk te controleren; Fable 5 paste bij lange toolworkflows en schreef plannen waarmee je makkelijk verder kon bouwen.
Die resultaten gaan over de modellen van juli, inmiddels de vorige generatie. Sindsdien is het prijsverschil in het voordeel van Sol gegroeid: Fable 5.2 kost per token 4× zoveel als GPT-6.1 Sol, terwijl Fable 5 voor input 2× en voor output ongeveer 1,7× zoveel kostte als GPT-5.6 Sol. De rest van dit artikel vergelijkt het huidige duo. Op PoYo is GPT-5.6 Sol beschikbaar via de Responses API voor integraties die er al op zijn afgestemd.
Wat de twee modellen gemeen hebben, en waarin ze verschillen
Gemeenschappelijk:
- Ongeveer 1M tokens context en 128K outputtokens per verzoek.
- Tekst en afbeeldingen als input, tekst als output.
- Vijf effort-niveaus, van
lowtot en metmax. Elke leverancier kalibreert zijn eigen niveaus, dus vergelijk resultaten en geen labels. - Prompt caching, streaming en structured outputs.
Verschillend:
- Standaard-effort. Fable 5.2 staat standaard op
high; Sol opmedium. Stel effort in vergelijkende tests expliciet in, zodat beide op het niveau draaien dat je bedoelt. - Instellingen voor denkwerk. Fable 5.2 denkt altijd adaptief na en accepteert
tool_choicemetautoofnone. Sol stel je in viareasoning.effort, en de gehoste tools (web search, file search, code interpreter, hosted shell, apply patch, computergebruik, MCP, tool search) draaien via de Responses API van OpenAI. - Kennisgrens. Juni 2026 voor Fable 5.2; 30 april 2026 voor Sol.
- Gegevensbewaring. Fable 5.2 werkt op de API van Anthropic met 30 dagen gegevensbewaring.
Prijzen: 4× per token, 2× bij lange prompts
Officiële tarieven (USD per 1M tokens)
| Kostenpost | Claude Fable 5.2 | GPT-6.1 Sol, input ≤272K | GPT-6.1 Sol, input >272K |
|---|---|---|---|
| Input | $8.00 | $2.00 | $4.00 |
| Output | $40.00 | $10.00 | $15.00 |
| Cache lezen | $0.20 | $0.10 | $0.20 |
| Cache schrijven | $10 (5 min) / $16 (1 uur) | $2.50 (30 min) / $5.00 (12 uur) | $5.00 (30 min) / $10.00 (12 uur) |
OpenAI rekent voor prompts met meer dan 272K inputtokens 2× de input- en cachetarieven en 1,5× het outputtarief, voor het hele verzoek. Anthropic factureert het volledige venster van 1M van Fable 5.2 tegen de standaardtarieven. Op PoYo hanteren beide modellen één tarief over hun hele contextvenster, dus GPT-6.1 Sol blijft op $1.60 / $8, hoe lang de prompt ook is. Zie onze prijsgids voor de Claude API voor de prijzen van elk Claude-model.
Kosten per verzoek
Deze voorbeelden gaan ervan uit dat beide modellen evenveel tokens gebruiken; in de praktijk verschilt het verbruik per model (zie de volgende sectie). Kosten voor cache schrijven zijn bij beide buiten beschouwing gelaten.
| Scenario | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Chatantwoord: 20K input + 4K output | Officieel: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Officieel: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Codeertaak: 100K input + 10K output | Officieel: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Officieel: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Lang document: 500K input + 20K output | Officieel: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Officieel: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Agentsessie: 2M uit de cache gelezen + 300K nieuwe input + 150K output, elk verzoek onder 272K | Officieel: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Officieel: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
Bij een prompt van 500K tokens verkleint het officiële tarief voor lange context van Sol het verschil van 4× tot ongeveer 2,1×. Op PoYo kost hetzelfde verzoek op GPT-6.1 Sol $0.96, omdat PoYo Sol tegen één tarief factureert, zonder multiplier voor lange context.
Kosten per voltooide taak
Tokenprijzen zijn maar de helft van de rekening. Artificial Analysis laat beide modellen dezelfde taken van de Intelligence Index uitvoeren en publiceert de kosten:
| Max effort | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Kosten per indextaak | $26.54 | $1.27 |
| Tijd per indextaak | 45.3 min | 23.3 min |
| Indexscore | 65 | 55 |
Het kostenverschil is ongeveer 21×, tegenover een prijsverschil van 4×: Fable 5.2 steekt veel meer redeneerwerk in elke taak, en daar komen de hogere scores vandaan, terwijl Sol taken met veel minder tokens afrondt. Vergelijk bij echte werklasten de totale rekening per geaccepteerde taak naast het tokentarief.
Benchmarks
Dezelfde opzet: Artificial Analysis Intelligence Index
Artificial Analysis test beide modellen met dezelfde taken en dezelfde harness, dus de cijfers zijn direct vergelijkbaar. Intelligence Index v5.0.1, afgelezen op 14 november 2026:
| Effort | Score Fable 5.2 | Score GPT-6.1 Sol | Tijd per taak Fable 5.2 | Tijd per taak Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 min | 2.0 min |
medium | 56 | 46 | 7.7 min | 4.6 min |
high | 62 | 50 | 16.2 min | 7.9 min |
xhigh | 62 | 52 | 27.9 min | 10.7 min |
max | 65 | 55 | 45.3 min | 23.3 min |
Zo lees je de tabel:
- Fable 5.2 scoort op elk niveau hoger, met 10 tot 19 punten, wat goed past bij werk waarin de kwaliteit van het antwoord het zwaarst weegt.
- Fable 5.2 op
lowscoort dicht bij Sol opmax(54 vs 55), in een kwart van de tijd. - Sol levert zijn scores tegen lage kosten: $1.27 per indextaak op max effort, wat goed past bij werk in grote volumes en budgetgevoelig werk.
- Fable genereert sneller tokens: ongeveer 94–102 outputtokens per seconde tegenover 47–49 voor Sol.
- Artificial Analysis labelt zijn runs van Fable 5.2 als “Default Fallback”, wat betekent dat de refusal-fallback van Anthropic tijdens de tests aan stond.
Lanceringsresultaten van Anthropic
De tabel van Anthropic voor Fable 5.2 vergelijkt het model met GPT-6 Astra, het topniveau van OpenAI. Elk model draaide op de hoogste beschikbare effort, tenzij anders vermeld:
| Benchmark | Wat het meet | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Agentisch coderen | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Software engineering | 69.9% | 65.5% |
| AutomationBench | Bedrijfsworkflows | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Agentische wetenschap | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Computergebruik | 89.3% | 79.5% |
| Remote Labor Index | Echte betaalde taken | 41.3% (high) | 20.8% |
| Humanity's Last Exam (met tools) | Moeilijk redeneren | 74.2% | 57.2% |
| Chartography (zonder tools) | Redeneren over grafieken | 73.4% | 71.0% |

Score op FrontierCode 2.0 tegenover de kosten per taak op elk effort-niveau. Grafiek uit het lanceringsmateriaal van Anthropic voor Claude Fable 5.2.
Lanceringsresultaten van OpenAI
OpenAI bracht GPT-6.1 Sol uit op 29 september 2026, zes weken voor Fable 5.2, en vergeleek het met zijn eigen GPT-6-modellen. OpenAI positioneert het voor complex codeerwerk, computergebruik en professioneel werk, met capaciteiten die dicht bij GPT-6 Astra komen voor een vijfde van de tokenprijs van Astra ($2 / $10 tegenover $10 / $50). De evaluaties bij de lancering beslaan software engineering, documentbegrip, bedrijfsautomatisering en computergebruik.
Elke leverancier draait benchmarks in een eigen harness en testversie. Vergelijk scores dus binnen de tabel van één leverancier, en gebruik de index van Artificial Analysis hierboven voor een directe vergelijking.
Welke moet je kiezen?
| Je werklast | Begin met | Waarom |
|---|---|---|
| Chat, extractie en routering in grote volumes | GPT-6.1 Sol op medium (of een kleiner model) | Handelt korte taken af voor een kwart van de tokenprijs van Fable |
| Dagelijks coderen en agent-loops met een beperkt budget | GPT-6.1 Sol | Gebouwd voor code- en agentwerk, voor $2 / $10 officieel en $1.60 / $8 op PoYo |
| Het zwaarste redeneerwerk, onderzoek, lange autonome runs | Fable 5.2 | 65 vs 55 op de Intelligence Index; voor op GPT-6 Astra in de hele tabel van Anthropic |
| Moeilijke problemen waarbij wachten duur is | Fable 5.2 op low of medium | Scoort dicht bij het maximum van Sol in een kwart van de tijd |
| Computergebruik, grafieken, visueel complexe documenten | Fable 5.2 | 89.3% op OSWorld 2.1 en 73.4% op Chartography in de tabel van Anthropic |
| Prompts die geregeld boven 272K tokens komen | GPT-6.1 Sol op PoYo voor de kosten, Fable 5.2 voor de diepgang | Op PoYo houden beide één tarief aan over het hele venster: $1.60 / $8 voor Sol, $6.40 / $32 voor Fable |
| Gebouwd op de gehoste tools van OpenAI (shell, web search, MCP) | GPT-6.1 Sol | Die tools draaien native via de Responses API |
| Claude-kwaliteit voor een lagere prijs | Claude Opus 5.5 | $4 / $20; zie Claude Fable 5.2 vs Opus 5.5 |
Lange autonome runs passen goed bij Fable 5.2: de agents ervan bouwden dit prototype van een besturingssysteem, hier draaiend op een laptop. Video uit het lanceringsmateriaal van Anthropic voor Claude Fable 5.2.
Een praktische routeringsopzet: stuur routineverkeer naar GPT-6.1 Sol op medium, houd bij welke taaktypen baat hebben bij dieper redeneerwerk, en routeer die naar Fable 5.2 op medium. Vergelijk na een week de kosten per geaccepteerde taak in plaats van tokenprijzen. Zie GPT-6.1 Sol vs Claude Opus 5.5 voor de Claude-optie in het middensegment tegenover Sol.
Gebruik beide op PoYo
Met PoYo draai je eenvoudig beide modellen:
- Eén API-sleutel voor Fable 5.2, GPT-6.1 Sol en elk ander model voor chat, beeld, video en audio.
- Betalen naar gebruik, per token gefactureerd in credits, zonder abonnement.
- Beide API-formaten: Anthropic Messages en OpenAI Chat Completions en Responses.
- Eén tarief per model over het hele contextvenster, 20% onder het officiële tarief voor korte context:
| Kostenpost (per 1M tokens) | Claude Fable 5.2 op PoYo | GPT-6.1 Sol op PoYo |
|---|---|---|
| Input | $6.40 | $1.60 |
| Output | $32.00 | $8.00 |
| Cache lezen | $0.16 | $0.08 |
| Cache schrijven | $8.00 (5 min) / $12.80 (1 uur) | $2.00 |
Fable 5.2 via het Anthropic Messages-formaat:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Controleer deze diff op concurrency-bugs: ..."}]
  }'
GPT-6.1 Sol via de Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Review this diff for concurrency bugs: ..."
  }'
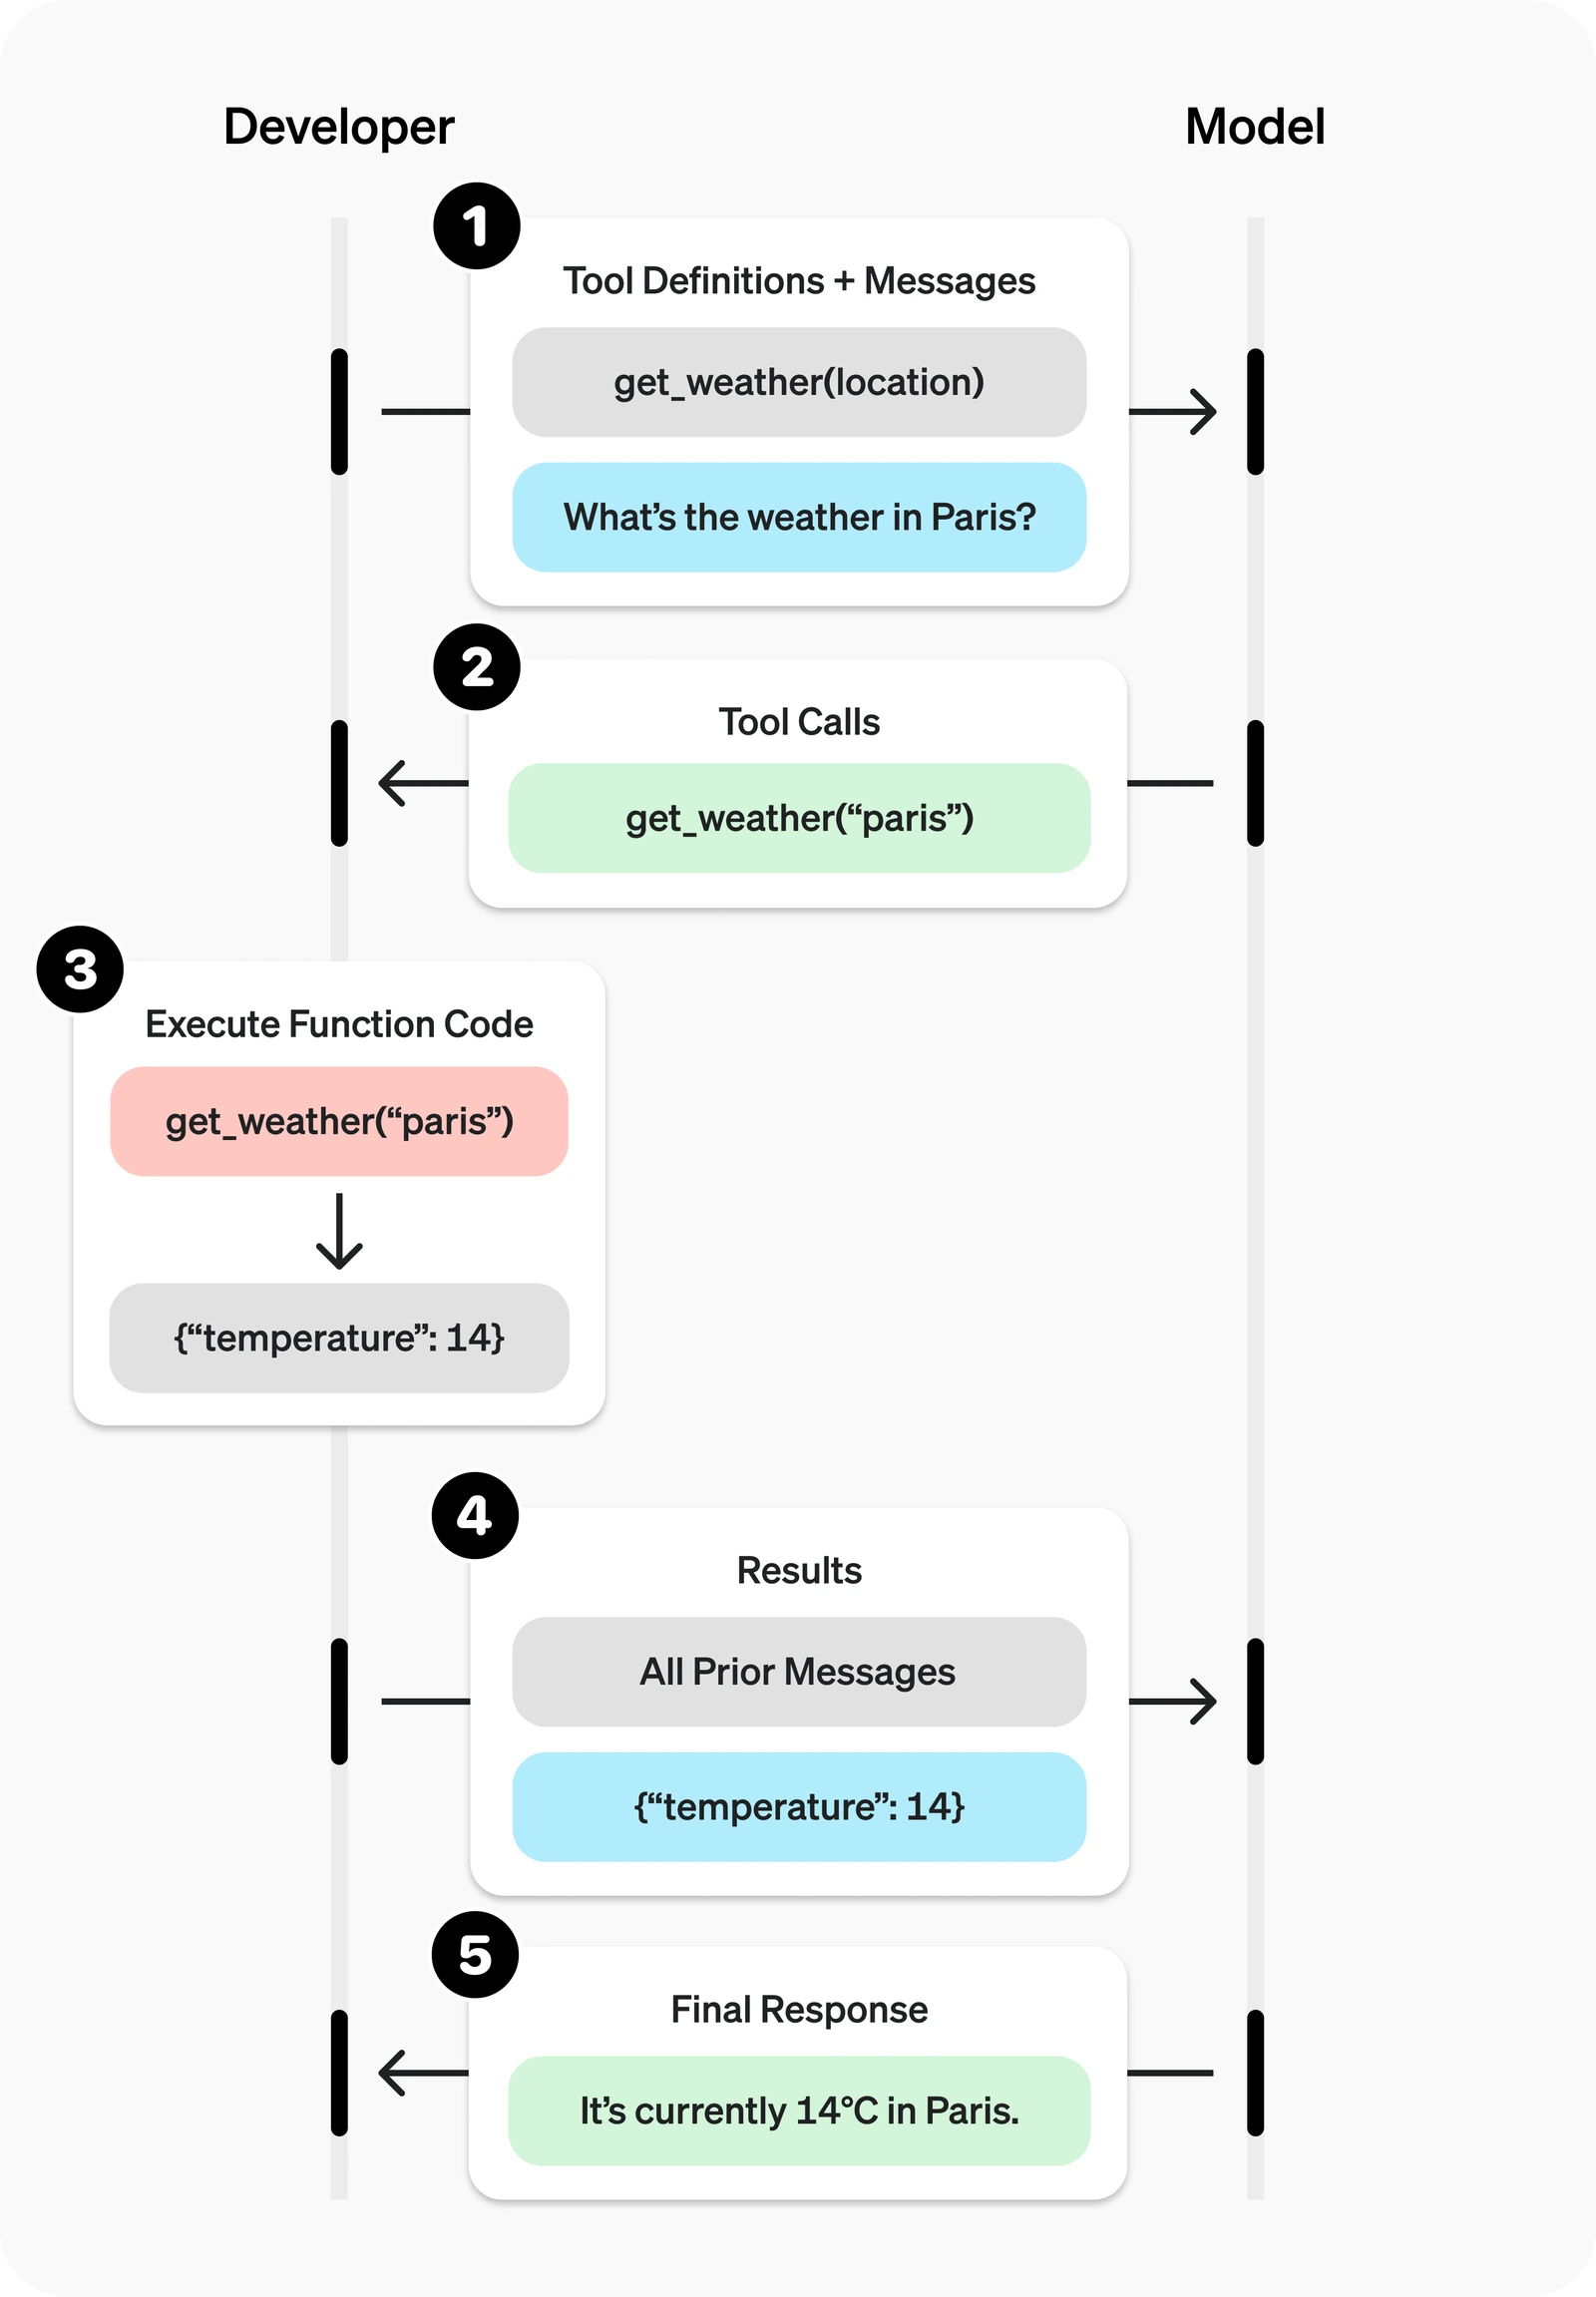
De function-calling-loop die GPT-6.1 Sol gebruikt voor werk met tools. Diagram uit de officiële documentatie van OpenAI.
Wil je beide in één codepad A/B-testen, stuur dan claude-fable-5-2 en gpt-6.1-sol naar /v1/chat/completions en verander alleen het veld model. Voor de SDK-setup, effort en caching van Fable, zie onze gids voor de Claude Fable 5.2 API; voor de limieten en tools van Sol, zie de gids met functies van GPT-6.1 Sol.
Modelpagina's: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Veelgestelde vragen
Is Fable 5 beter dan GPT-5.6 Sol?
Elk paste bij ander werk. In de tests van juli 2026 haalde Fable 5 alle 47 toolworkflows over meerdere apps van Composio (GPT-5.6 Sol haalde er 45), terwijl GPT-5.6 Sol op alle drie de planningstaken voor systeemontwerp van Kilo het hoogst scoorde, tegen een lagere tokenprijs. In de huidige generatie scoort Fable 5.2 65 en GPT-6.1 Sol 55 op de Artificial Analysis Intelligence Index, waarbij Sol per taak een fractie kost.
Wordt GPT Astra beter dan Fable?
GPT-6 Astra is al beschikbaar, voor $10 / $50 per miljoen tokens. In de lanceringstabel van Anthropic voor Fable 5.2 scoort Fable 5.2 hoger dan GPT-6 Astra op elke benchmark waarop beide zijn getest, bijvoorbeeld 74,6% vs 68,1% op Terminal-Bench-Science 0.1 en 89,3% vs 79,5% op OSWorld 2.1. Dit zijn runs van Anthropic zelf; test beide op je eigen taken voordat je kiest.
Is GPT-5.6 Luna beter?
Luna is het kleinste en voordeligste niveau van GPT-5.6, gebouwd voor snel werk in grote volumes, terwijl Sol past bij zwaardere taken. Kies Luna voor doorvoer en kosten, Sol voor diepgang. In de huidige generatie heeft GPT-6 Luna een catalogusprijs van $0.10 / $0.50 per miljoen tokens.
Is GPT-5.6 Sol de moeite waard?
GPT-5.6 Sol is de vorige generatie. Voor nieuwe projecten is GPT-6.1 Sol het actuele Sol-model van OpenAI, voor $2 / $10 per miljoen tokens bij korte context, of $1.60 / $8 op PoYo over het hele contextvenster. GPT-5.6 Sol blijft een goede keuze voor integraties die er al op zijn afgestemd.
Is Claude Fable 5.2 beter dan GPT-6.1 Sol?
Voor maximale capaciteit kies je Fable 5.2: het scoort op de Artificial Analysis Intelligence Index op elk effort-niveau 10 tot 19 punten hoger. Voor de kosten kies je GPT-6.1 Sol: het kost per token een kwart en op max effort ongeveer een twintigste per indextaak.
Welke is goedkoper, Fable 5.2 of GPT-6.1 Sol?
GPT-6.1 Sol. De officiële prijzen zijn $2 / $10 per miljoen input-/outputtokens tegenover $8 / $40 voor Fable 5.2. Boven 272K inputtokens verhoogt OpenAI Sol naar $4 / $15 voor het hele verzoek, terwijl Fable op $8 / $40 blijft. Op PoYo blijft Sol op $1.60 / $8, bij elke promptlengte.
Welke is beter voor coderen?
De twee leveranciers rapporteren codeerresultaten op verschillende benchmarks. Anthropic meldt voor Fable 5.2 49,1% op FrontierCode 2.0, voor GPT-6 Astra, en OpenAI bouwde GPT-6.1 Sol voor complex codeerwerk tegen een vijfde van de tokenprijs van Astra. Een verstandige standaard is Sol voor routinematig coderen in grote volumes en Fable 5.2 voor grote, langlopende wijzigingen. Test beide op een steekproef van je eigen tickets.
Hebben beide modellen een contextvenster van 1M?
Ja, ongeveer. Fable 5.2 heeft een venster van 1M tokens. GPT-6.1 Sol heeft een venster van 1.050.000 tokens met tot 922.000 inputtokens. Beide schrijven tot 128K outputtokens per verzoek.