
Najważniejsze wnioski
- Fable 5.2 pasuje do najtrudniejszej pracy, a GPT-6.1 Sol do pracy na dużą skalę. W Artificial Analysis Intelligence Index Fable 5.2 uzyskuje 65 punktów, a GPT-6.1 Sol 55 przy maksymalnym effort, przy czym Sol wykonuje każde zadanie z indeksu za ułamek kosztu.
- Oficjalne ceny tokenów: $8 / $40 za milion tokenów wejściowych/wyjściowych w Fable 5.2 i $2 / $10 w Sol przy krótkim kontekście, czyli różnica 4×.
- Jedna stała stawka w PoYo. OpenAI podnosi cenę całego żądania Sol do $4 / $15 powyżej 272K tokenów wejściowych. W PoYo GPT-6.1 Sol kosztuje $1.60 / $8 w całym oknie kontekstu, a Fable 5.2 — $6.40 / $32 w całym oknie 1M.
- Fable 5.2 wkłada w każde zadanie więcej rozumowania. Artificial Analysis zmierzyło $26.54 za zadanie z indeksu dla Fable 5.2 przy maksymalnym effort i $1.27 dla Sol.
- Fable 5.2 szybko osiąga mocne wyniki. Na effort
lowuzyskuje 54 punkty, blisko 55 punktów Sol namax, a zadanie z indeksu kończy w 5,8 minuty wobec 23,3. - Szukasz „GPT-5.6 Sol vs Fable 5”? To było starcie z lipca 2026. Obie linie poszły od tego czasu naprzód; poprzedniej parze poświęcamy osobną sekcję poniżej.
Claude Fable 5.2 vs GPT-6.1 Sol w skrócie
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Twórca | Anthropic | OpenAI |
| ID modelu w API | claude-fable-5-2 | gpt-6.1-sol |
| Premiera | 9 listopada 2026 | 29 września 2026 |
| Pozycja | Najwyższy segment Anthropic, ponad Opus | Segment Sol w OpenAI, między GPT-6 Astra a GPT-6 Luna |
| Okno kontekstu | 1M tokenów | 1 050 000 tokenów (maks. 922 000 na wejściu) |
| Maksymalne wyjście | 128K tokenów | 128K tokenów |
| Wejście → wyjście | Tekst i obrazy → tekst | Tekst i obrazy → tekst |
| Sterowanie rozumowaniem | output_config.effort | reasoning.effort |
| Poziomy effort | Od low do max, domyślnie high | Od low do max, domyślnie medium |
| Granica wiedzy | Czerwiec 2026 | 30 kwietnia 2026 |
| Oficjalne wejście / wyjście (za 1M) | $8 / $40 | $2 / $10 (wejście ≤272K) $4 / $15 (wejście >272K) |
| Oficjalny odczyt z cache (za 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| PoYo: wejście / wyjście (za 1M) | $6.40 / $32 | $1.60 / $8 |
| Endpointy PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs Fable 5: które wersje właściwie porównujesz?
Większość stron, które wyświetlają się na hasło „GPT-5.6 Sol vs Fable 5”, powstała w lipcu 2026, gdy były to dwa najnowsze modele. Od tego czasu każda linia doczekała się nowszych wersji:
| Model | Twórca | Premiera | Oficjalne wejście / wyjście w dniu premiery (za 1M, krótki kontekst) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9 czerwca 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9 lipca 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1 września 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22 września 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29 września 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9 listopada 2026 | $8 / $40 |
GPT-5.6 Sol vs Claude Fable 5: starcie z lipca 2026
W dniu premiery GPT-5.6 Sol kosztował o połowę mniej niż Fable 5 za wejście i o 40% mniej za wyjście ($5 / $30 wobec $10 / $50, a wejście z cache $0.50 wobec $1). Niezależne testy z tamtego miesiąca dały podzielony werdykt:
| Test | Konfiguracja | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo: trzy plany projektowania systemów | Kilo Code CLI, oba modele na Max reasoning, ocena według rubryki przygotowanej z wyprzedzeniem | Najwyższa ocena we wszystkich trzech zadaniach po samodzielnym przejrzeniu i poprawieniu każdego planu; średnio 52 min 53 s na plan; łącznie $13.57 | Plany, na podstawie których testerom najłatwiej było budować; średnio 15 min 27 s na plan; łącznie $12.02 |
| Composio: Golden Eval, 47 procesów z narzędziami w wielu aplikacjach | Fable 5 w Claude Code; Sol w Codex CLI na high | Zaliczone 45 z 47 (95.7%); średnio 223 779 tokenów i 79.6 s na zadanie | Zaliczone 47 z 47 (100%); średnio 276 957 tokenów i 84.4 s na zadanie |
| Analytics Vidhya: aplikacja webowa, analiza danych, prezentacja dla inwestorów | Te same prompty, nowe czaty, domyślne rozumowanie | Porównywalna jakość przy mniej więcej dwukrotnie dłuższym czasie działania | Porównywalna jakość i szybsze przebiegi; wybór autora do długiej, złożonej pracy zlecanej za jednym razem |
Prawidłowość z lipca: GPT-5.6 Sol sprawdzał się w planowaniu i programowaniu przy niższej cenie tokenów i poświęcał dodatkowy czas na sprawdzanie własnej pracy; Fable 5 sprawdzał się w długich procesach z narzędziami i pisał plany, na podstawie których łatwo było budować.
Te wyniki dotyczą modeli z lipca, które są już poprzednią generacją. Od tego czasu różnica w cenie wzrosła na korzyść Sol: Fable 5.2 kosztuje za token 4× więcej niż GPT-6.1 Sol, podczas gdy Fable 5 kosztował 2× więcej niż GPT-5.6 Sol za wejście i około 1,7× więcej za wyjście. W dalszej części artykułu porównujemy aktualną parę. W PoYo GPT-5.6 Sol jest dostępny przez Responses API dla integracji, które są już do niego dostrojone.
Co łączy oba modele, a czym się różnią
Wspólne cechy:
- Około 1M tokenów kontekstu i 128K tokenów wyjściowych na żądanie.
- Wejście tekstowe i obrazowe, wyjście tekstowe.
- Pięć poziomów effort, od
lowdomax. Każdy dostawca kalibruje swoje poziomy po swojemu, więc porównuj wyniki, a nie nazwy poziomów. - Prompt caching, strumieniowanie i structured outputs.
Różnice:
- Domyślny effort. Fable 5.2 domyślnie działa na
high, a Sol namedium. W porównaniach jeden do jednego ustawiaj effort jawnie, aby oba modele działały na zamierzonym poziomie. - Sterowanie myśleniem. Fable 5.2 zawsze myśli adaptacyjnie i przyjmuje
tool_choiceo wartościautolubnone. Sol konfiguruje się przezreasoning.effort, a jego narzędzia hostowane (wyszukiwanie w sieci, wyszukiwanie w plikach, interpreter kodu, hostowana powłoka, apply patch, obsługa komputera, MCP, wyszukiwanie narzędzi) działają przez Responses API OpenAI. - Granica wiedzy. Czerwiec 2026 w Fable 5.2; 30 kwietnia 2026 w Sol.
- Retencja danych. Fable 5.2 działa w API Anthropic z 30-dniową retencją danych.
Ceny: 4× za token, 2× przy długich promptach
Oficjalne stawki (USD za 1M tokenów)
| Opłata | Claude Fable 5.2 | GPT-6.1 Sol, wejście ≤272K | GPT-6.1 Sol, wejście >272K |
|---|---|---|---|
| Wejście | $8.00 | $2.00 | $4.00 |
| Wyjście | $40.00 | $10.00 | $15.00 |
| Odczyt z cache | $0.20 | $0.10 | $0.20 |
| Zapis do cache | $10 (5 min) / $16 (1 godz.) | $2.50 (30 min) / $5.00 (12 godz.) | $5.00 (30 min) / $10.00 (12 godz.) |
OpenAI rozlicza prompty z ponad 272K tokenów wejściowych według stawek 2× za wejście i cache oraz 1,5× za wyjście, i to za całe żądanie. Anthropic rozlicza całe okno 1M w Fable 5.2 według standardowych stawek. W PoYo oba modele mają jedną stawkę w całym oknie kontekstu, więc GPT-6.1 Sol kosztuje $1.60 / $8 niezależnie od długości promptu. Ceny wszystkich modeli Claude znajdziesz w naszym przewodniku po cenach Claude API.
Koszt żądania
Przykłady zakładają, że oba modele zużywają tyle samo tokenów; w praktyce zużycie zależy od modelu (zob. następną sekcję). Opłaty za zapis do cache pominięto w obu przypadkach.
| Scenariusz | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Odpowiedź w czacie: 20K wejścia + 4K wyjścia | Oficjalnie: 0.02×8 + 0.004×40 = $0.32PoYo: $0.256 | Oficjalnie: 0.02×2 + 0.004×10 = $0.08PoYo: $0.064 |
| Zadanie programistyczne: 100K wejścia + 10K wyjścia | Oficjalnie: 0.1×8 + 0.01×40 = $1.20PoYo: $0.96 | Oficjalnie: 0.1×2 + 0.01×10 = $0.30PoYo: $0.24 |
| Długi dokument: 500K wejścia + 20K wyjścia | Oficjalnie: 0.5×8 + 0.02×40 = $4.80PoYo: $3.84 | Oficjalnie: 0.5×4 + 0.02×15 = $2.30PoYo: $0.96 |
| Sesja agenta: 2M odczytów z cache + 300K nowego wejścia + 150K wyjścia, każde żądanie poniżej 272K | Oficjalnie: 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo: $7.04 | Oficjalnie: 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo: $1.84 |
Przy prompcie na 500K tokenów oficjalna stawka Sol za długi kontekst zmniejsza różnicę z 4× do około 2,1×. W PoYo to samo żądanie kosztuje w GPT-6.1 Sol $0.96, ponieważ PoYo rozlicza Sol według jednej stawki, bez mnożnika za długi kontekst.
Koszt ukończonego zadania
Cena tokenów to tylko połowa rachunku. Artificial Analysis przepuszcza oba modele przez te same zadania z Intelligence Index i publikuje koszty:
| Maksymalny effort | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Koszt zadania z indeksu | $26.54 | $1.27 |
| Czas zadania z indeksu | 45.3 min | 23.3 min |
| Wynik w indeksie | 65 | 55 |
Różnica w koszcie wynosi około 21× przy 4× różnicy w cenie: Fable 5.2 wkłada w każde zadanie znacznie więcej rozumowania i właśnie stąd biorą się jego wyższe wyniki, a Sol kończy zadania przy znacznie mniejszej liczbie tokenów. Przy prawdziwych obciążeniach porównuj łączny rachunek za zaakceptowane zadanie obok stawki za token.
Benchmarki
Te same warunki: Artificial Analysis Intelligence Index
Artificial Analysis ocenia oba modele na tych samych zadaniach i w tym samym środowisku testowym, więc jego wyniki można porównywać bezpośrednio. Intelligence Index v5.0.1, stan na 14 listopada 2026:
| Effort | Wynik Fable 5.2 | Wynik GPT-6.1 Sol | Czas zadania Fable 5.2 | Czas zadania Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 min | 2.0 min |
medium | 56 | 46 | 7.7 min | 4.6 min |
high | 62 | 50 | 16.2 min | 7.9 min |
xhigh | 62 | 52 | 27.9 min | 10.7 min |
max | 65 | 55 | 45.3 min | 23.3 min |
Jak czytać tę tabelę:
- Fable 5.2 ma wyższy wynik na każdym poziomie, o 10 do 19 punktów, co pasuje do pracy, w której najbardziej liczy się jakość odpowiedzi.
- Fable 5.2 na
lowwypada blisko Sol namax(54 wobec 55) w jednej czwartej czasu. - Sol osiąga swoje wyniki niskim kosztem: $1.27 za zadanie z indeksu przy maksymalnym effort, co pasuje do pracy na dużą skalę i projektów z ograniczonym budżetem.
- Fable szybciej generuje tokeny: około 94–102 tokenów wyjściowych na sekundę wobec 47–49 w Sol.
- Artificial Analysis oznacza swoje przebiegi Fable 5.2 etykietą „Default Fallback”, co oznacza, że podczas testów był włączony mechanizm fallback Anthropic na wypadek odmowy.
Wyniki z premiery Anthropic
Tabela Anthropic dla Fable 5.2 porównuje go z GPT-6 Astra, najwyższym segmentem OpenAI. Każdy model działał na najwyższym dostępnym poziomie effort, chyba że zaznaczono inaczej:
| Benchmark | Co mierzy | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Programowanie agentowe | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Inżynieria oprogramowania | 69.9% | 65.5% |
| AutomationBench | Procesy biznesowe | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Agentowe zadania naukowe | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Obsługa komputera | 89.3% | 79.5% |
| Remote Labor Index | Prawdziwe płatne zlecenia | 41.3% (high) | 20.8% |
| Humanity's Last Exam (z narzędziami) | Trudne rozumowanie | 74.2% | 57.2% |
| Chartography (bez narzędzi) | Rozumowanie na wykresach | 73.4% | 71.0% |

Wynik w FrontierCode 2.0 względem kosztu zadania na każdym poziomie effort. Wykres z materiałów Anthropic z premiery Claude Fable 5.2.
Wyniki z premiery OpenAI
OpenAI wydało GPT-6.1 Sol 29 września 2026, sześć tygodni przed Fable 5.2, i porównało go z własnymi modelami GPT-6. OpenAI przeznacza go do złożonego programowania, obsługi komputera i pracy zawodowej, a jego możliwości mają zbliżać się do GPT-6 Astra przy jednej piątej ceny tokenów Astry ($2 / $10 wobec $10 / $50). Ewaluacje z premiery obejmują inżynierię oprogramowania, rozumienie dokumentów, automatyzację procesów biznesowych i obsługę komputera.
Każdy dostawca prowadzi benchmarki we własnym środowisku i we własnej wersji testów, dlatego porównuj wyniki w obrębie tabeli jednego dostawcy, a do bezpośredniego porównania używaj powyższego indeksu Artificial Analysis.
Który model wybrać?
| Twoje obciążenie | Zacznij od | Dlaczego |
|---|---|---|
| Czat o dużym wolumenie, ekstrakcja, routing | GPT-6.1 Sol na medium (lub mniejszy model) | Obsługuje krótkie zadania za jedną czwartą ceny tokenów Fable |
| Codzienne programowanie i pętle agentów przy ograniczonym budżecie | GPT-6.1 Sol | Stworzony do programowania i pracy agentowej, za $2 / $10 oficjalnie i $1.60 / $8 w PoYo |
| Najtrudniejsze rozumowanie, research, długie autonomiczne przebiegi | Fable 5.2 | 65 wobec 55 w Intelligence Index; prowadzi z GPT-6 Astra w całej tabeli Anthropic |
| Trudne problemy, w których czekanie dużo kosztuje | Fable 5.2 na low lub medium | Wynik bliski maksimum Sol w jednej czwartej czasu |
| Obsługa komputera, wykresy, gęste dokumenty wizualne | Fable 5.2 | 89.3% w OSWorld 2.1 i 73.4% w Chartography w tabeli Anthropic |
| Prompty regularnie powyżej 272K tokenów | GPT-6.1 Sol w PoYo dla kosztów, Fable 5.2 dla głębi | W PoYo oba modele mają jedną stawkę w całym oknie: $1.60 / $8 w Sol, $6.40 / $32 w Fable |
| Rozwiązania oparte na narzędziach hostowanych OpenAI (powłoka, wyszukiwanie w sieci, MCP) | GPT-6.1 Sol | Te narzędzia działają natywnie przez Responses API |
| Jakość Claude w niższej cenie | Claude Opus 5.5 | $4 / $20; zob. Claude Fable 5.2 vs Opus 5.5 |
Długie autonomiczne przebiegi to mocna strona Fable 5.2: jego agenci zbudowali ten prototyp systemu operacyjnego, pokazany tu w działaniu na laptopie. Wideo z materiałów Anthropic z premiery Claude Fable 5.2.
Praktyczny sposób routingu: kieruj rutynowy ruch do GPT-6.1 Sol na medium, notuj, które typy zadań zyskują na głębszym rozumowaniu, i przekieruj je do Fable 5.2 na medium. Po tygodniu porównaj koszt zaakceptowanego zadania zamiast cen tokenów. Zestawienie Sol ze średnio wycenionym modelem Claude znajdziesz w artykule GPT-6.1 Sol vs Claude Opus 5.5.
Oba modele w PoYo
W PoYo łatwo korzystać z obu modeli:
- Jeden klucz API do Fable 5.2, GPT-6.1 Sol i wszystkich innych modeli czatu, obrazu, wideo i audio.
- Pay-as-you-go, rozliczanie za tokeny w kredytach, bez subskrypcji.
- Oba formaty API: Anthropic Messages oraz OpenAI Chat Completions i Responses.
- Jedna stawka na model w całym oknie kontekstu, o 20% niższa od każdej oficjalnej stawki za krótki kontekst:
| Opłata (za 1M tokenów) | Claude Fable 5.2 w PoYo | GPT-6.1 Sol w PoYo |
|---|---|---|
| Wejście | $6.40 | $1.60 |
| Wyjście | $32.00 | $8.00 |
| Odczyt z cache | $0.16 | $0.08 |
| Zapis do cache | $8.00 (5 min) / $12.80 (1 godz.) | $2.00 |
Fable 5.2 w formacie Anthropic Messages:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Sprawdź ten diff pod kątem błędów współbieżności: ..."}]
  }'
GPT-6.1 Sol przez Responses API:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Sprawdź ten diff pod kątem błędów współbieżności: ..."
  }'
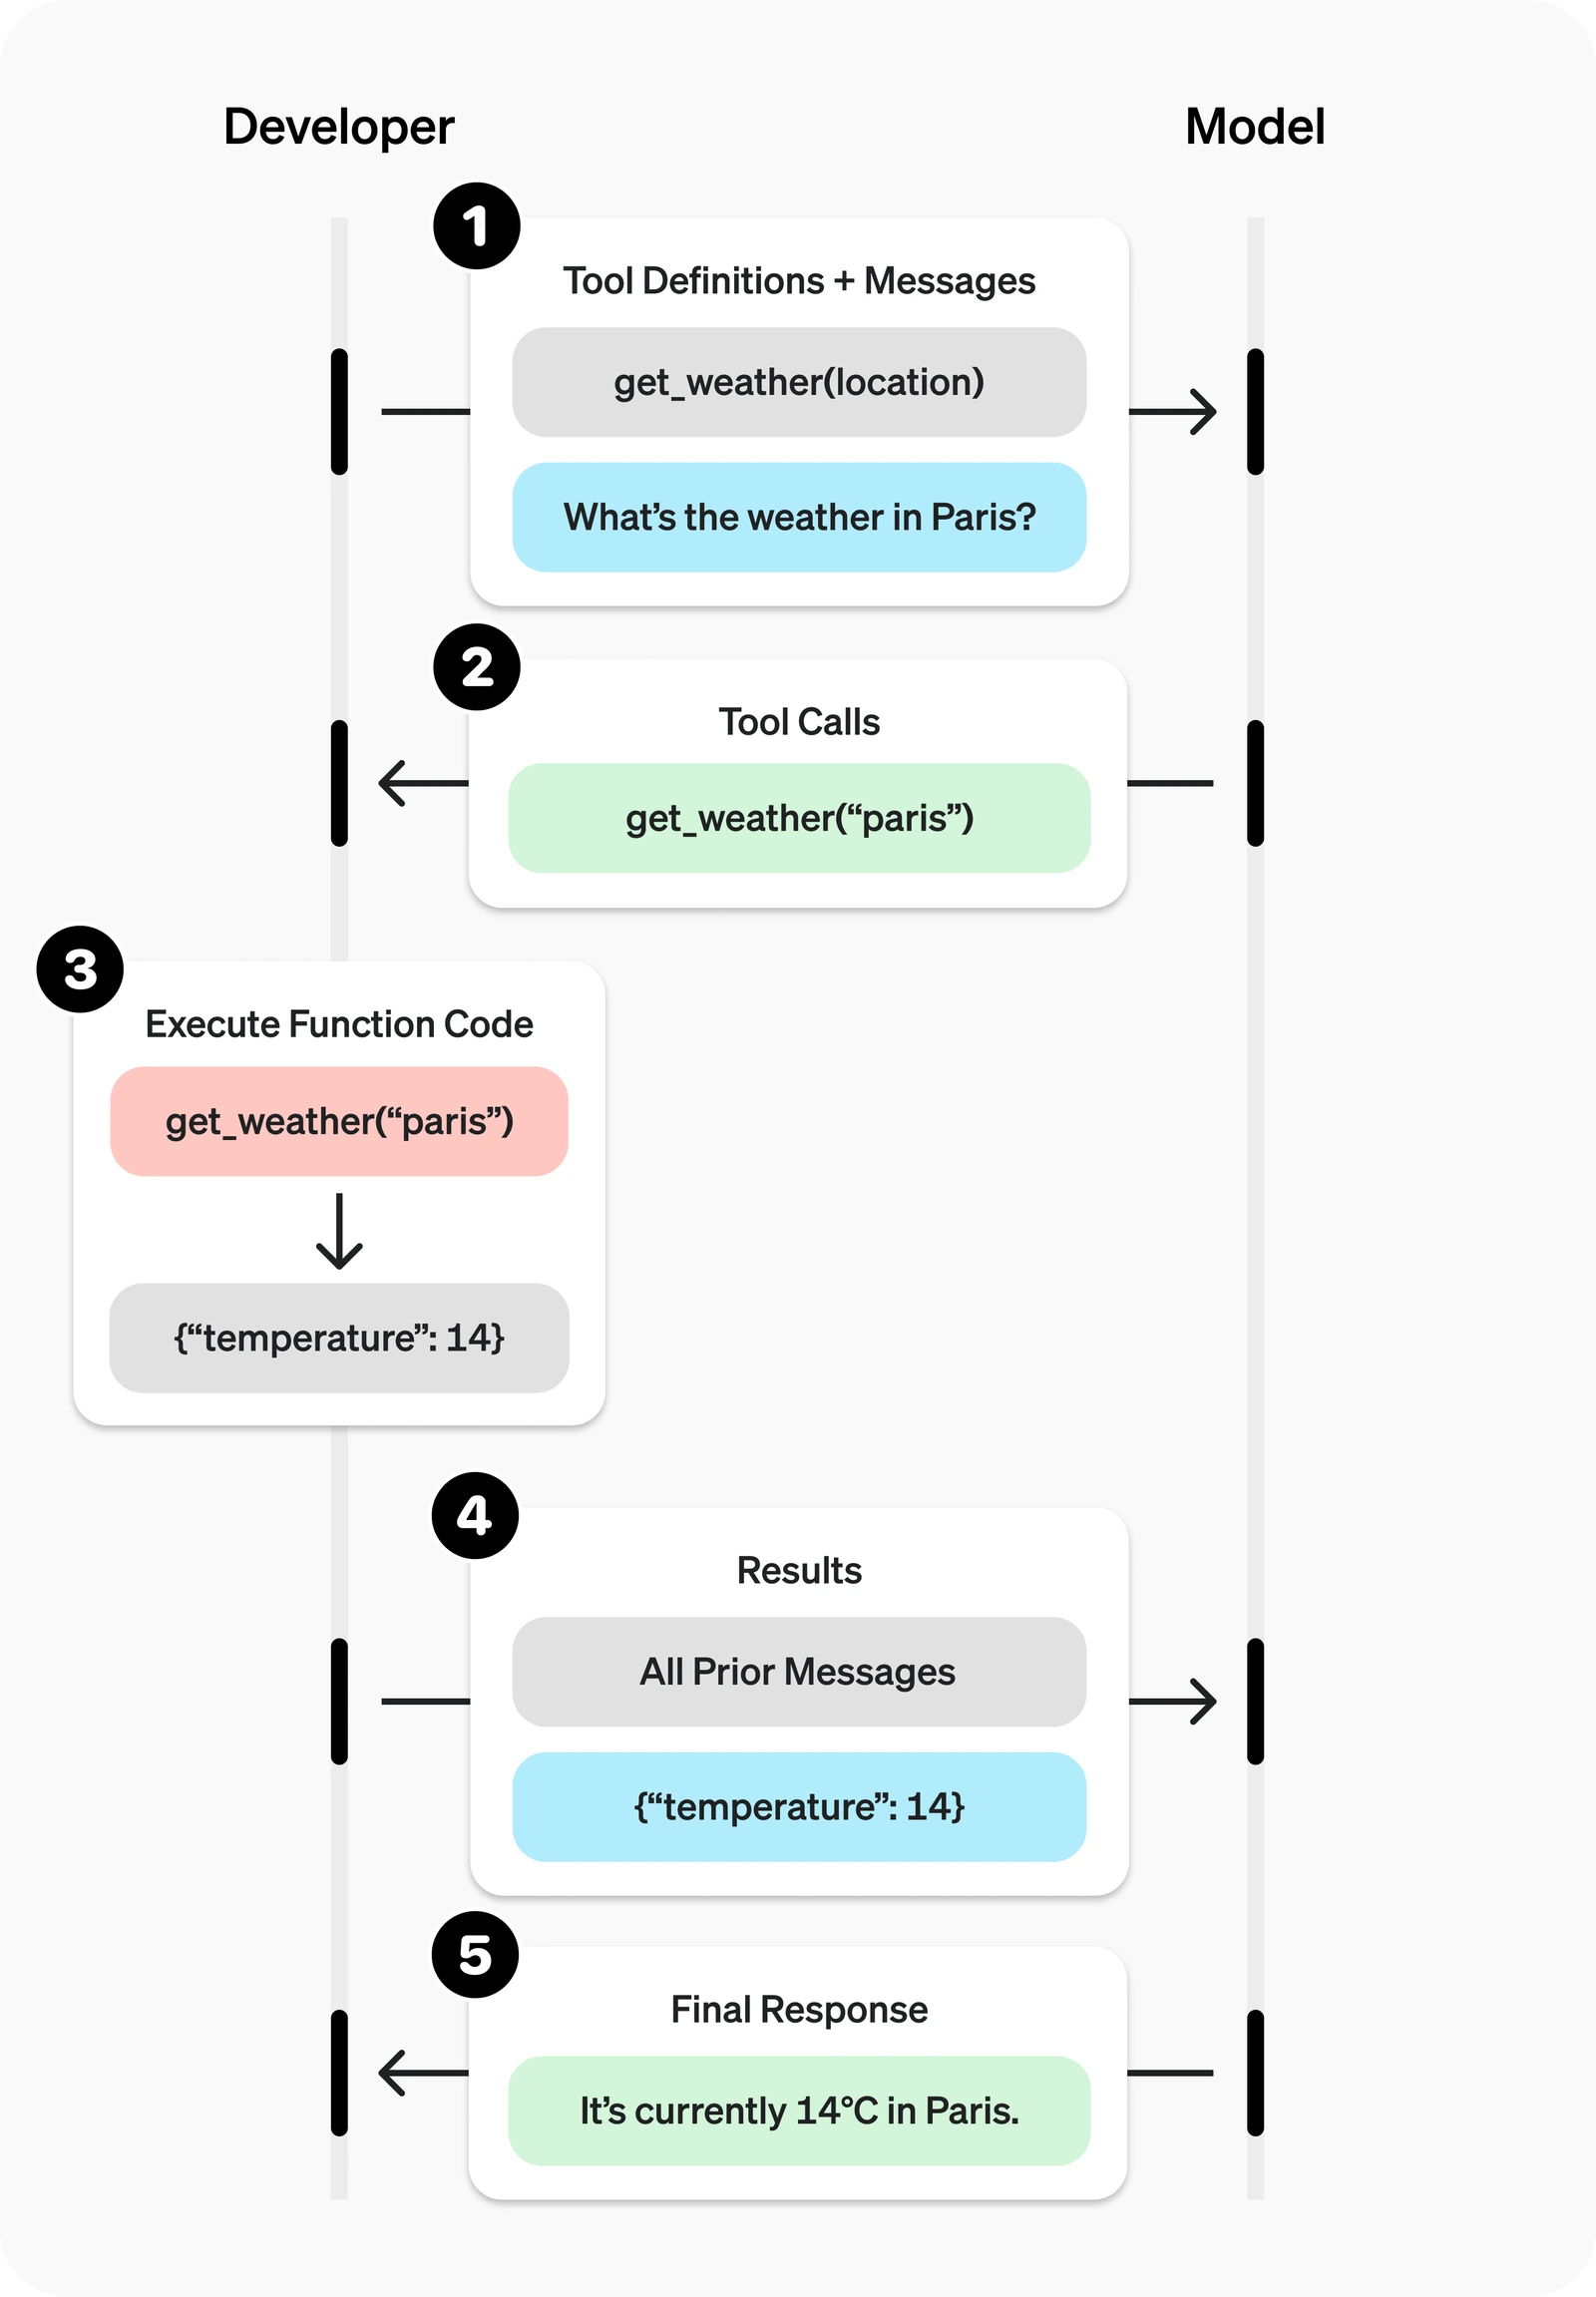
Pętla wywoływania funkcji, z której GPT-6.1 Sol korzysta przy pracy z narzędziami. Diagram z oficjalnej dokumentacji OpenAI.
Aby przeprowadzić test A/B obu modeli w jednej ścieżce kodu, wysyłaj claude-fable-5-2 i gpt-6.1-sol do /v1/chat/completions i zmieniaj tylko pole model. Konfigurację SDK, effort i cache w Fable opisuje nasz przewodnik po API Claude Fable 5.2, a limity i narzędzia Sol — przewodnik po funkcjach GPT-6.1 Sol.
Strony modeli: Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
Najczęstsze pytania
Czy Fable 5 jest lepszy od GPT-5.6 Sol?
Każdy z nich sprawdzał się w innej pracy. W testach z lipca 2026 Fable 5 zaliczył wszystkie 47 procesów z narzędziami w wielu aplikacjach w teście Composio (GPT-5.6 Sol zaliczył 45), a GPT-5.6 Sol uzyskał najwyższą ocenę we wszystkich trzech zadaniach Kilo z planowania architektury systemów przy niższej cenie tokenów. W obecnej generacji Fable 5.2 uzyskuje 65 punktów, a GPT-6.1 Sol 55 w Artificial Analysis Intelligence Index, przy czym Sol wykonuje zadanie za ułamek kosztu.
Czy GPT Astra będzie lepszy od Fable?
GPT-6 Astra jest już dostępny, w cenie $10 / $50 za milion tokenów. W tabeli Anthropic z premiery Fable 5.2 Fable 5.2 ma wyższy wynik niż GPT-6 Astra w każdym benchmarku, w którym testowano oba modele, np. 74,6% wobec 68,1% w Terminal-Bench-Science 0.1 i 89,3% wobec 79,5% w OSWorld 2.1. To pomiary samego Anthropic, więc przed decyzją przetestuj oba modele na własnych zadaniach.
Czy GPT-5.6 Luna jest lepszy?
Luna to najmniejszy i najbardziej przystępny cenowo segment GPT-5.6, stworzony do szybkiej pracy na dużą skalę, a Sol pasuje do trudniejszych zadań. Wybierz Lunę, gdy liczą się przepustowość i koszt, a Sol, gdy liczy się głębia. W obecnej generacji GPT-6 Luna kosztuje według cennika $0.10 / $0.50 za milion tokenów.
Czy GPT-5.6 Sol jest wart swojej ceny?
GPT-5.6 Sol to poprzednia generacja. W nowych projektach aktualnym modelem Sol od OpenAI jest GPT-6.1 Sol w cenie $2 / $10 za milion tokenów przy krótkim kontekście albo $1.60 / $8 w PoYo w całym oknie kontekstu. GPT-5.6 Sol nadal dobrze sprawdza się w integracjach, które są już do niego dostrojone.
Czy Claude Fable 5.2 jest lepszy od GPT-6.1 Sol?
Jeśli liczą się maksymalne możliwości, wybierz Fable 5.2: na każdym poziomie effort uzyskuje w Artificial Analysis Intelligence Index o 10 do 19 punktów więcej. Jeśli liczy się koszt, wybierz GPT-6.1 Sol: kosztuje jedną czwartą ceny za token, a przy maksymalnym effort około jednej dwudziestej kosztu zadania z indeksu.
Który model jest tańszy: Fable 5.2 czy GPT-6.1 Sol?
GPT-6.1 Sol. Oficjalne ceny to $2 / $10 za milion tokenów wejściowych/wyjściowych wobec $8 / $40 w Fable 5.2. Powyżej 272K tokenów wejściowych OpenAI podnosi cenę Sol do $4 / $15 za całe żądanie, a Fable pozostaje przy $8 / $40. W PoYo Sol kosztuje $1.60 / $8 przy każdej długości promptu.
Który model jest lepszy do programowania?
Obaj dostawcy podają wyniki programistyczne w różnych benchmarkach. Anthropic podaje dla Fable 5.2 49,1% w FrontierCode 2.0, co plasuje go przed GPT-6 Astra, a OpenAI stworzyło GPT-6.1 Sol do złożonego programowania za jedną piątą ceny tokenów Astry. Rozsądny punkt wyjścia to Sol do rutynowego programowania na dużą skalę i Fable 5.2 do dużych, długotrwałych zmian. Przetestuj oba modele na próbce własnych zgłoszeń.
Czy oba modele mają okno kontekstu 1M?
Tak, w przybliżeniu. Fable 5.2 ma okno 1M tokenów. GPT-6.1 Sol ma okno 1 050 000 tokenów, z czego do 922 000 może przypadać na wejście. Oba generują do 128K tokenów wyjściowych na żądanie.