
O Gemini 4 Argon (gemini-4-argon), da Google DeepMind, já está disponível na API PoYo. Apresentado em pré-visualização a defensores de cibersegurança de confiança no Programa Fairwind a 30 de setembro de 2026 e lançado globalmente em outubro de 2026, o Argon é um modelo de raciocínio de fronteira de nova geração, baseado numa arquitetura esparsa de Mixture-of-Experts (MoE), concebido para sustentar execuções profundas e em vários passos em engenharia de software, finanças, análise jurídica, investigação científica e cibersegurança defensiva.
A mudança de arquitetura mais importante para os programadores é um limite unificado de 1 000 000 de tokens entre entrada e saída, o primeiro do setor, que faz a capacidade máxima de saída passar de 64 000 para 1 000 000 de tokens numa única trajetória. Na PoYo, já podes chamar o gemini-4-argon a $1.60 por 1 M de tokens de entrada, $8.00 por 1 M de tokens de saída e $0.16 por 1 M de tokens de entrada em cache. A entrada e a saída ficam 20% abaixo das tarifas standard introdutórias da Google, de $2.00 / $10.00 (a tarifa de entrada em cache da Google é de $0.10 até 30 de novembro de 2026).
Especificações principais num relance
| Especificação | Gemini 4 Argon (gemini-4-argon) |
|---|---|
| Fornecedor e arquitetura | Google DeepMind · Transformer Sparse Mixture-of-Experts (MoE) |
| ID do modelo na API PoYo | gemini-4-argon |
| Janela de contexto unificada | 1 000 000 de tokens (entrada + saída combinadas) |
| Máximo de tokens de saída | Até 1 000 000 de tokens (contra 64 K no Gemini 3.x) |
| Modalidades de entrada nativas | Texto, imagens, áudio, vídeo e documentos PDF |
| Modalidade de saída | Texto (incluindo tokens de raciocínio/thinking e código estruturado) |
| Data-limite de conhecimento | março de 2026 |
| Endpoints PoYo suportados | POST /v1/chat/completions (compatível com OpenAI)POST /v1beta/models/gemini-4-argon:generateContent & :streamGenerateContent (Gemini Native) |
Preços da API Gemini 4 Argon: Google oficial vs PoYo
A Google lançou o Gemini 4 Argon com uma tarifa standard introdutória de $2.00 por milhão de tokens de entrada e $10.00 por milhão de tokens de saída (a subir para $4.00 / $20.00 depois de 30 de novembro de 2026). A PoYo pratica preços 20% abaixo dessas tarifas introdutórias, com créditos pagos conforme a utilização (200 credits = $1.00 USD):
| Contador de tokens | Standard oficial da Google | Preço da API PoYo (USD) | Créditos PoYo / 1 M de tokens | Poupança |
|---|---|---|---|---|
| Tokens de entrada | $2.00 / 1M | $1.60 / 1M | 320 créditos | 20% de desconto |
| Tokens de saída (incl. thinking) | $10.00 / 1M | $8.00 / 1M | 1600 créditos | 20% de desconto |
| Tokens de leitura da cache | $0.10 / 1M | $0.16 / 1M | 32 créditos | — |
Exemplos de custo em cargas de trabalho reais
Como o Gemini 4 Argon consegue gerar mais de 100 K tokens de thinking e de saída numa única passagem, os tokens de saída dominam o gasto total por tarefa. Eis como a PoYo se compara com os preços oficiais em três cargas de produção típicas:
- Refatoração de um repositório com vários ficheiros (150 K de entrada + 50 K de saída, incluindo thinking):
- Google Standard:
0.15 × $2.00 + 0.05 × $10.00= $0.80 por execução - API PoYo:
0.15 × $1.60 + 0.05 × $8.00= $0.64 por execução (128 créditos)
- Google Standard:
- Due diligence financeira/jurídica empresarial com corpus em cache (400 K de entrada em cache + 50 K de entrada nova + 25 K de saída):
- Google Standard:
0.40 × $0.10 + 0.05 × $2.00 + 0.025 × $10.00= $0.39 por execução - API PoYo:
0.40 × $0.16 + 0.05 × $1.60 + 0.025 × $8.00= $0.344 por execução (68,8 créditos)
- Google Standard:
- Ciclo de agent de grande volume (10 M de entrada + 3 M de saída por mês):
- Google Standard: $50.00 / mês
- API PoYo: $40.00 / mês (8000 créditos)
Para testar o gemini-4-argon de forma interativa ou consultar os escalões de preços em direto, visita a página do modelo Gemini 4 Argon na PoYo.
Benchmarks: Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5
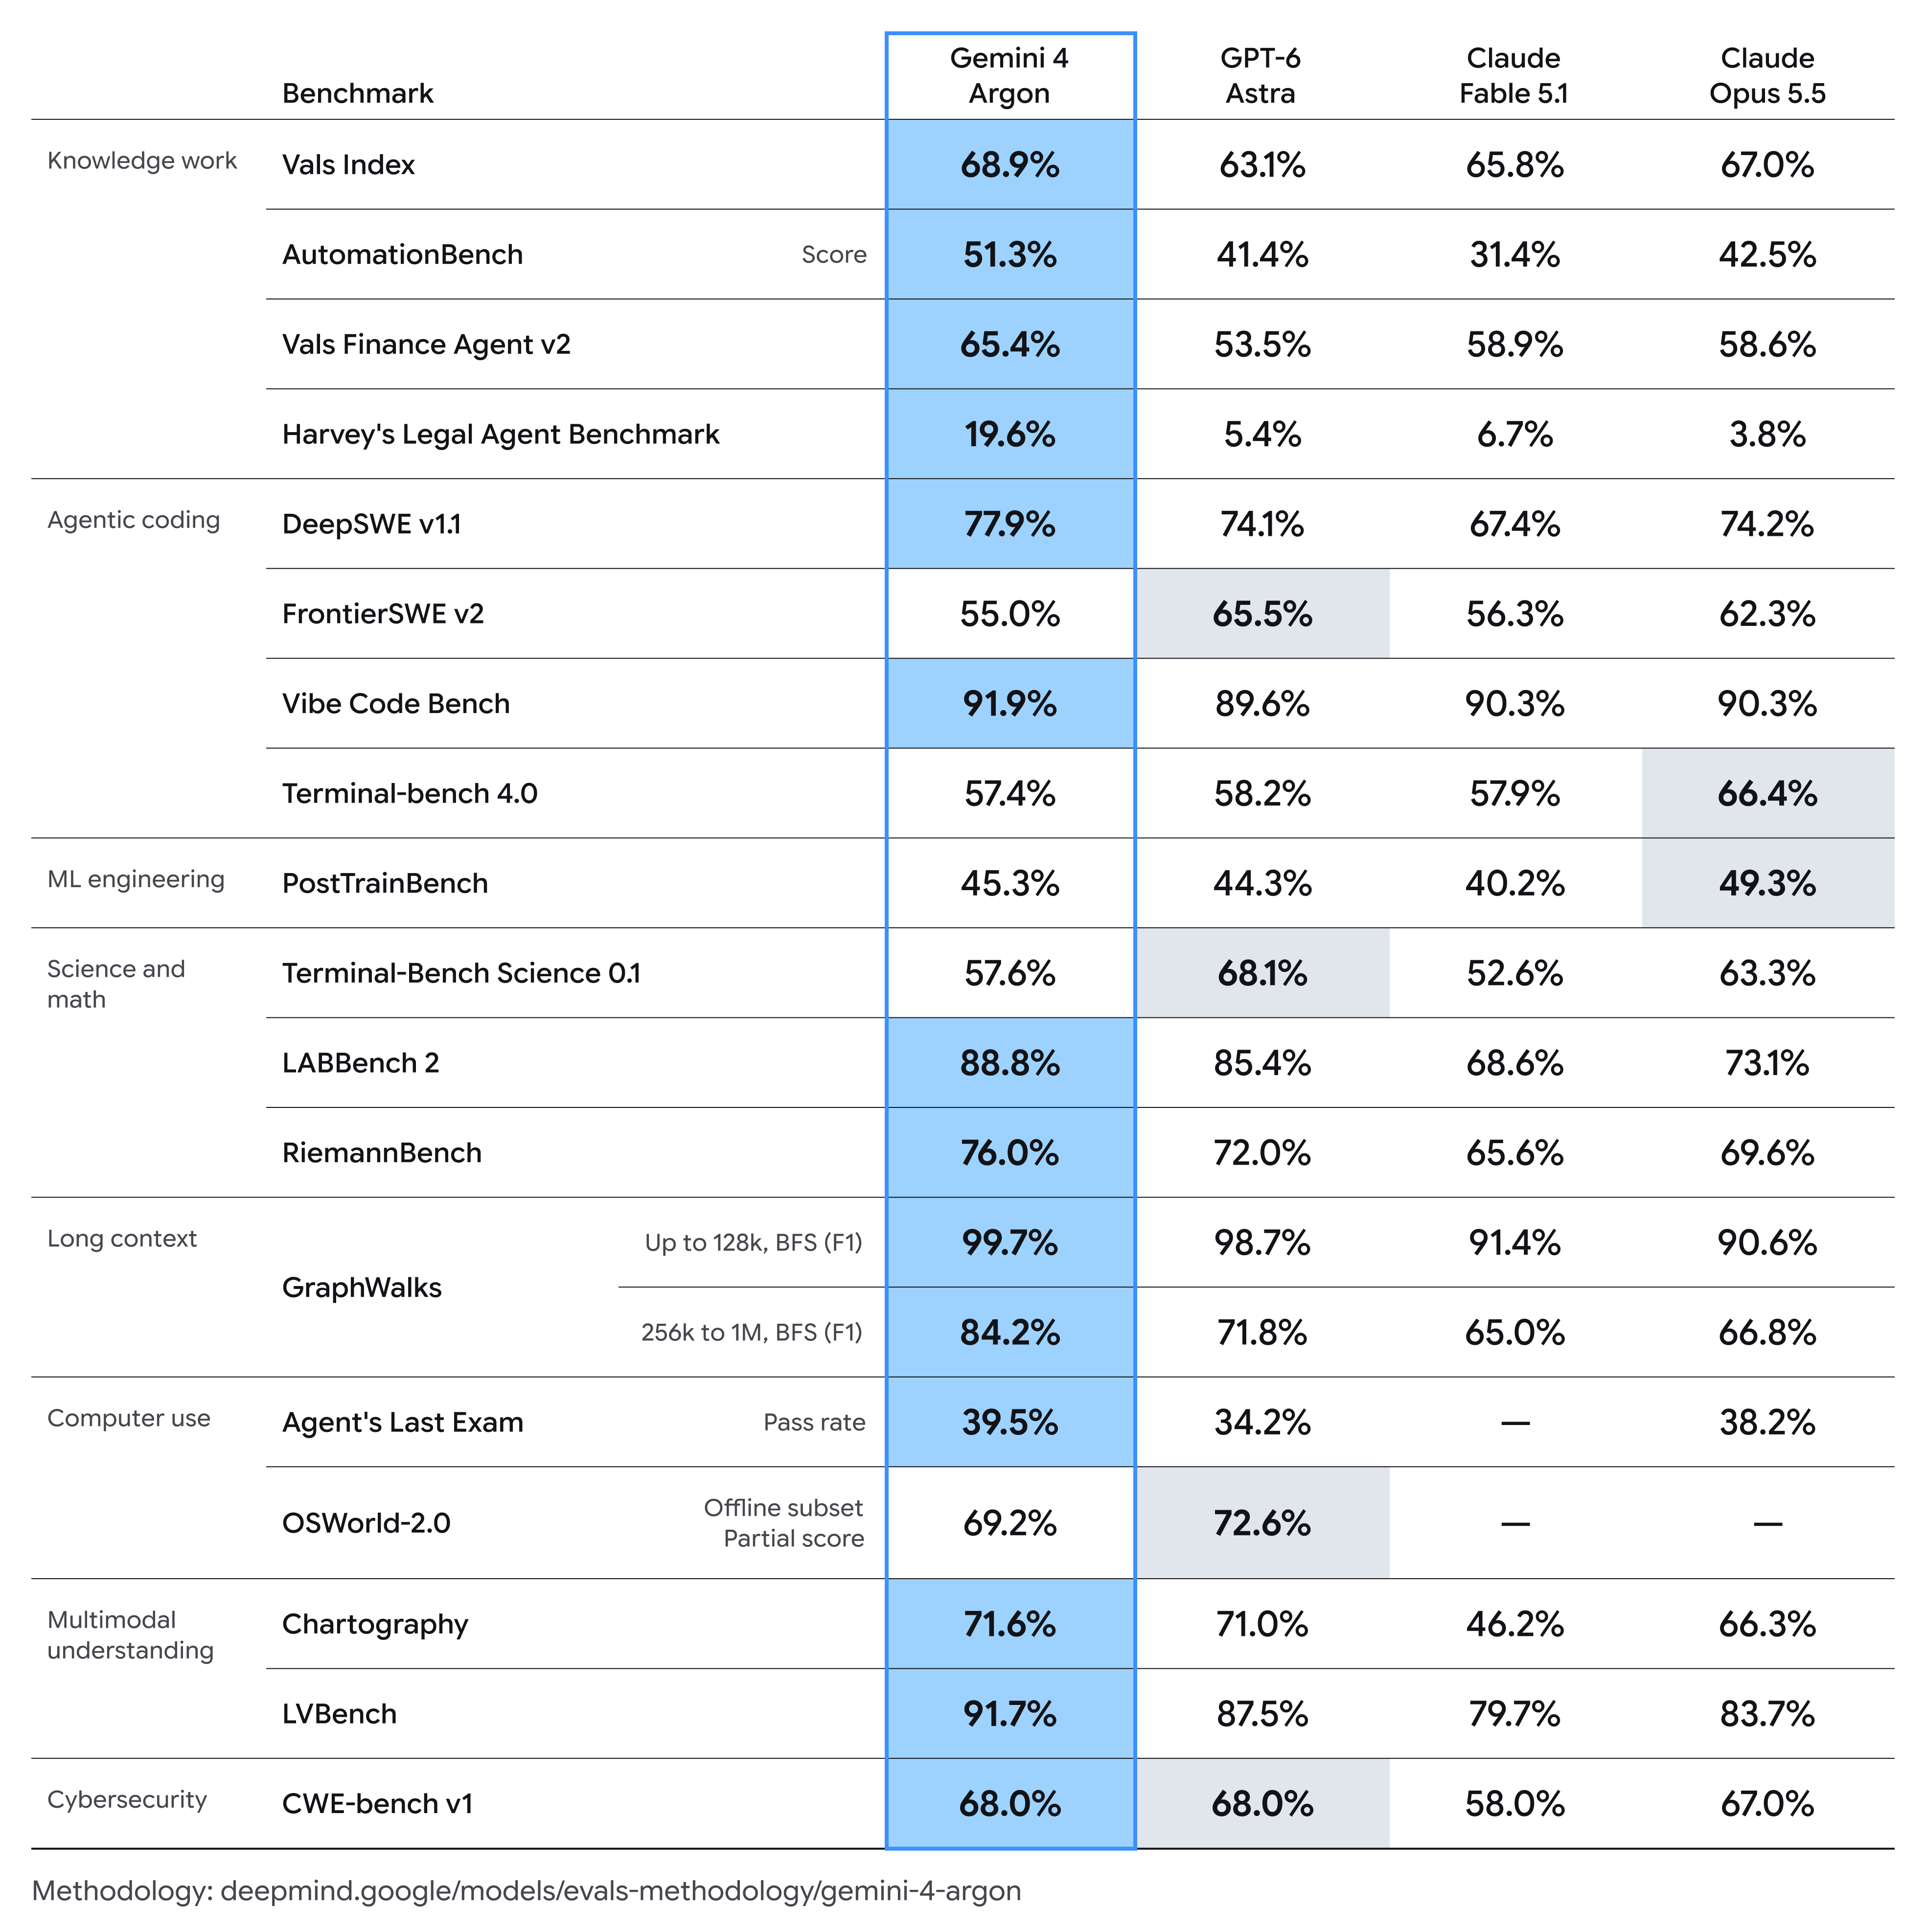
Nas avaliações do Model Card da Google DeepMind de outubro de 2026, o Gemini 4 Argon lidera em 13 de 18 benchmarks publicados e empata em 1, quando comparado com o GPT-6 Astra, o Claude Opus 5.5 e o Claude Fable 5.1:
| Categoria | Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|
| Trabalho do conhecimento | Vals Index (ponderado pelo PIB) | 68,9% | 63,1% | 67,0% | 65,8% |
| AutomationBench (Zapier) | 51,3% | 41,4% | 42,5% | 31,4% | |
| Vals Finance Agent v2 | 65,4% | 53,5% | 58,6% | 58,9% | |
| Harvey's Legal Agent Benchmark | 19,6% | 5,4% | 3,8% | 6,7% | |
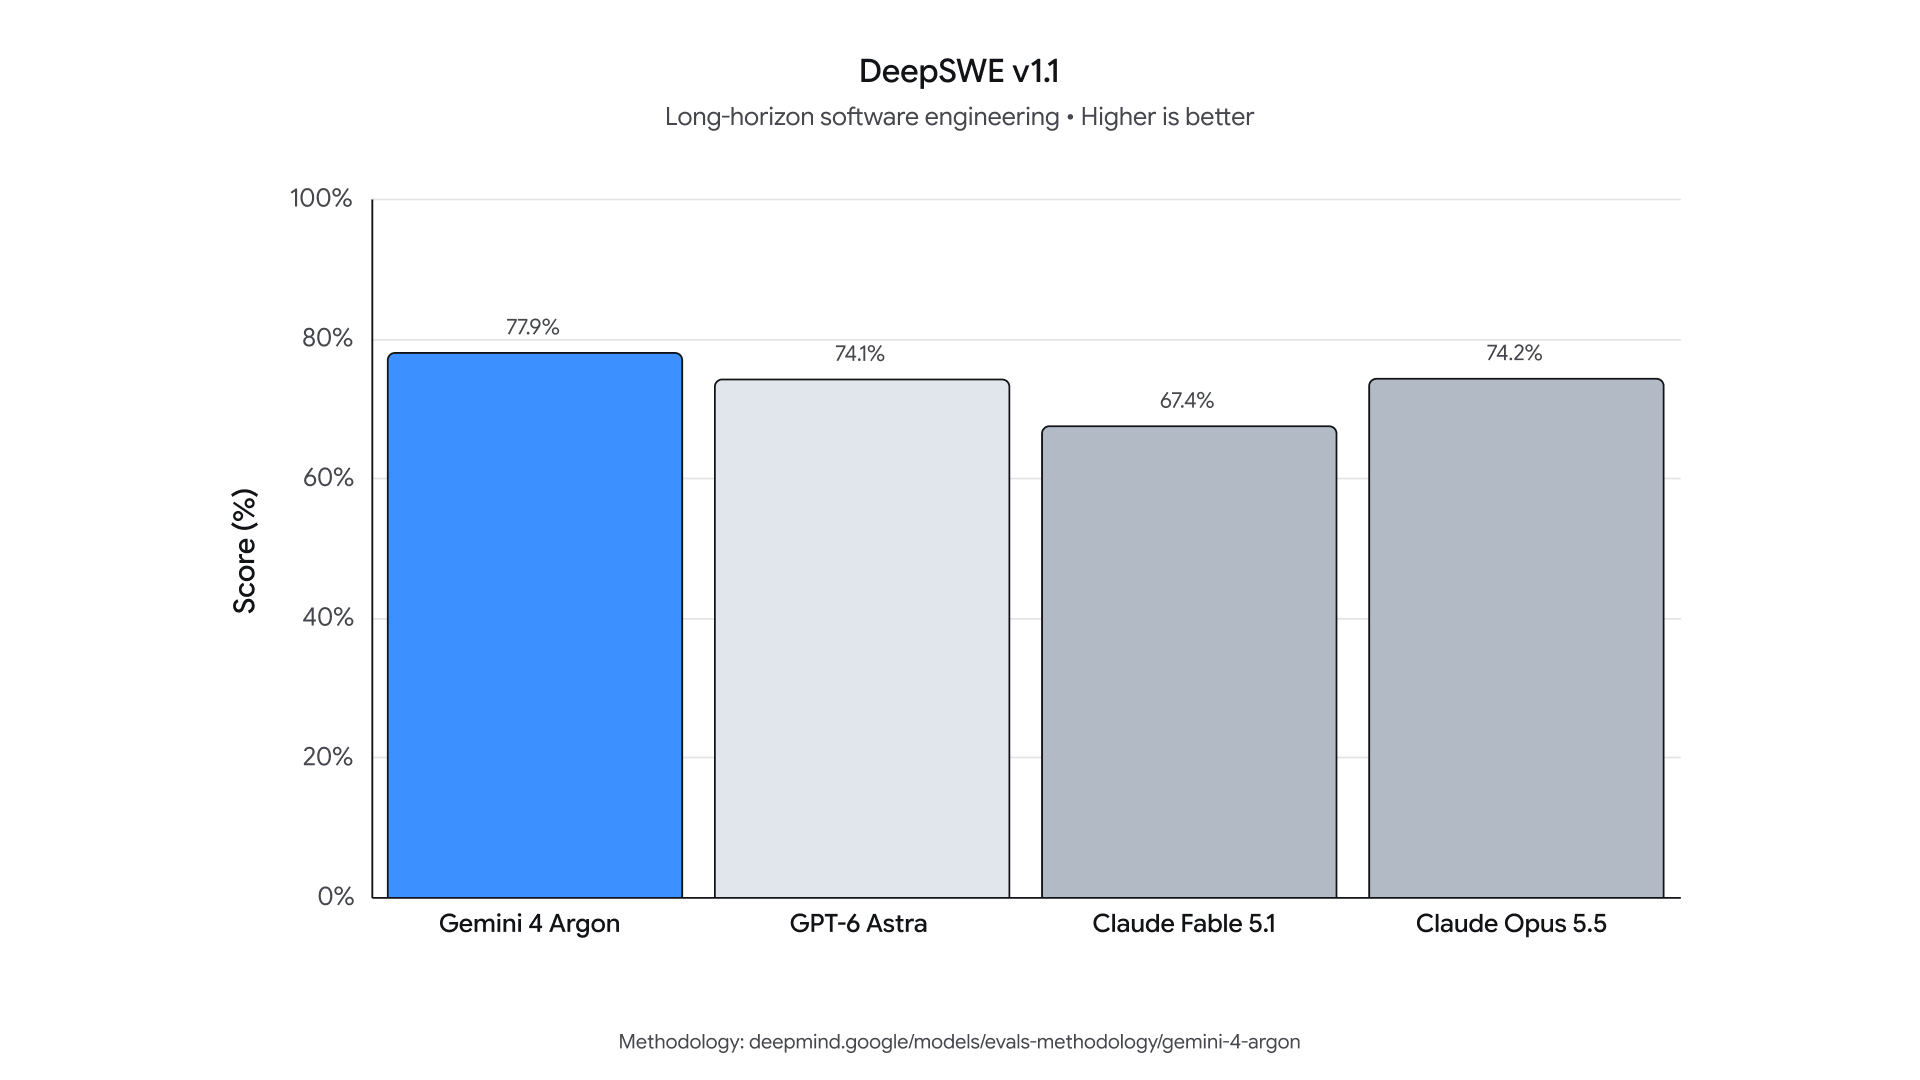
| Programação com agents | DeepSWE v1.1 | 77,9% | 74,1% | 74,2% | 67,4% |
| Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% | |
| FrontierSWE v2 | 55,0% | 65,5% | 62,3% | 56,3% | |
| Terminal-Bench 4.0 | 57,4% | 58,2% | 66,4% | 57,9% | |
| Engenharia de ML | PostTrainBench | 45,3% | 44,3% | 49,3% | 40,2% |
| Ciência e matemática | LABBench 2 | 88,8% | 85,4% | 73,1% | 68,6% |
| RiemannBench | 76,0% | 72,0% | 69,6% | 65,6% | |
| Terminal-Bench Science 0.1 | 57,6% | 68,1% | 63,3% | 52,6% | |
| Contexto longo | GraphWalks (≤128K, BFS F1) | 99,7% | 98,7% | 90,6% | 91,4% |
| GraphWalks (256K–1M, BFS F1) | 84,2% | 71,8% | 66,8% | 65,0% | |
| Utilização do computador | Agent's Last Exam (taxa de aprovação) | 39,5% | 34,2% | 38,2% | — |
| OSWorld-2.0 (parcial offline) | 69,2% | 72,6% | — | — | |
| Multimodal | LVBench (vídeo longo) | 91,7% | 87,5% | 83,7% | 79,7% |
| Chartography | 71,6% | 71,0% | 66,3% | 46,2% | |
| Cibersegurança | CWE-bench v1 | 68,0% | 68,0% | 67,0% | 58,0% |
Principais conclusões para o encaminhamento de modelos
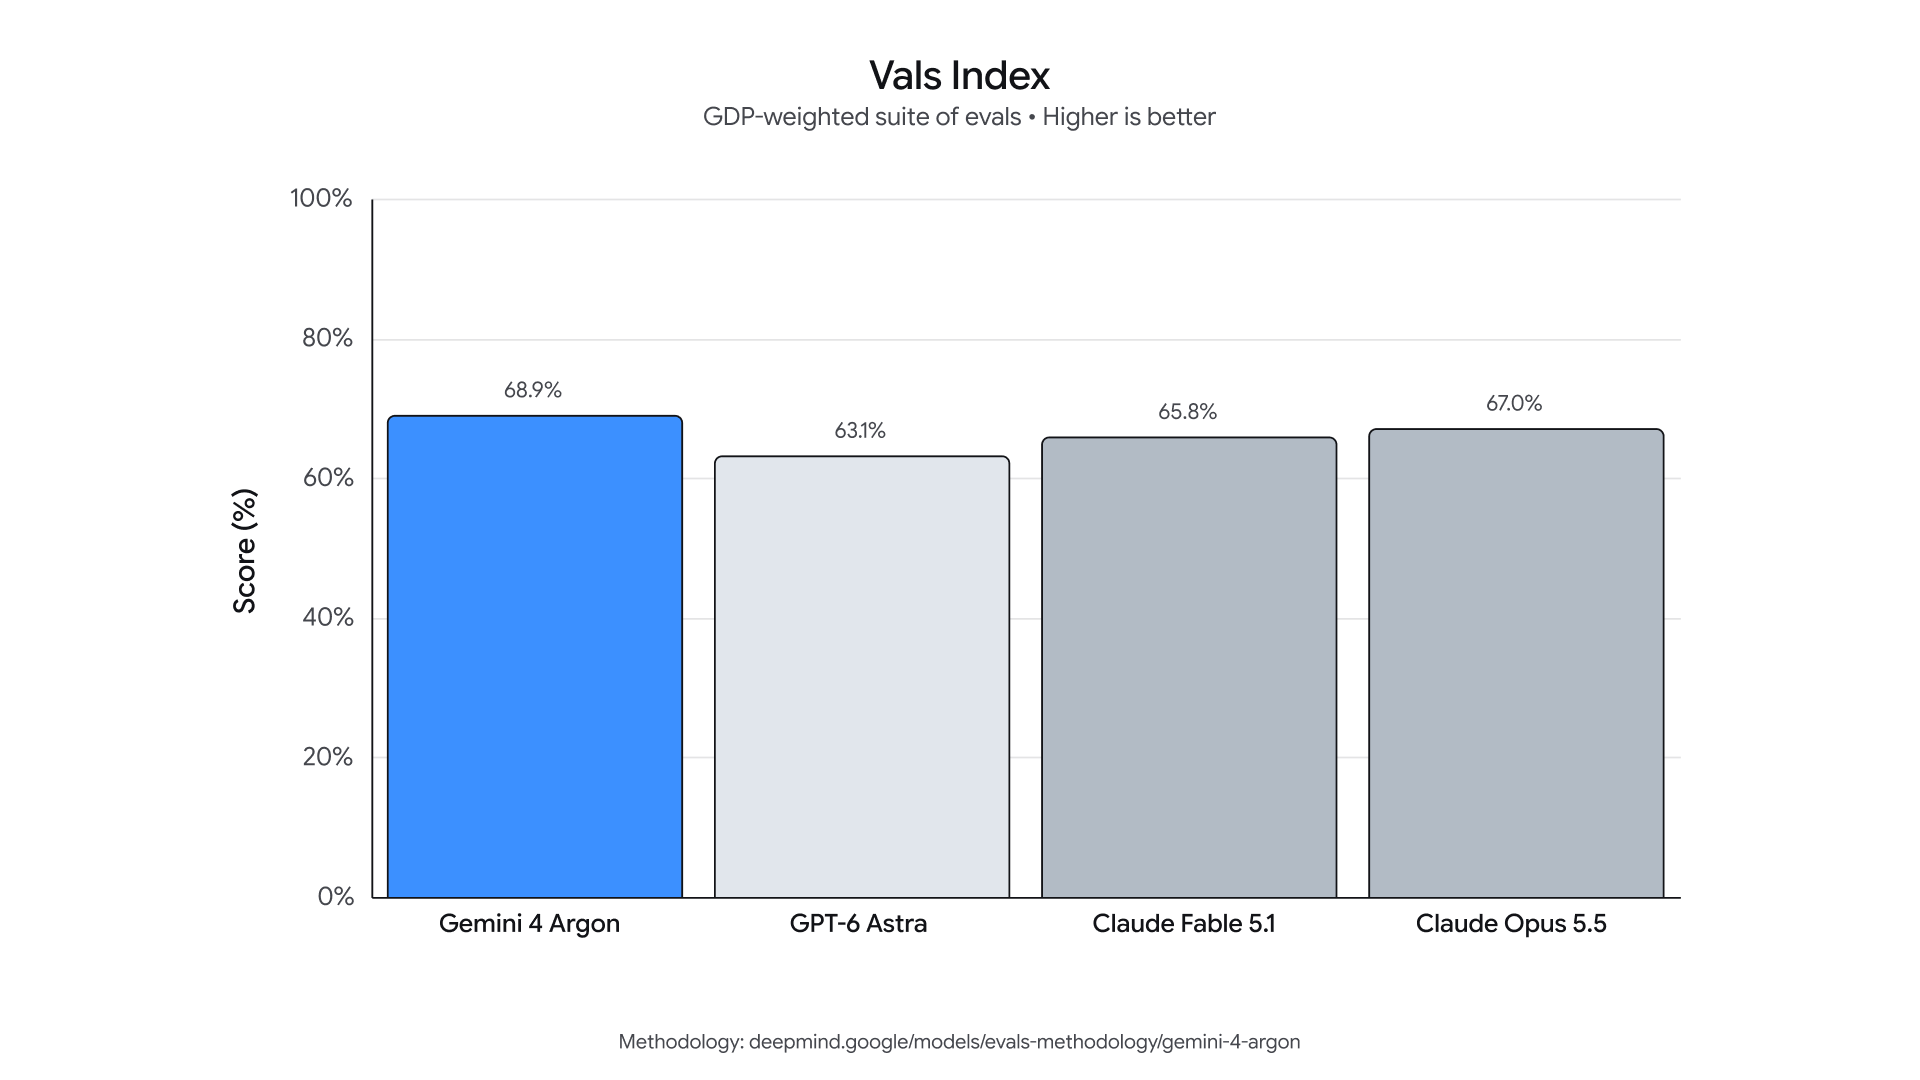
- Onde o Gemini 4 Argon ganha com clareza: refatoração de repositórios de longo horizonte (DeepSWE v1.1: 77,9%), raciocínio com contexto ultralongo entre 256 K e 1 M de tokens (GraphWalks: 84,2% vs 66,8% do Opus 5.5), fluxos de trabalho empresariais estruturados (AutomationBench: 51,3%), síntese jurídica e financeira (Harvey: 19,6%, Vals Finance: 65,4%) e análise multimodal de vídeos longos (LVBench: 91,7%).
- Onde o Claude Opus 5.5 ou o GPT-6 Astra têm vantagem: execução interativa de comandos na shell (Terminal-Bench 4.0, em que o Claude Opus 5.5 obtém 66,4% contra 57,4% do Argon) e harnesses especializados de SWE/ciência (FrontierSWE v2 e Terminal-Bench Science 0.1, onde lidera o GPT-6 Astra).
- Vantagem de preço/desempenho: a $1.60 / $8.00 na PoYo, o Gemini 4 Argon custa 50% menos por token do que o Claude Opus 5.5 ($3.20 / $16.00 na PoYo) e 80% menos do que o GPT-6 Astra ($8.00 / $40.00 na PoYo), ficando no mesmo escalão de preço por token do GPT-6.1 Sol e do Claude Sonnet 5.5, mas com raciocínio de fronteira de topo.
O que torna o Gemini 4 Argon diferente em produção?
1. Janela unificada de 1 M entre entrada e saída para trajetórias sem interrupções
Os modelos Gemini anteriores limitavam a saída a 64 K tokens, o que obrigava os agents de programação e de investigação a truncar diffs grandes ou a juntar continuações em vários turnos. Ao unificar o conjunto de 1 M de tokens entre entrada e saída, o Argon pode gastar mais de 100 000 tokens em raciocínio interno em cadeia e, mesmo assim, emitir numa só resposta migrações de código completas com vários ficheiros, demonstrações matemáticas formais em Lean ou auditorias de conformidade exaustivas.
Dentro da Google, os engenheiros usaram o Argon para separar 6 milhões de linhas de código legado de funcionalidades do navegador do repositório de 40 milhões de linhas do Chromium, reescrever 32 K linhas de descodificação de vídeo SIMD da libgav1 em Rust seguro (a correr 2,7 vezes mais depressa do que a anterior migração para Rust) e acelerar 2,85 vezes o débito de inferência do Gemma 4 E2B em vLLM, em GPUs A100.
2. Cibersegurança defensiva e resistência a prompt injection
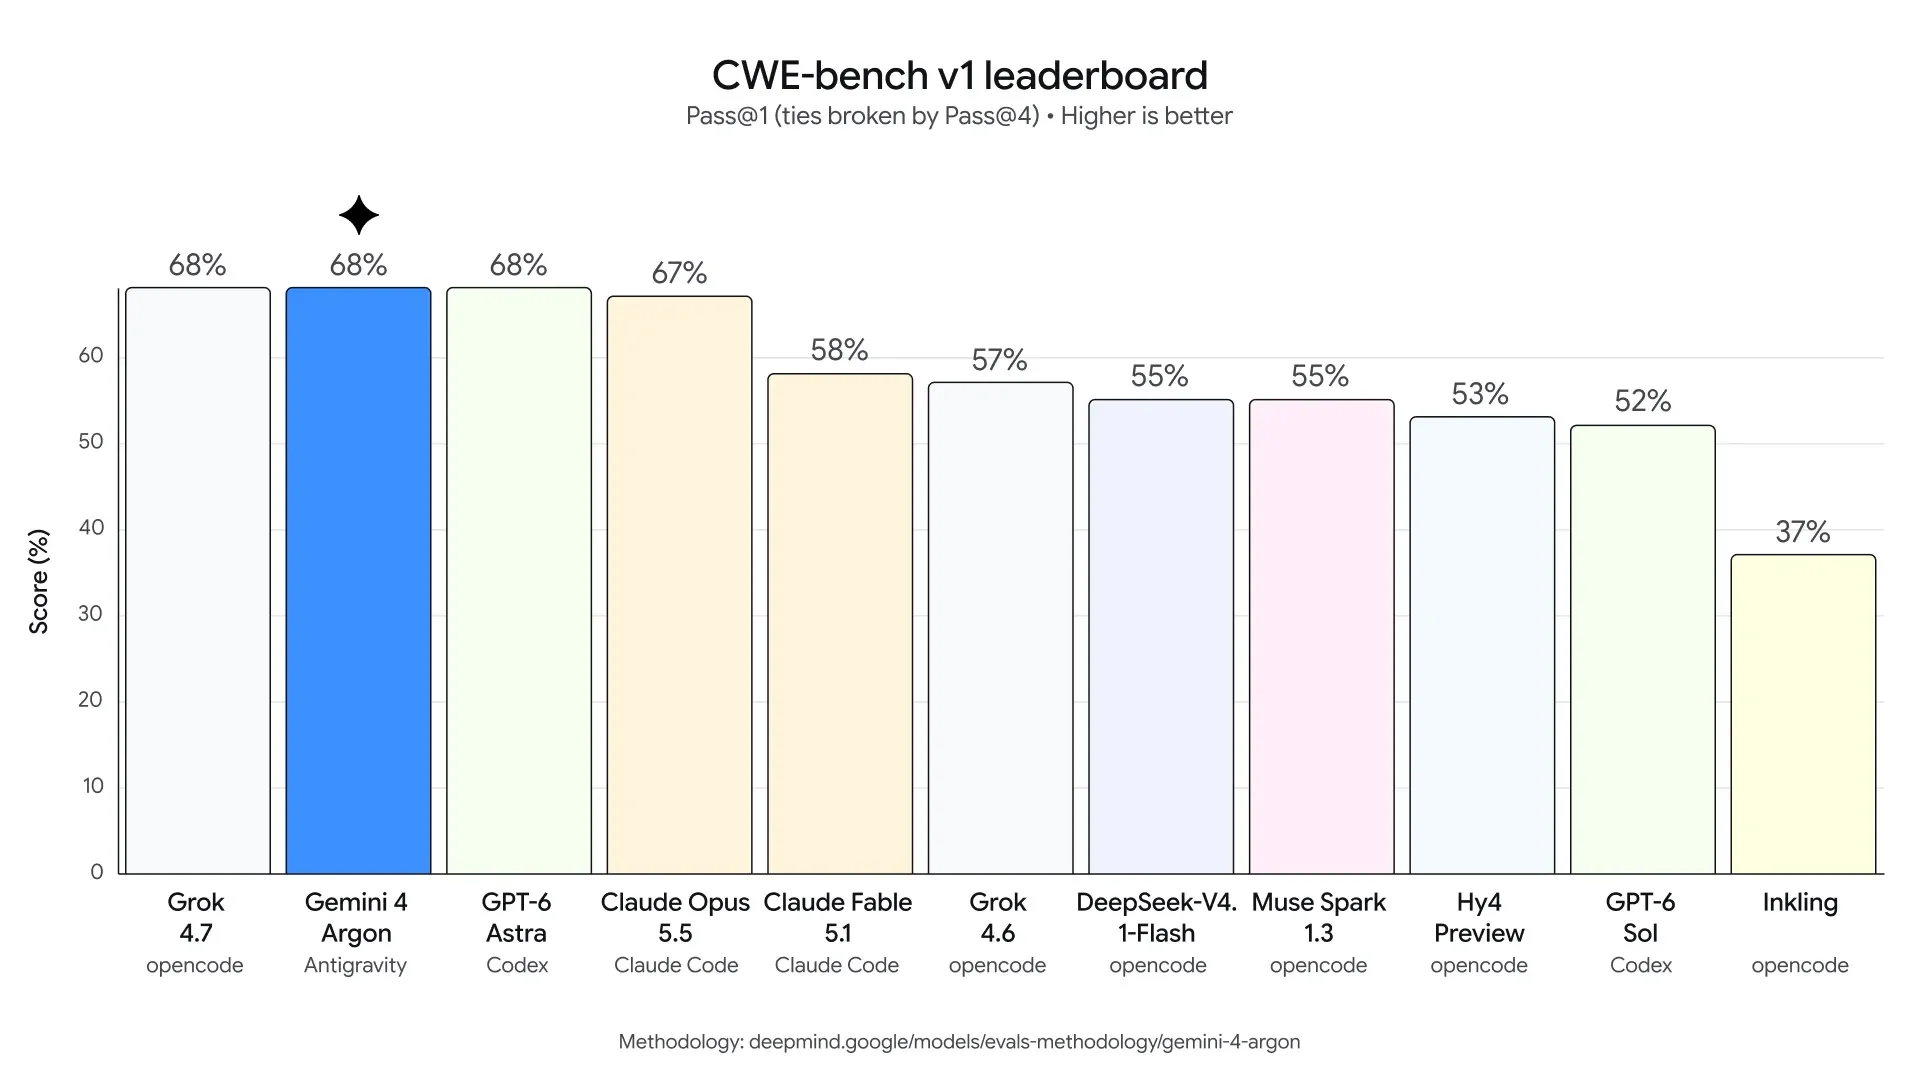
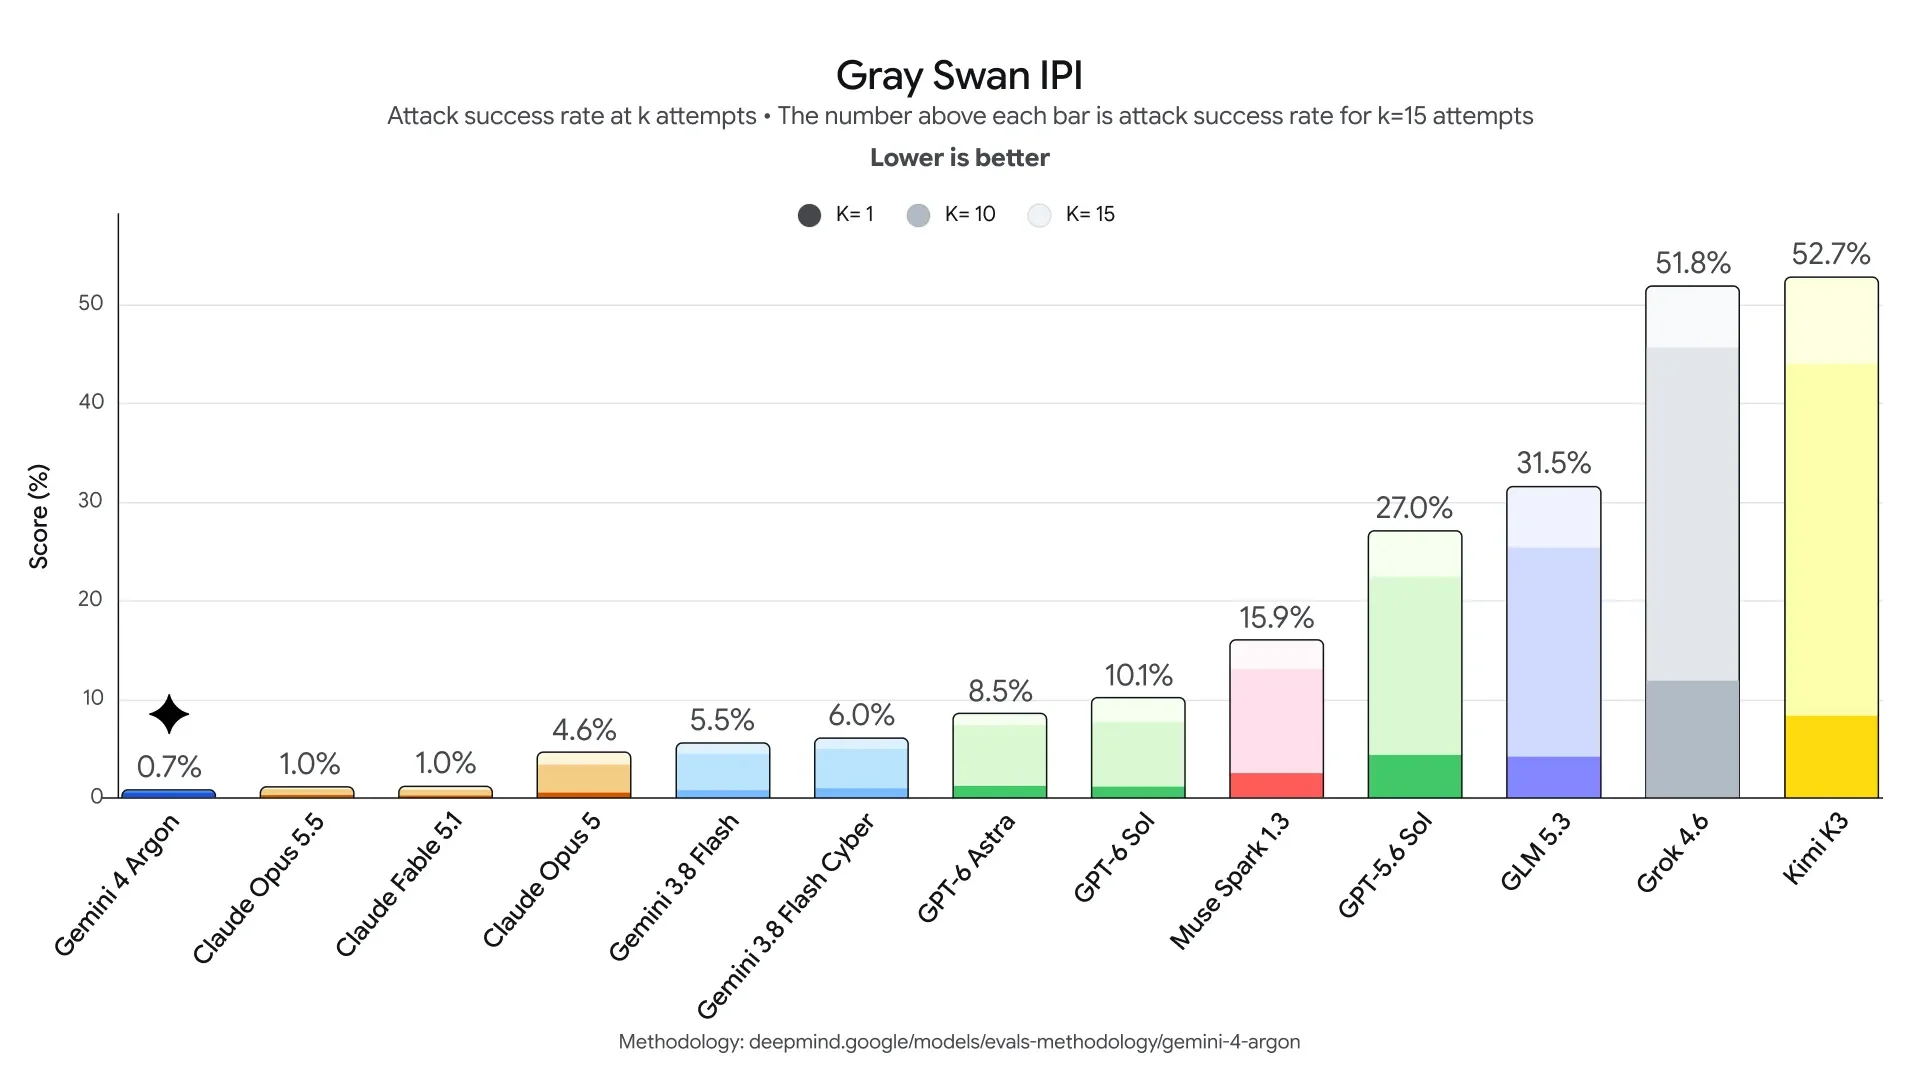
Treinado para equipas de segurança defensiva no Programa Fairwind da Google e utilizado na iniciativa Scan for Good da Wiz, o Argon empata em 1.º lugar no CWE-bench v1 (68,0%) e descobre cadeias de vulnerabilidades em vários passos em 20 linguagens de programação. Para agents empresariais que navegam em páginas web não fiáveis ou analisam PDFs externos, o Argon atinge uma taxa de sucesso de ataque de 0,7% em 15 tentativas adaptativas no benchmark de Indirect Prompt Injection (IPI) da Gray Swan, a taxa de sequestro mais baixa registada entre os modelos de fronteira.
3. Raciocínio nativo multimodal, espacial 3D e científico
Ao contrário dos modelos de texto mais imagem, o Argon ingere de forma nativa texto, imagens de alta resolução, áudio, vídeo longo e PDFs. Obtém 87% em Embodied Reasoning (ERQA) e 91,7% no LVBench, o que permite pipelines de robótica “Video-to-Sim-to-Real”, reconstruções arqueológicas em 3D a partir de 50 GB de arquivos LiDAR e CAD e uma previsão de estruturas moleculares em química quântica (xTB) 2,3 vezes mais rápida.
Como chamar a API Gemini 4 Argon na PoYo
A PoYo suporta tanto o OpenAI Chat Completions (/v1/chat/completions) como o Google Gemini Native (/v1beta/models/gemini-4-argon:generateContent e :streamGenerateContent) com uma única chave de API da PoYo.
Opção 1: Chat Completions compatível com OpenAI (POST /v1/chat/completions)
Usa o teu SDK OpenAI de Python/Node ou o cURL, definindo o URL base como https://api.poyo.ai/v1 e o modelo como gemini-4-argon:
curl --request POST \
  --url https://api.poyo.ai/v1/chat/completions \
  --header "Authorization: Bearer YOUR_POYO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "gemini-4-argon",
    "messages": [
      {
        "role": "system",
        "content": "You are a principal systems architect and security auditor."
      },
      {
        "role": "user",
        "content": "Design a memory-safe Rust migration plan for a C++ video frame ring buffer, including zero-copy slices and unit tests."
      }
    ],
    "temperature": 1.0,
    "max_tokens": 16384,
    "stream": false
  }'
Opção 2: formato Google Gemini Native (:generateContent e :streamGenerateContent)
Para partes multimodais nativas, systemInstruction e generationConfig, chama diretamente o endpoint nativo do Gemini:
curl --request POST \
  --url "https://api.poyo.ai/v1beta/models/gemini-4-argon:generateContent" \
  --header "Authorization: Bearer YOUR_POYO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "systemInstruction": {
      "parts": [
        { "text": "Provide rigorous financial and legal analysis with explicit citations." }
      ]
    },
    "contents": [
      {
        "role": "user",
        "parts": [
          { "text": "Compare the working capital adjustments and indemnification caps across these merger agreement clauses." }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "maxOutputTokens": 32768,
      "topP": 0.95
    }
  }'
Para respostas em streaming no formato Gemini Native, substitui :generateContent por :streamGenerateContent?alt=sse.
Perguntas frequentes
Qual é o ID exato do modelo Gemini 4 Argon na PoYo?
Usa gemini-4-argon tanto em /v1/chat/completions como em /v1beta/models/gemini-4-argon:generateContent.
Os tokens de thinking são faturados à parte?
De acordo com a especificação de faturação da Google, a utilização de tokens de saída inclui os tokens de raciocínio interno (thinking) e é faturada à tarifa de saída da PoYo de $8.00 por 1 M de tokens (1600 créditos). Define max_tokens ou maxOutputTokens de forma adequada para limitar o gasto em raciocínio nas tarefas de rotina.
Como posso começar?
Gera a tua chave de API no dashboard da PoYo, testa prompts em direto no Playground do Gemini 4 Argon ou explora todos os modelos de chat de fronteira no catálogo da API de chat com IA da PoYo.