
01
编程与智能体工作流
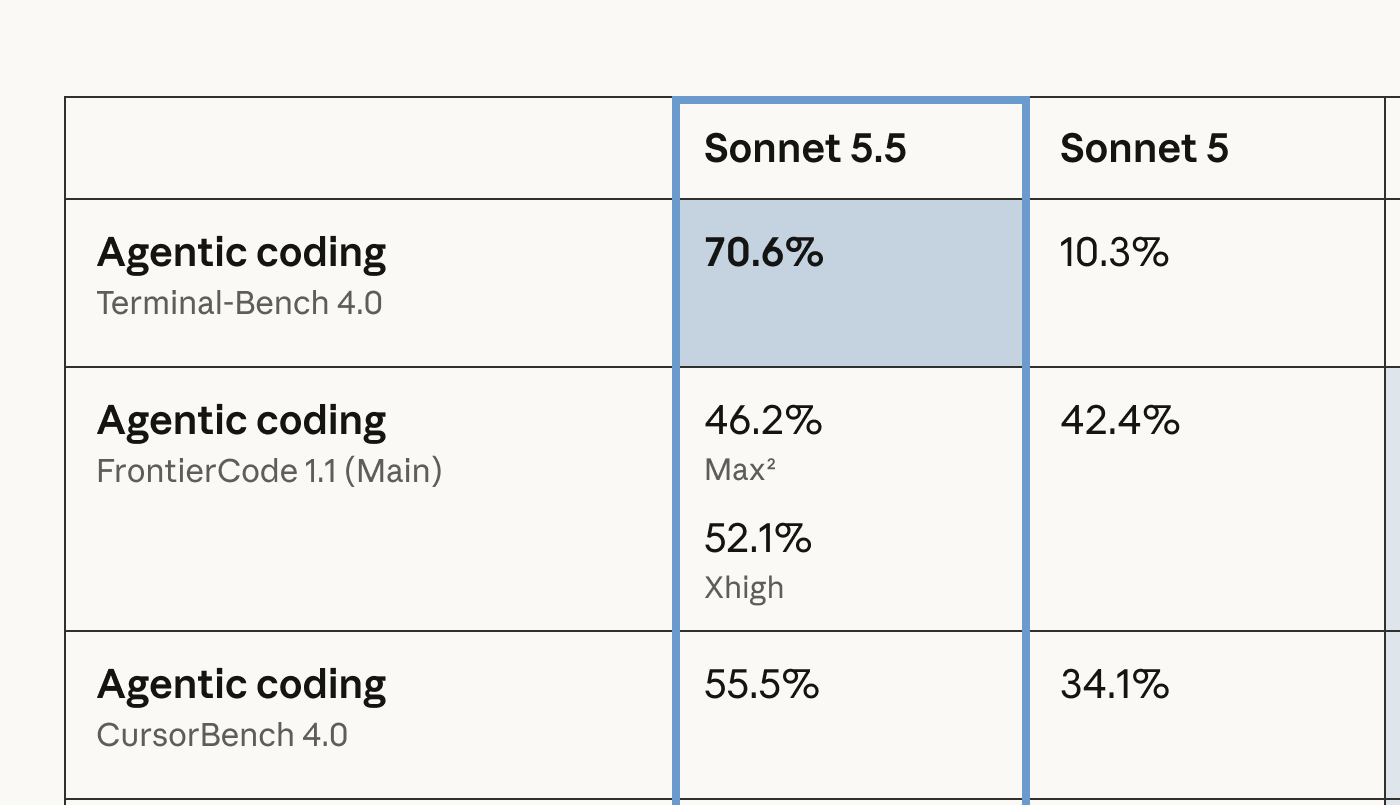
Claude Sonnet 5.5 适合范围明确的开发任务与多步骤专业工作。Anthropic 公布的 Terminal-Bench 4.0 成绩为 70.6%,同一评测中的 Sonnet 5 为 10.3%。它可以理解代码、调用工具、修复问题并撰写可直接使用的文档,适合需要持续推进的日常智能体流程。
- 处理功能开发与错误修复
- 完成多步骤工具调用
- 生成清晰实用的专业文档
更快的编程与智能体执行、自适应思考、100 万 Token 上下文与视觉理解
Claude Sonnet 5.5 是 Anthropic 面向范围明确的软件开发和多步骤专业工作的 Sonnet 模型。它可辅助功能开发、错误修复、工具调用与文档制作;Anthropic 报告其输出速度比 Sonnet 5 快 30% 以上。
100 万 Token 上下文窗口便于关联大型代码库与长文档,自适应思考让开发者按任务调整 effort。模型也能理解图表和截图,适合需要同时处理代码、文字与界面的智能体工作流。
从编程、推理、速度与多模态能力了解 Claude Sonnet 5.5。
01
Claude Sonnet 5.5 适合范围明确的开发任务与多步骤专业工作。Anthropic 公布的 Terminal-Bench 4.0 成绩为 70.6%,同一评测中的 Sonnet 5 为 10.3%。它可以理解代码、调用工具、修复问题并撰写可直接使用的文档,适合需要持续推进的日常智能体流程。
02
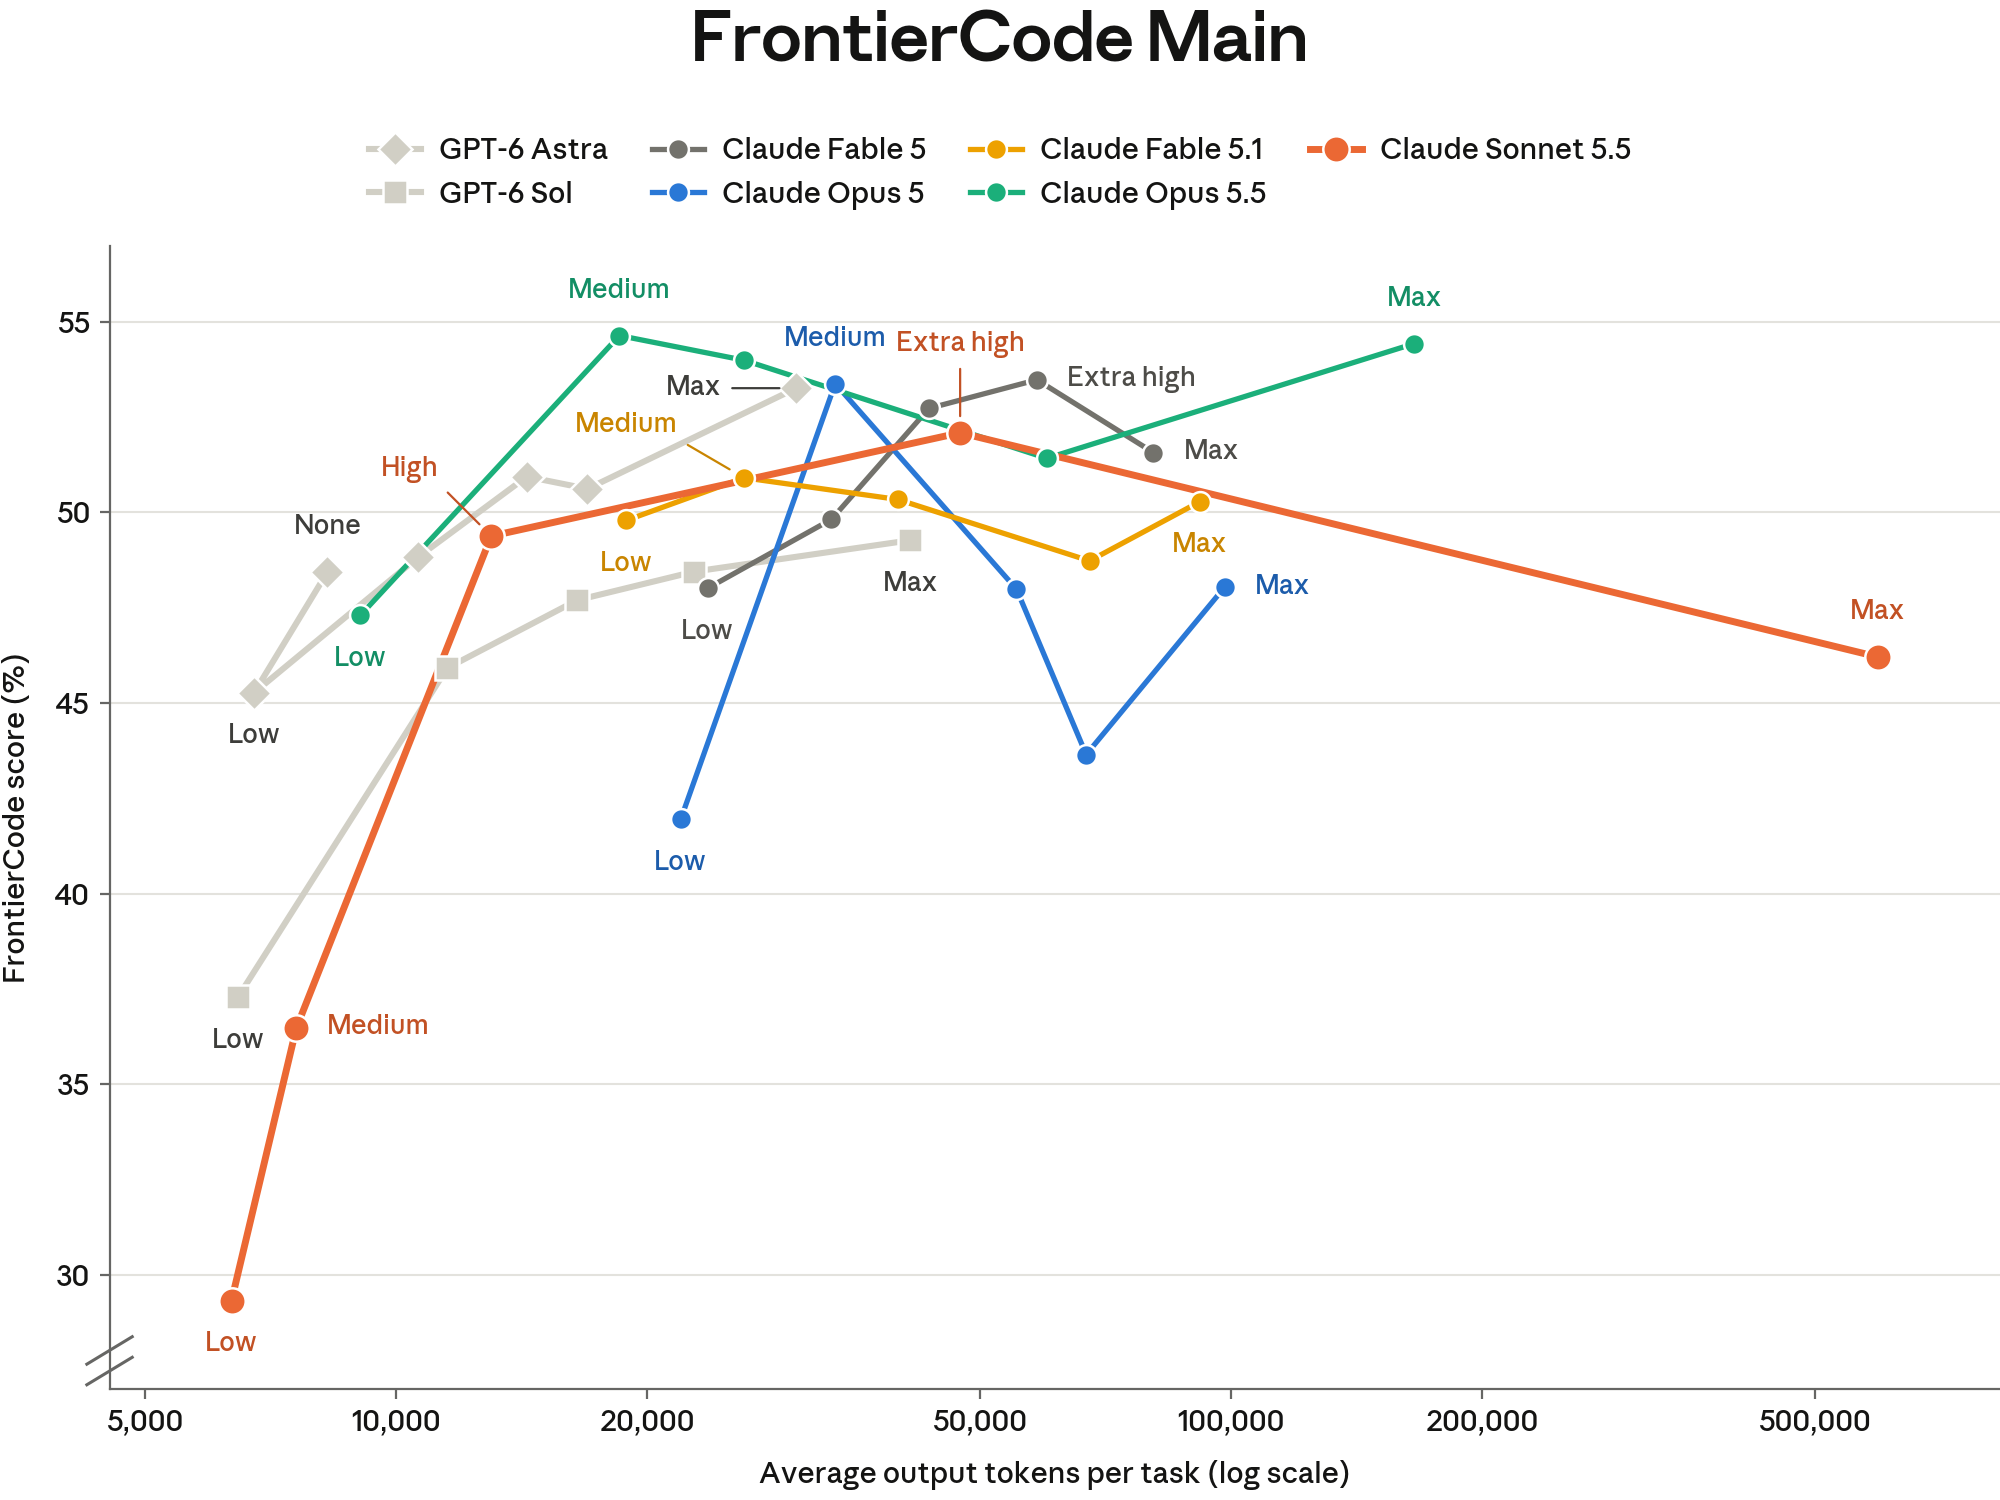
自适应思考使 Sonnet 5.5 能根据任务调整推理投入。开发者可通过 effort 参数在回答质量、响应时间和 Token 消耗之间取舍,不必为每次请求指定固定的思考预算。Anthropic 在 Claude 应用中默认使用 Medium,在 Claude Platform 中默认使用 High;正式应用应按目标强度评估效果。
03
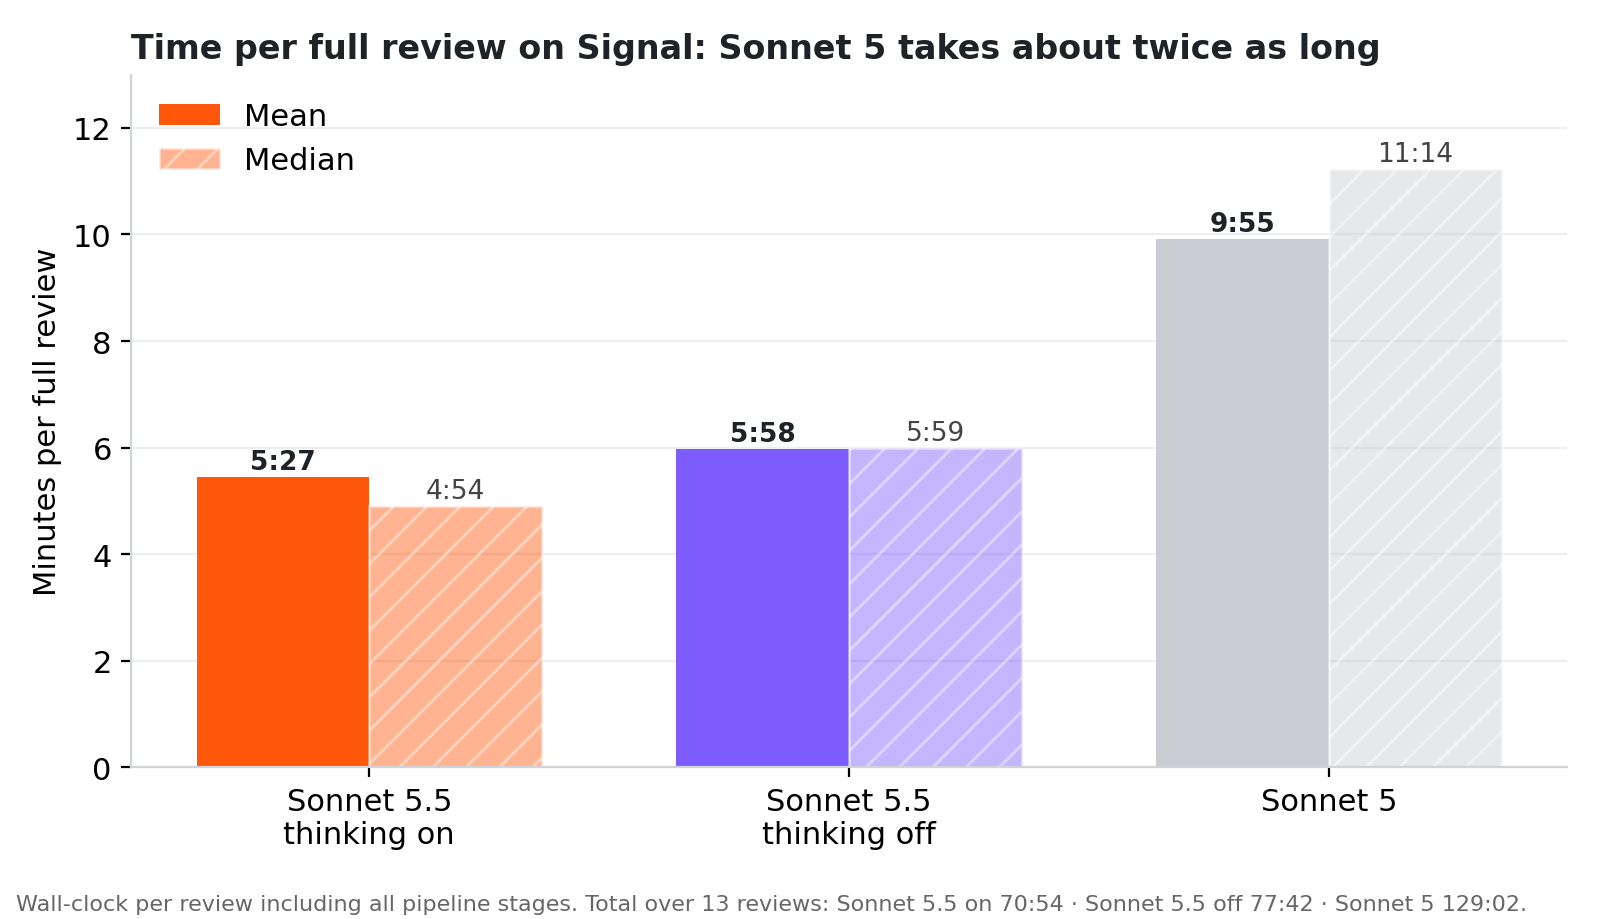
Anthropic 报告 Sonnet 5.5 的输出速度比 Sonnet 5 快 30% 以上。在直接对比的编程测试中,它更善于批量调用工具,也能用更少的步骤推进任务。另据 CodeRabbit 的 13 项代码审查测试,Sonnet 5.5 完成一次完整审查平均用时 5 分 27 秒,Sonnet 5 为 9 分 55 秒;右图展示的是这项工作流测试结果。
04
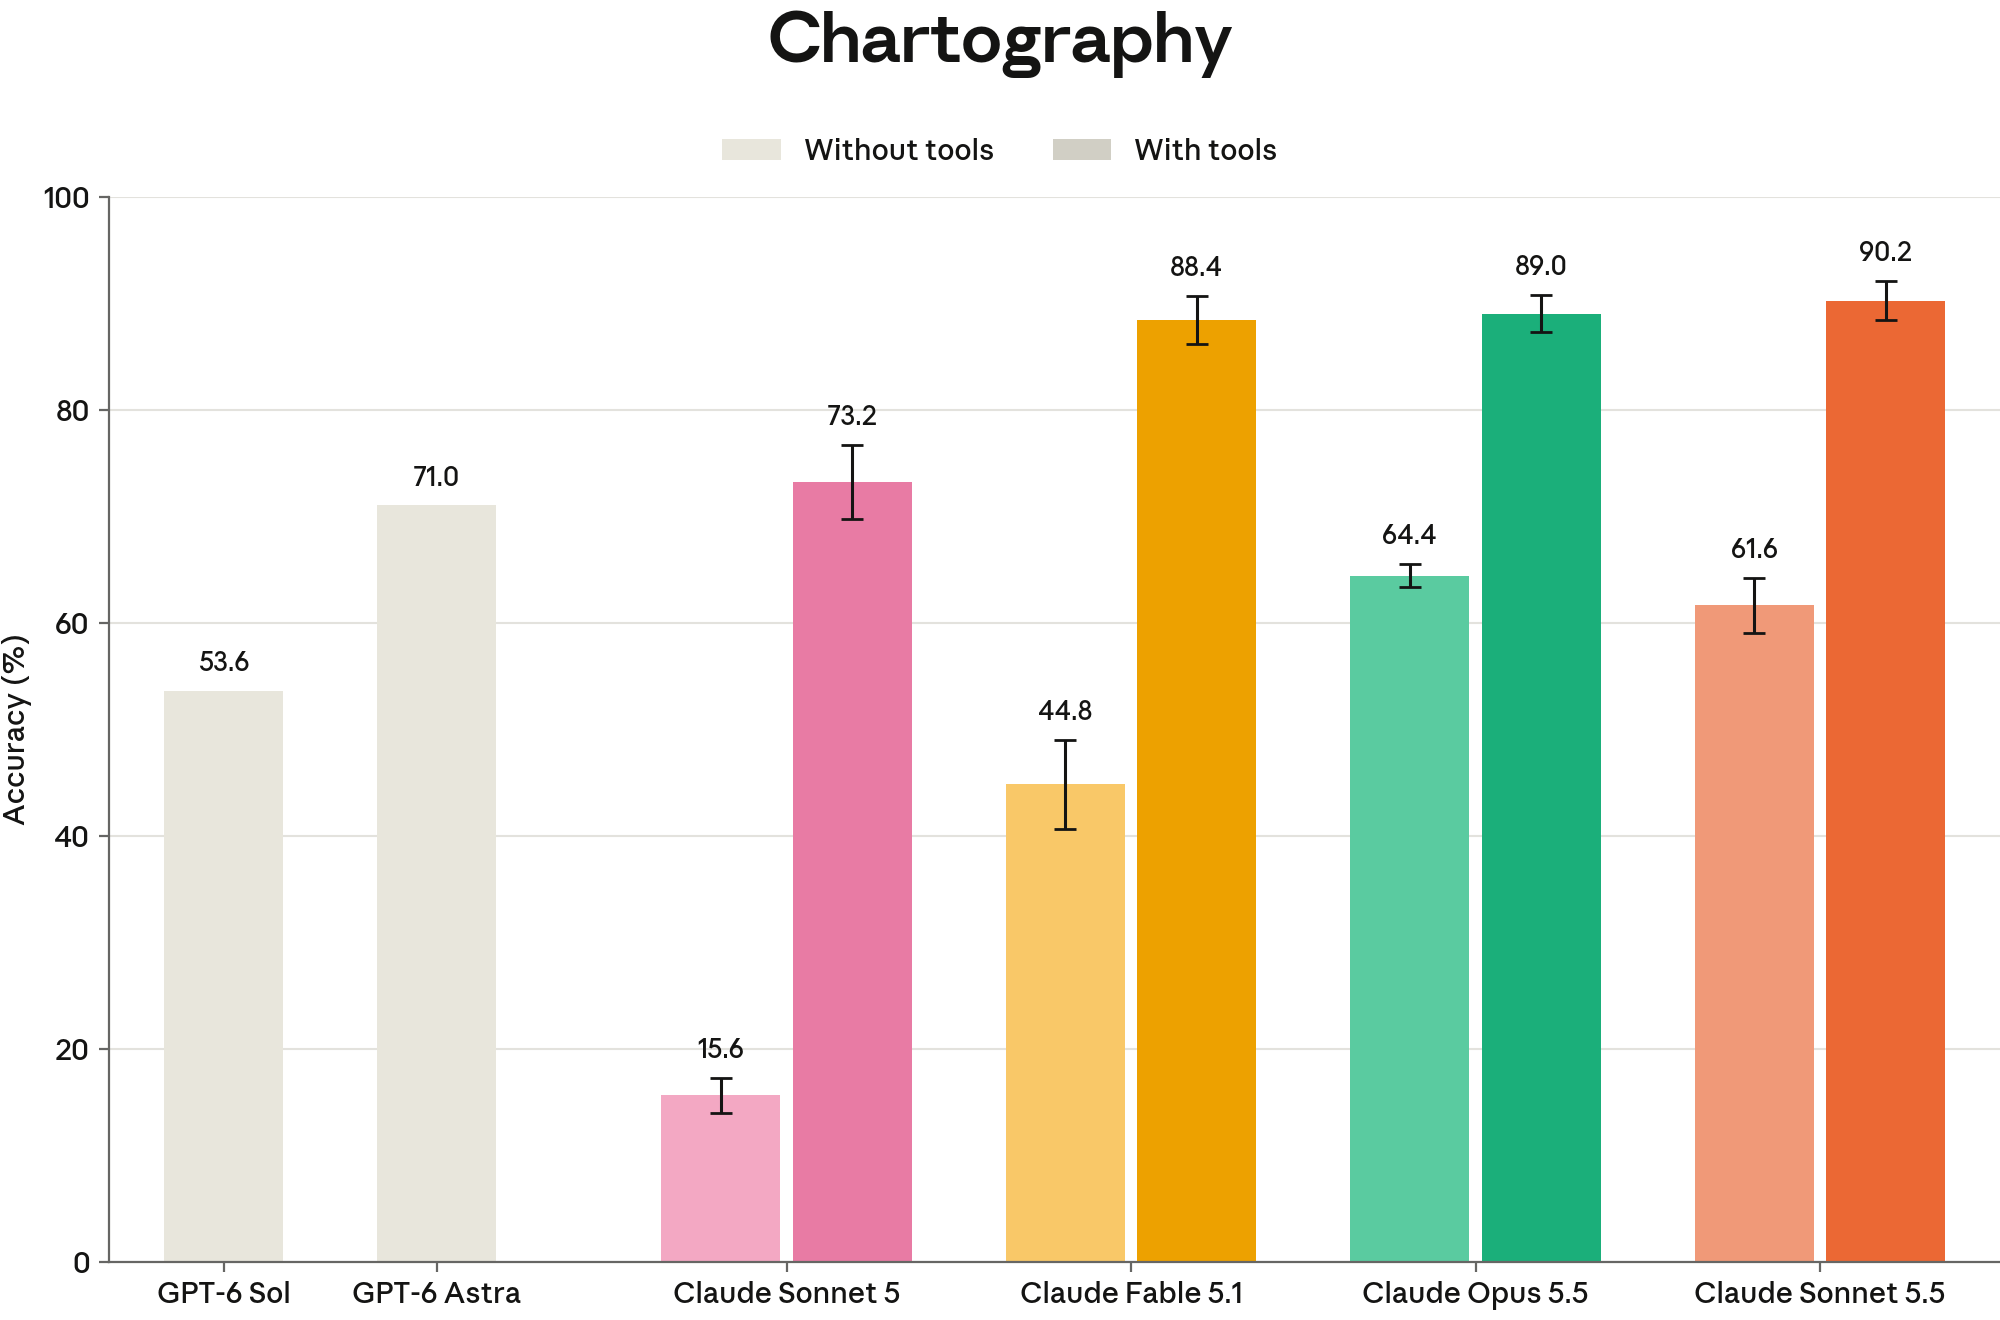
Sonnet 5.5 能理解图表、截图等图像输入,用于视觉分析和计算机使用任务。在 Anthropic 的 Chartography 评测中,它不使用工具时得到 61.6%,Sonnet 5 为 15.6%。它的 100 万 Token 上下文窗口也支持处理大型代码库、长文档和持续对话。
使用 Claude Sonnet 5.5 理解代码库、实现范围明确的功能、排查故障,并在多步骤开发流程中检查修改。
构建能够规划、调用工具、检查结果并完成日常任务的智能体,同时按质量与响应时间需求调整 effort。
分析长篇原始资料、汇总证据并撰写清晰的报告或简报,同时保留理解关键细节所需的上下文。
结合图表与书面报告解释数据模式、整理依据,并把视觉和文字资料放在同一流程中处理。
根据需求和视觉参考整理文案、演示文稿初稿与界面反馈,便于团队快速审阅和迭代。
制作表格、幻灯片和可重复使用的知识工作成果,并通过工具调用核对中间结果。
Anthropic 将 Sonnet 5.5 定位为 Sonnet 5 的升级版本,更适合日常专业任务与智能体工作。下表数据来自 Anthropic 公布的评测。
| 对比维度 | Claude Sonnet 5.5 | Claude Sonnet 5 |
|---|---|---|
| 输出速度 | 快 30% 以上 | 基准版本 |
| Terminal-Bench 4.0 | 70.6% | 10.3% |
| 上下文窗口 | 100 万 Token | 100 万 Token |
| CursorBench 4.0 | 55.5% | 34.1% |
| Chartography(不使用工具) | 61.6% | 15.6% |
| GDPval-AA v2.1 | 1844 Elo | 1449 Elo |
来源:Anthropic 的 Claude Sonnet 5.5 发布说明。评测成绩受测试设置、effort 和具体工作负载影响。
汇总编程、智能体、自适应思考、视觉与 100 万 Token 上下文,帮助团队判断模型适合哪些任务。
根据已公布的速度、编程、视觉与知识工作评测,对比两代 Sonnet 模型的差异。
把 Sonnet 5.5 放进 PoYo 的对话模型目录,比较日常编程与长流程智能体等任务的适配性。
梳理 effort、上下文、图像输入和工具使用需求,为产品集成做好技术选择。