
Gemini 4 Argon (gemini-4-argon) von Google DeepMind ist ab sofort über die PoYo API verfügbar. Das Modell wurde am 30. September 2026 zunächst im Rahmen des Fairwind-Programms für Cybersicherheitsteams vorgestellt und im Oktober 2026 weltweit ausgerollt. Als Sparse-Mixture-of-Experts-(MoE)-Frontier-Modell ist Argon auf komplexe, mehrstufige Workflows in der Softwareentwicklung, Finanz- und Rechtsanalyse, wissenschaftlichen Forschung sowie der defensiven Cybersicherheit ausgelegt.
Die wichtigste architektonische Neuerung für Entwickler ist das branchenweit erste vereinheitlichte Ein- und Ausgabe-Limit von 1.000.000 Tokens – die maximale Ausgabelänge steigt damit von 64.000 auf bis zu 1.000.000 Tokens in einem einzigen Durchlauf. Über PoYo rufen Sie gemini-4-argon für $1.60 pro 1M Input-Tokens, $8.00 pro 1M Output-Tokens und $0.16 pro 1M Cache-Read-Tokens auf – 20 % günstiger als die offiziellen Standardpreise von Google ($2.00 / $10.00 / $0.20).
Technische Spezifikationen im Überblick
| Spezifikation | Gemini 4 Argon (gemini-4-argon) |
|---|---|
| Anbieter & Architektur | Google DeepMind · Sparse Mixture-of-Experts (MoE) Transformer |
| PoYo API Modell-ID | gemini-4-argon |
| Vereinheitlichtes Kontextfenster | 1.000.000 Tokens (Input + Output kombiniert) |
| Maximale Output-Tokens | Bis zu 1.000.000 Tokens (zuvor 64K bei Gemini 3.x) |
| Native Eingabemodalitäten | Text, Bilder, Audio, Video und PDF-Dokumente |
| Ausgabemodalität | Text (einschließlich Reasoning-/Thinking-Tokens und strukturiertem Code) |
| Wissensstand (Knowledge Cutoff) | März 2026 |
| Unterstützte PoYo-Endpunkte | POST /v1/chat/completions (OpenAI-kompatibel)POST /v1beta/models/gemini-4-argon:generateContent & :streamGenerateContent (Gemini Native) |
Gemini 4 Argon API-Preise: Google Offiziell vs. PoYo
Google bietet Gemini 4 Argon zum Start für $2.00 pro 1M Input-Tokens und $10.00 pro 1M Output-Tokens an (ab dem 30. November 2026 soll der reguläre Tarif auf $4.00 / $20.00 steigen). PoYo gibt über das Pay-as-you-go-Kreditsystem (200 Credits = $1.00 USD) dauerhaft 20 % Rabatt auf alle Token-Arten weiter:
| Token-Art | Google Offizieller Standard | PoYo API-Preis (USD) | PoYo Credits / 1M Tokens | Ersparnis |
|---|---|---|---|---|
| Input-Tokens | $2.00 / 1M | $1.60 / 1M | 320 Credits | 20 % Rabatt |
| Output-Tokens (inkl. Thinking) | $10.00 / 1M | $8.00 / 1M | 1.600 Credits | 20 % Rabatt |
| Cache-Read-Tokens | $0.20 / 1M | $0.16 / 1M | 32 Credits | 20 % Rabatt |
Kostenbeispiele für reale Produktions-Workloads
Da Gemini 4 Argon über 100.000 Thinking- und Output-Tokens in einer einzigen Antwort erzeugen kann, machen Output-Tokens den Großteil der Gesamtkosten aus:
- Multi-File-Repository-Refactoring (150K Input + 50K Output inkl. Thinking):
- Google Standard:
0.15 × $2.00 + 0.05 × $10.00= $0.80 pro Lauf - PoYo API:
0.15 × $1.60 + 0.05 × $8.00= $0.64 pro Lauf (128 Credits)
- Google Standard:
- Finanz-/Rechts-Due-Diligence mit gecachtem Korpus (400K Cache-Read + 50K neuer Input + 25K Output):
- Google Standard:
0.40 × $0.20 + 0.05 × $2.00 + 0.025 × $10.00= $0.43 pro Lauf - PoYo API:
0.40 × $0.16 + 0.05 × $1.60 + 0.025 × $8.00= $0.344 pro Lauf (68,8 Credits)
- Google Standard:
- Agenten-Workflow im Dauerbetrieb (10M Input + 3M Output monatlich):
- Google Standard: $50.00 / Monat
- PoYo API: $40.00 / Monat (8.000 Credits)
Um gemini-4-argon direkt im Browser zu testen, besuchen Sie die Gemini 4 Argon Modellseite auf PoYo.
Benchmarks: Gemini 4 Argon vs. GPT-6 Astra vs. Claude Opus 5.5
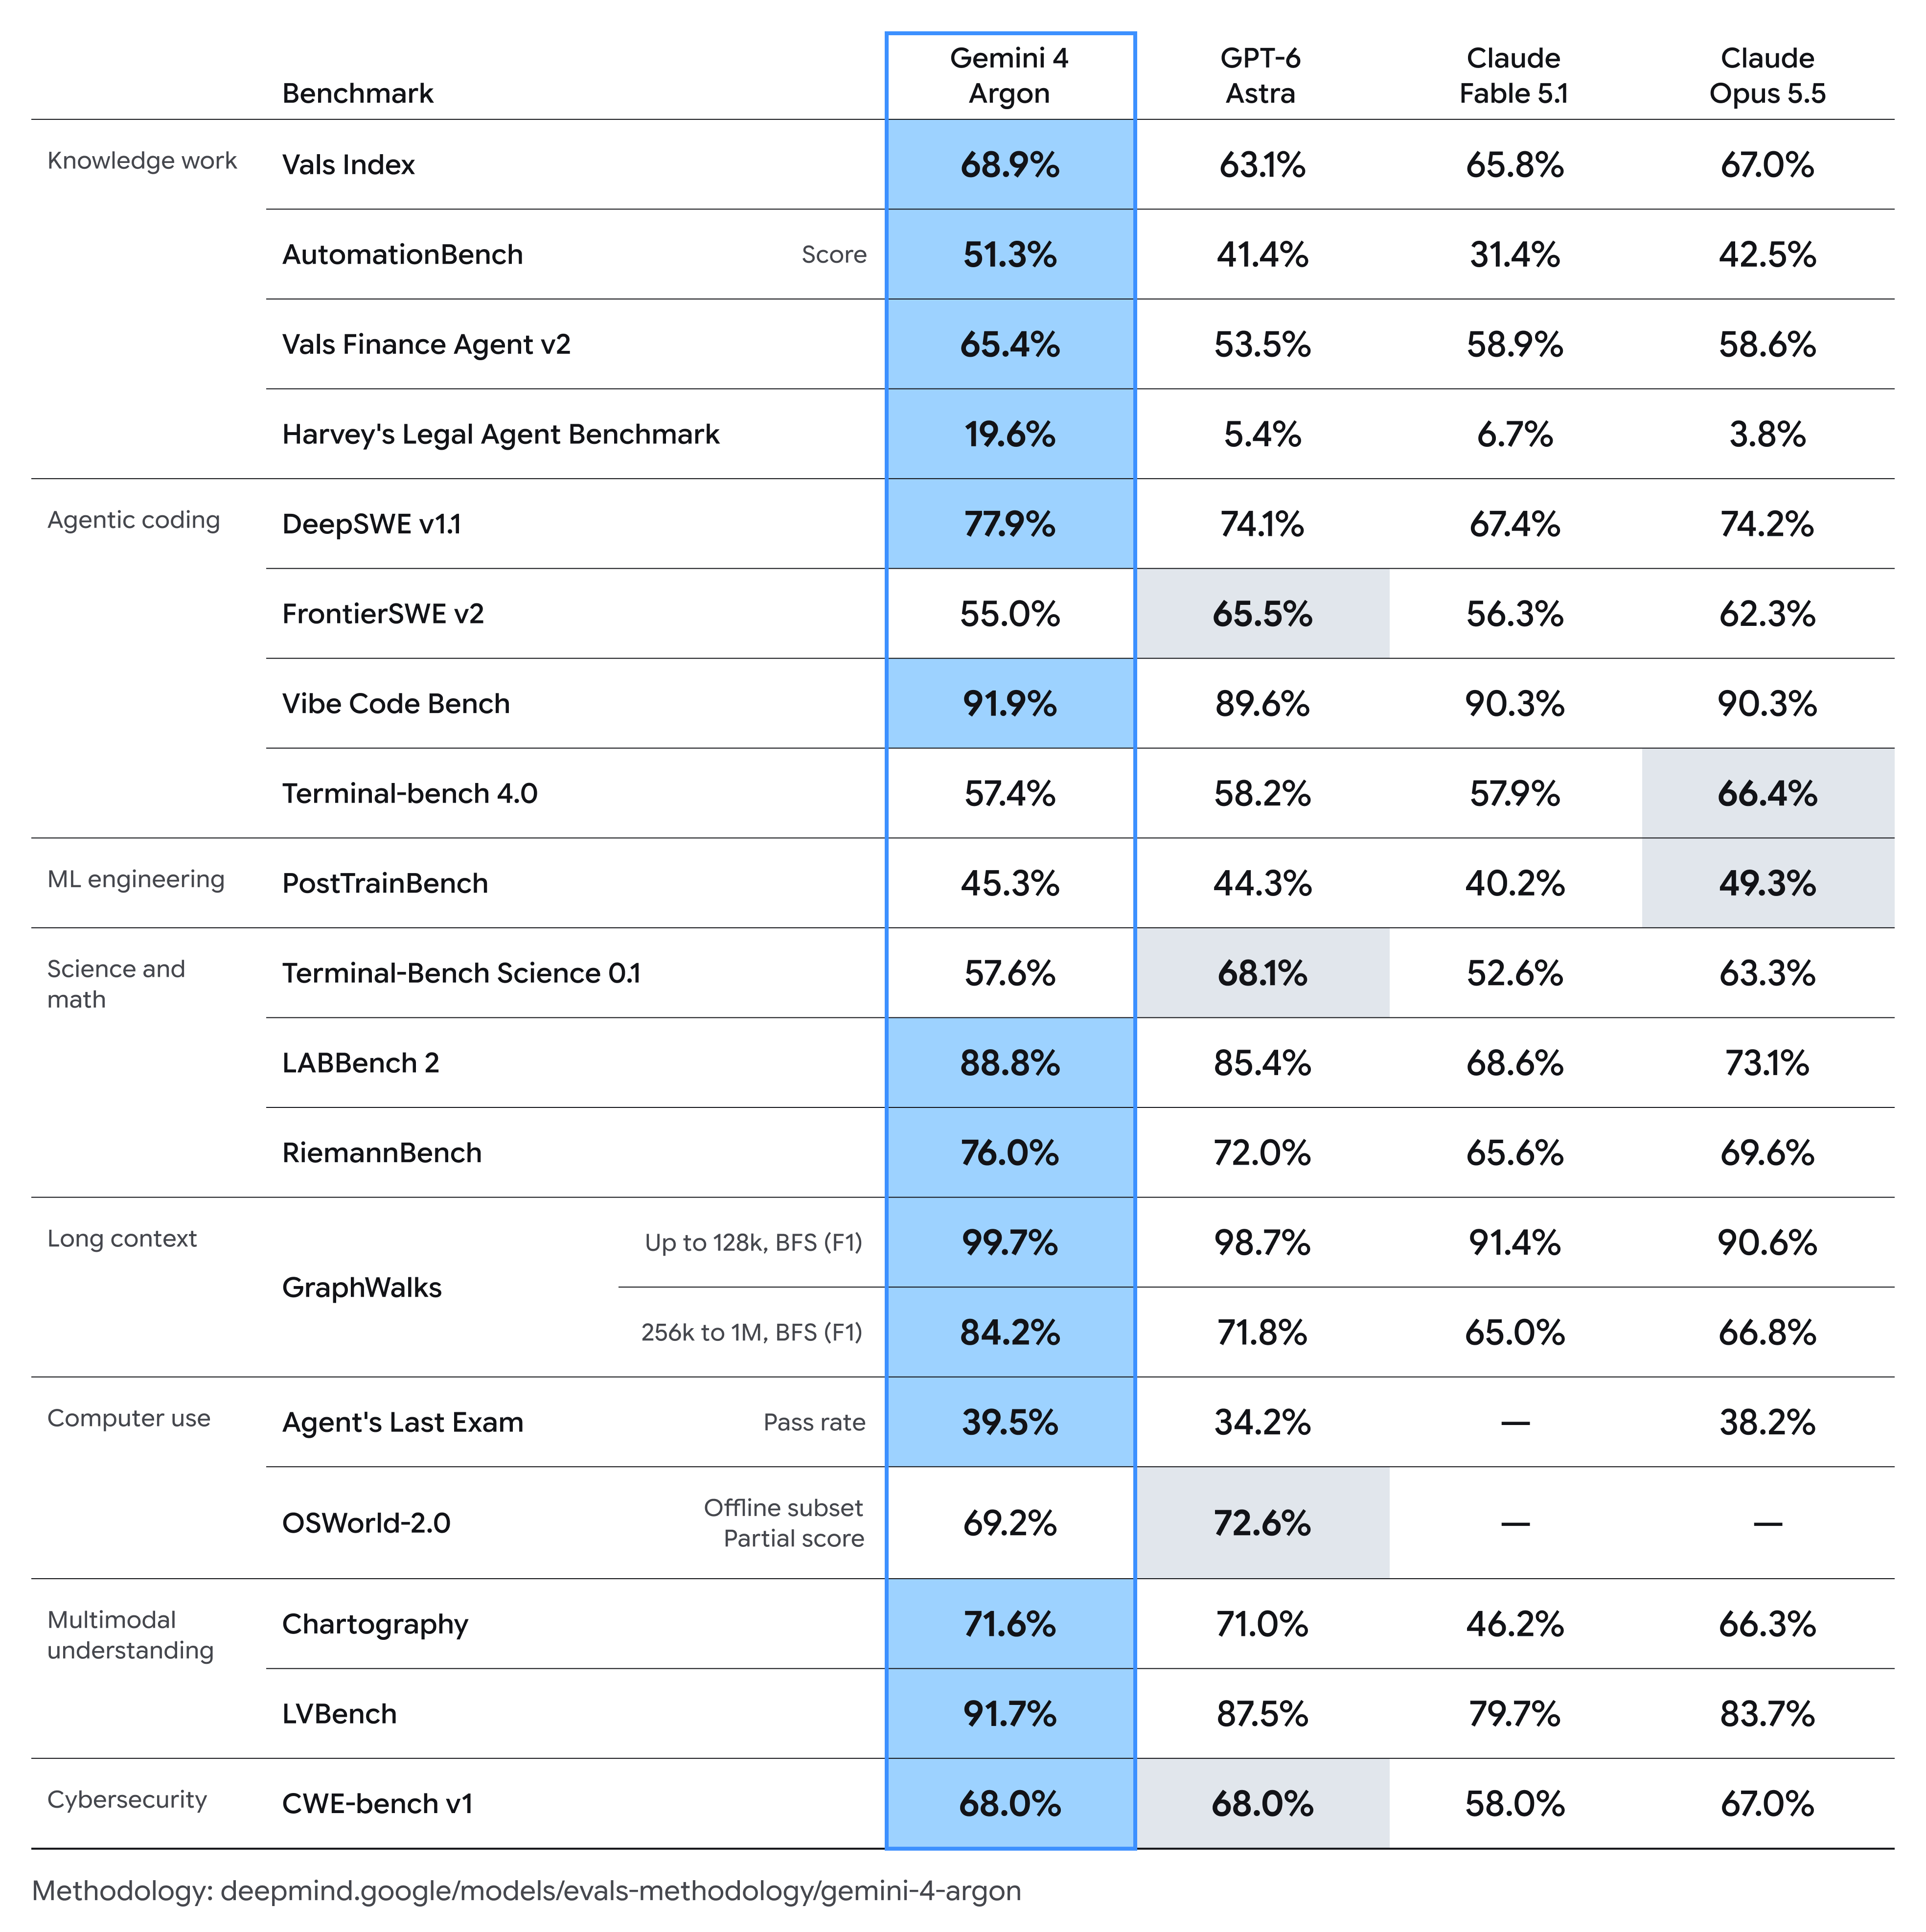
Laut der offiziellen Google DeepMind Model Card (Oktober 2026) belegt Gemini 4 Argon bei 13 von 18 veröffentlichten Benchmarks Platz 1 und teilt sich bei einem weiteren den Spitzenplatz im Vergleich zu GPT-6 Astra, Claude Opus 5.5 und Claude Fable 5.1:
| Kategorie | Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|
| Wissensarbeit | Vals Index (BIP-gewichtet) | 68.9% | 63.1% | 67.0% | 65.8% |
| AutomationBench (Zapier) | 51.3% | 41.4% | 42.5% | 31.4% | |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% | 58.9% | |
| Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 3.8% | 6.7% | |
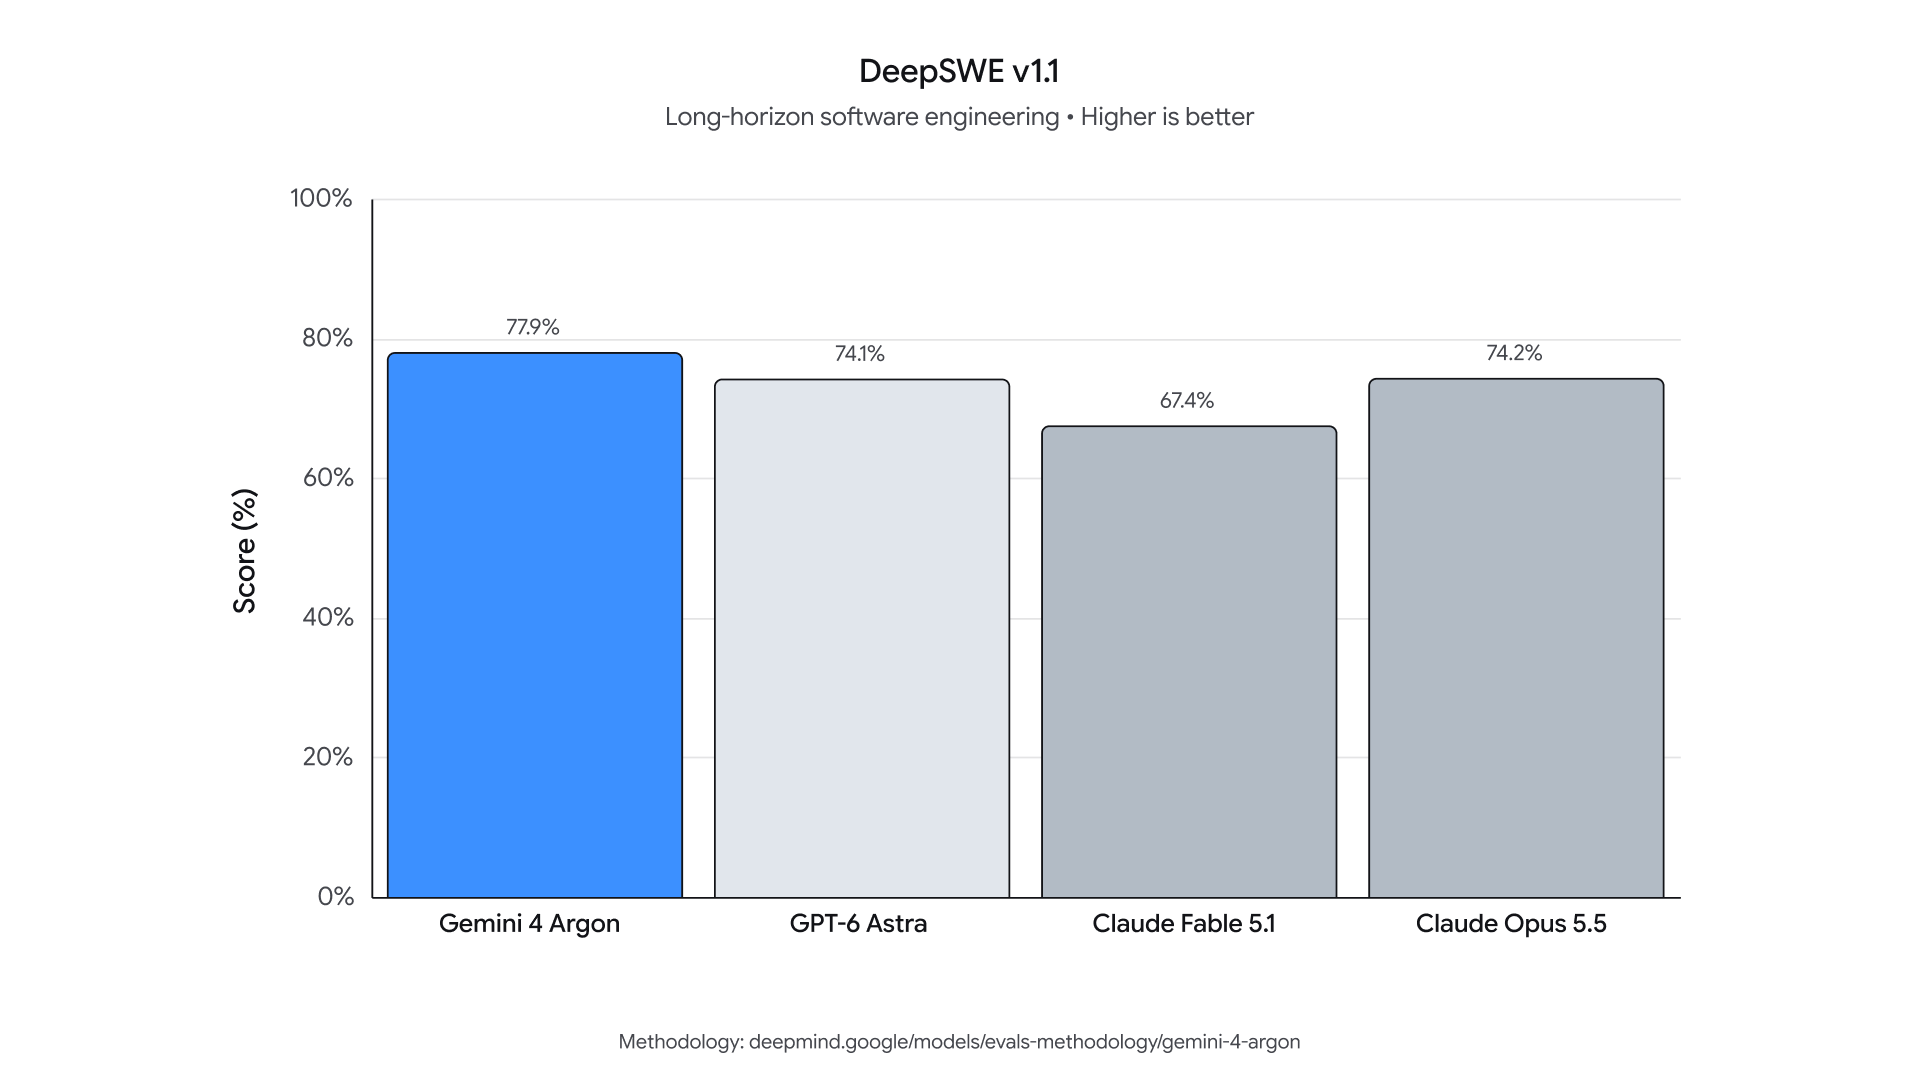
| Agentic Coding | DeepSWE v1.1 | 77.9% | 74.1% | 74.2% | 67.4% |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% | 56.3% | |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 66.4% | 57.9% | |
| ML Engineering | PostTrainBench | 45.3% | 44.3% | 49.3% | 40.2% |
| Wissenschaft & Mathe | LABBench 2 | 88.8% | 85.4% | 73.1% | 68.6% |
| RiemannBench | 76.0% | 72.0% | 69.6% | 65.6% | |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 63.3% | 52.6% | |
| Langer Kontext | GraphWalks (≤128K, BFS F1) | 99.7% | 98.7% | 90.6% | 91.4% |
| GraphWalks (256K–1M, BFS F1) | 84.2% | 71.8% | 66.8% | 65.0% | |
| Computernutzung | Agent's Last Exam (Pass Rate) | 39.5% | 34.2% | 38.2% | — |
| OSWorld-2.0 (Offline-Teilmenge) | 69.2% | 72.6% | — | — | |
| Multimodal | LVBench (Lange Videos) | 91.7% | 87.5% | 83.7% | 79.7% |
| Chartography | 71.6% | 71.0% | 66.3% | 46.2% | |
| Cybersicherheit | CWE-bench v1 | 68.0% | 68.0% | 67.0% | 58.0% |
Empfehlungen für das Modell-Routing
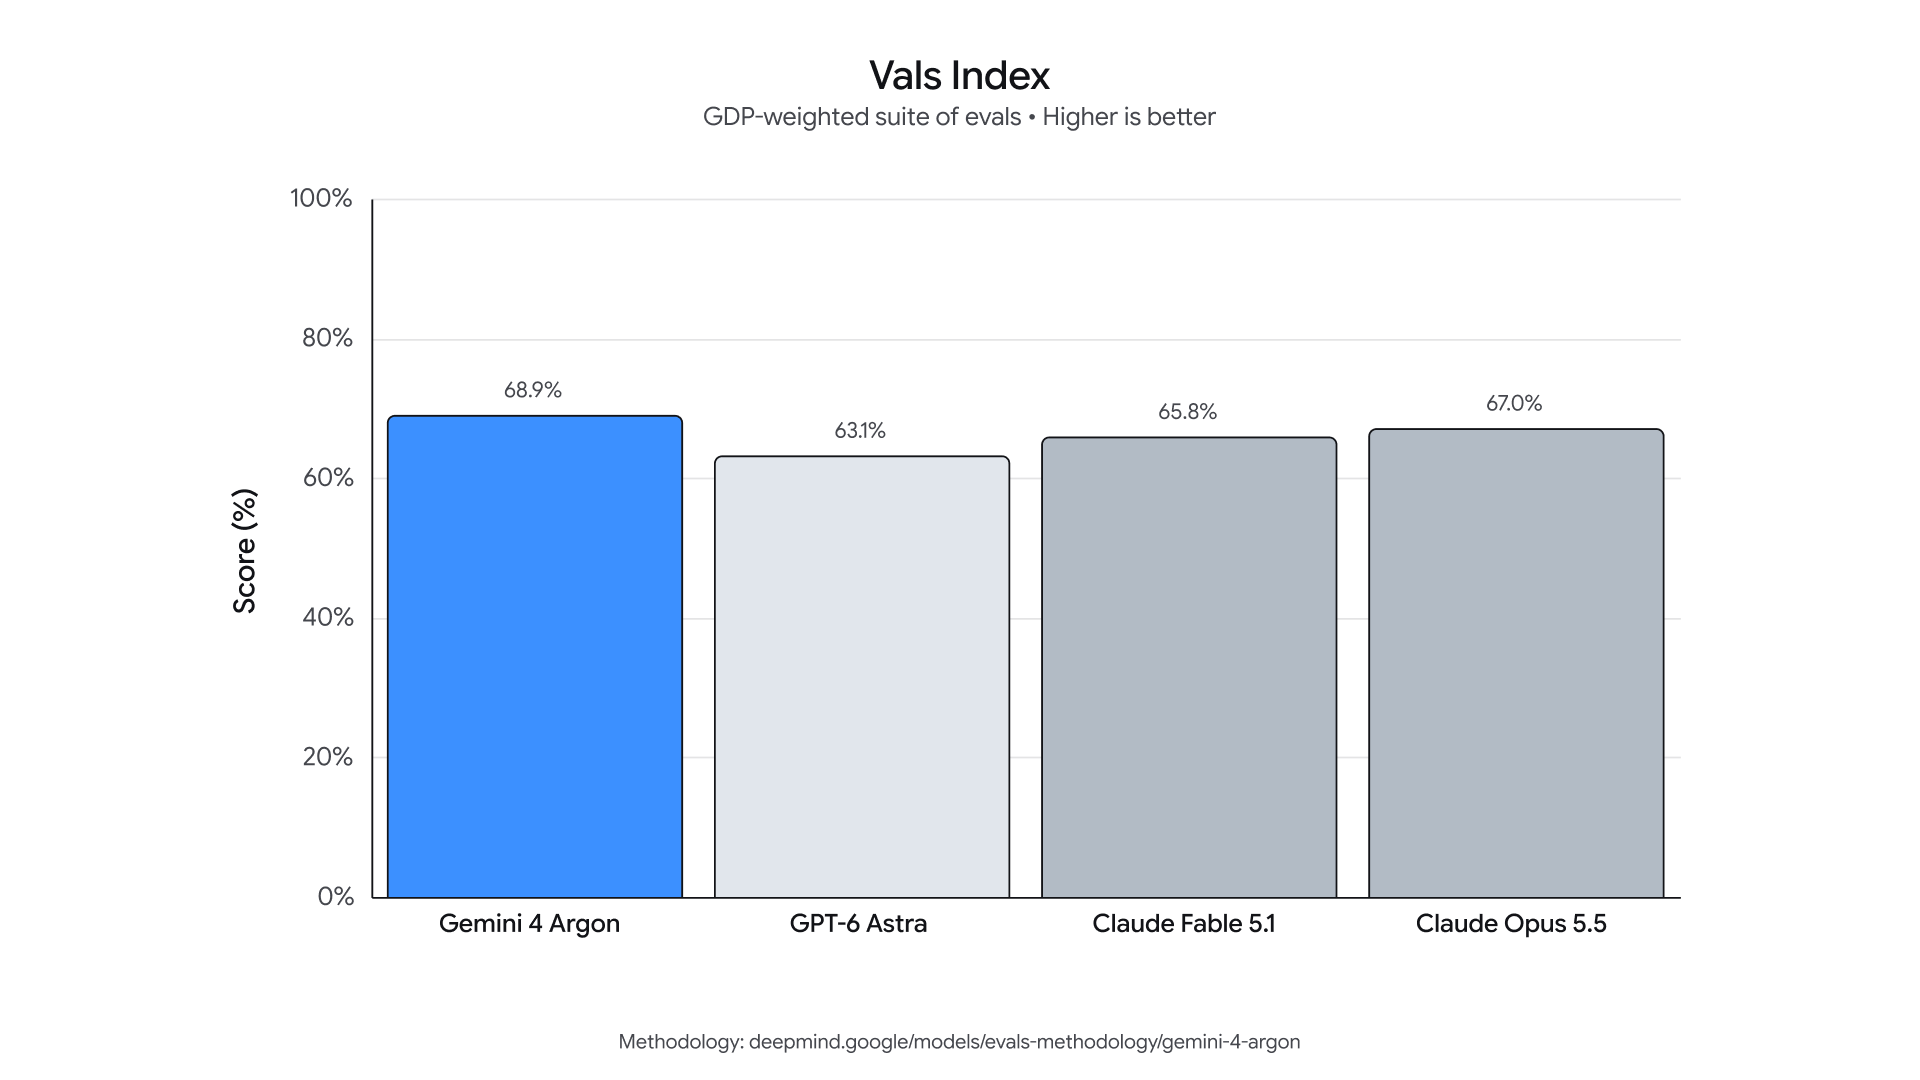
- Wo Gemini 4 Argon klar führt: Langfristiges Repository-Refactoring (DeepSWE v1.1: 77.9%), Ultra-Long-Context-Reasoning zwischen 256K und 1M Tokens (GraphWalks: 84.2% gegenüber 66.8% bei Opus 5.5), End-to-End-Prozessautomatisierung (AutomationBench: 51.3%), juristische und finanzielle Analysen (Harvey: 19.6%, Vals Finance: 65.4%) sowie Langvideo-Verständnis (LVBench: 91.7%).
- Wann Claude Opus 5.5 oder GPT-6 Astra sinnvoll sind: Bei interaktiven Terminal-Aufgaben (Terminal-Bench 4.0, wo Claude Opus 5.5 mit 66.4% führt) sowie spezialisierten SWE-/Wissenschafts-Umgebungen (FrontierSWE v2 und Terminal-Bench Science 0.1, angeführt von GPT-6 Astra).
- Preis-Leistungs-Vorteil: Mit $1.60 / $8.00 auf PoYo kostet Gemini 4 Argon 50 % weniger pro Token als Claude Opus 5.5 ($3.20 / $16.00) und 80 % weniger als GPT-6 Astra ($8.00 / $40.00) – auf dem Preisniveau von GPT-6.1 Sol und Claude Sonnet 5.5.
Drei entscheidende Produktionsvorteile von Gemini 4 Argon
1. Vereinheitlichtes 1M-Token-Fenster ohne abgeschnittene Antworten
Frühere Gemini-Modelle begrenzten die Ausgabe auf 64K Tokens. Durch die Zusammenführung des 1M-Token-Pools für Eingabe und Ausgabe kann Argon über 100.000 Tokens für internes Chain-of-Thought-Reasoning nutzen und dennoch vollständige Multi-File-Migrationen in einem Durchgang ausgeben. Google-Ingenieure nutzten Argon unter anderem, um 6 Millionen Zeilen Legacy-Code aus dem 40 Millionen Zeilen umfassenden Chromium-Repository zu entkoppeln und 32.000 Zeilen SIMD-Videodecoder-Code (libgav1) in sicheres Rust zu portieren (2,7-mal schneller als die vorherige Portierung).
2. Defensive Cybersicherheit & Schutz vor Prompt Injection
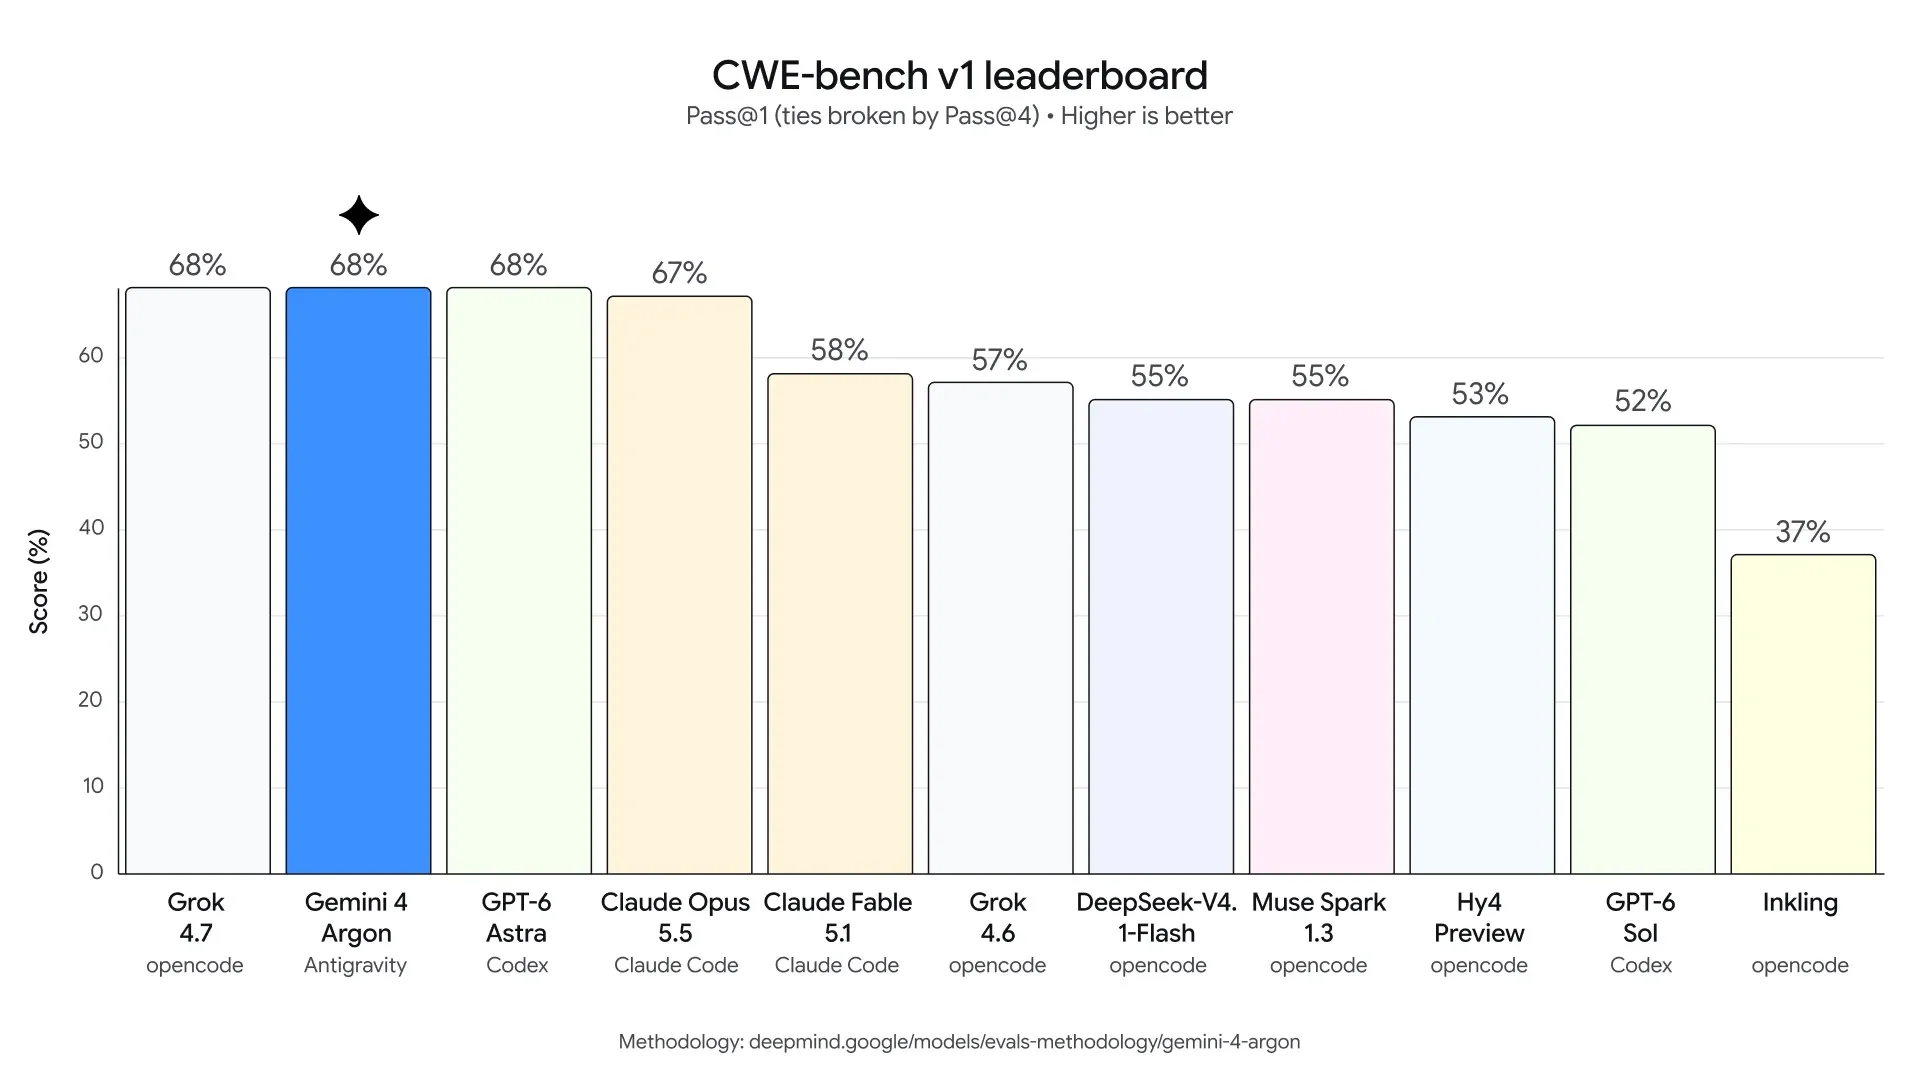
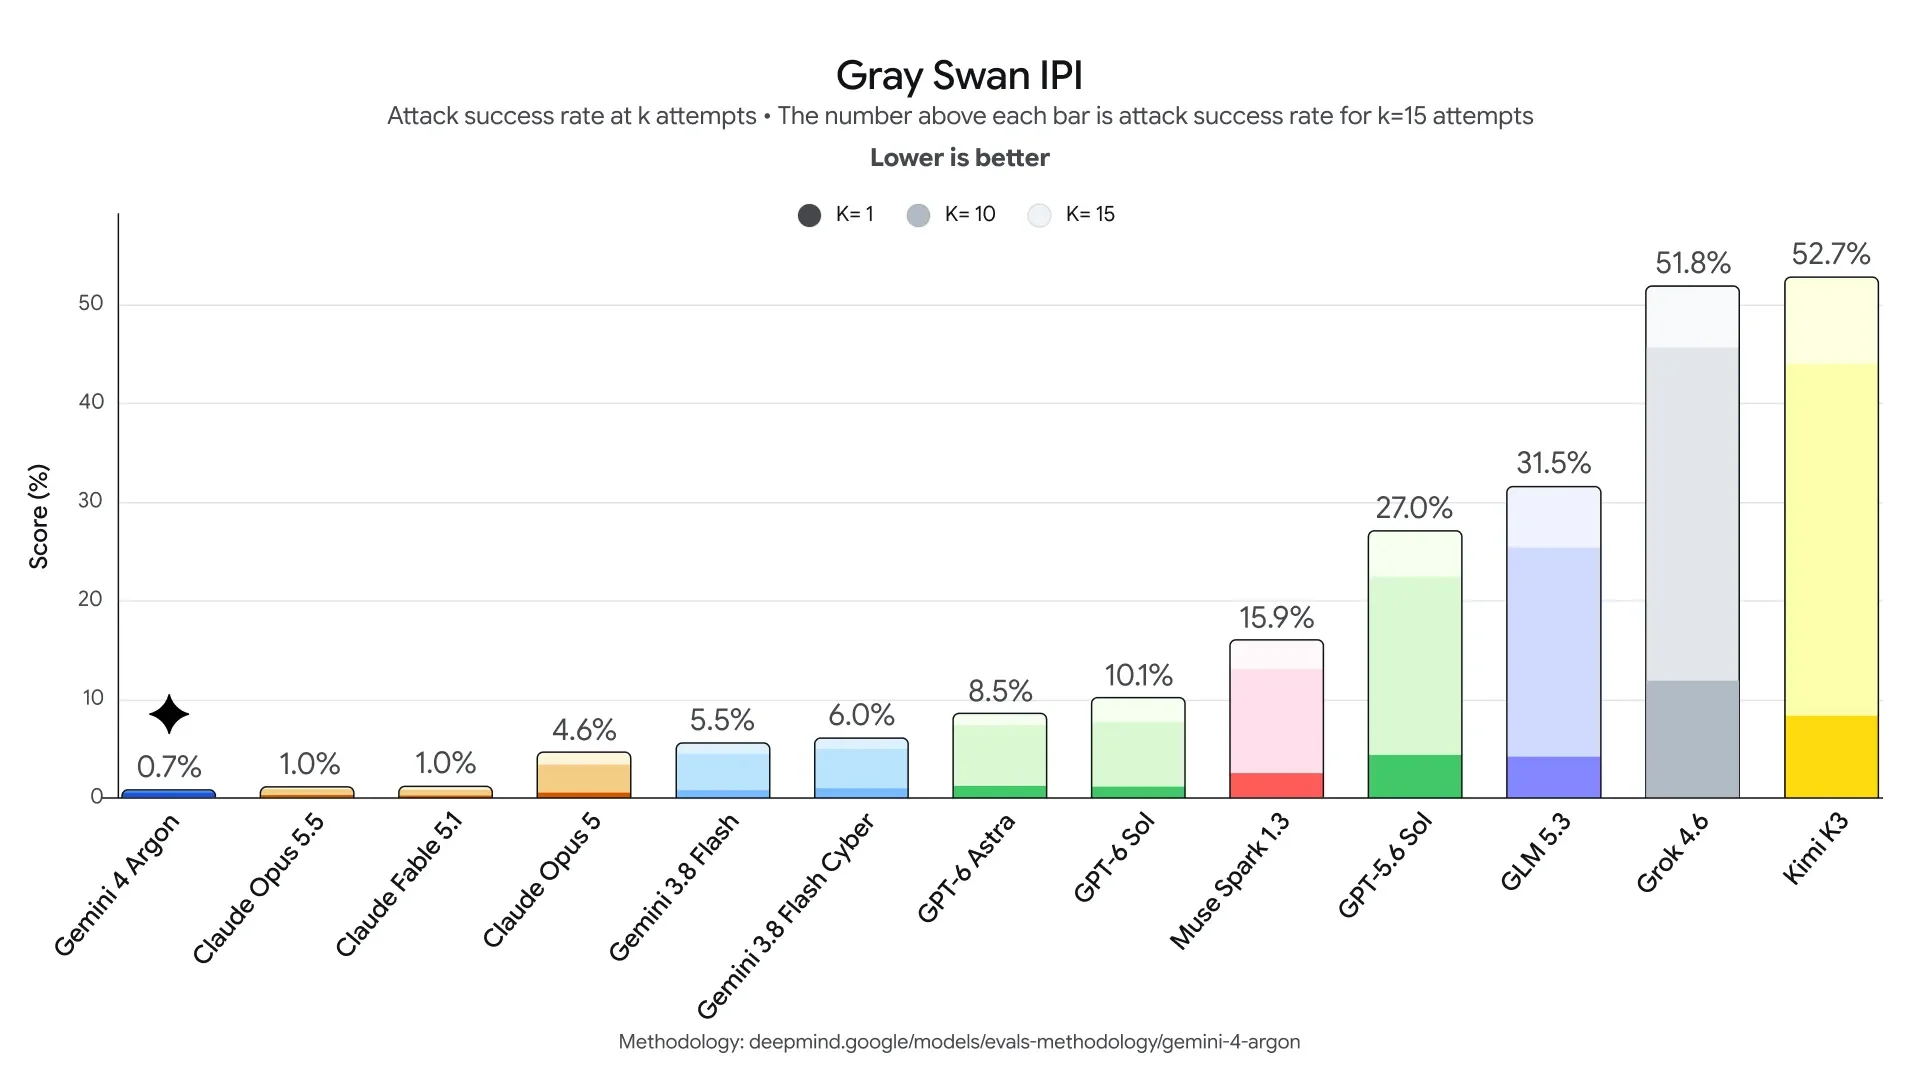
Argon erreicht 68.0% auf CWE-bench v1 (geteilter Platz 1) für automatisierte Sicherheits-Patches. Für Agenten, die externe Webseiten oder PDFs verarbeiten, senkt Argon die Erfolgsrate indirekter Prompt-Injection-Angriffe auf dem Gray Swan IPI-Benchmark auf nur 0.7% über 15 adaptive Versuche hinweg.
3. Native Multimodalität, 3D-Raumverständnis & Wissenschaft
Argon verarbeitet nativ Text, Bilder, Audio, lange Videos und PDFs, erreicht 87% beim Embodied Reasoning (ERQA) sowie 91.7% auf LVBench und beschleunigt Quantenchemie-Berechnungen (xTB) um das 2,3-Fache.
Integration der Gemini 4 Argon API über PoYo
PoYo unterstützt sowohl OpenAI Chat Completions (/v1/chat/completions) als auch das Google Gemini Native Format (/v1beta/models/gemini-4-argon:generateContent und :streamGenerateContent) mit demselben API-Schlüssel.
Option 1: OpenAI-kompatible Chat Completions (POST /v1/chat/completions)
curl --request POST \
  --url https://api.poyo.ai/v1/chat/completions \
  --header "Authorization: Bearer YOUR_POYO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "gemini-4-argon",
    "messages": [
      {
        "role": "system",
        "content": "You are a principal systems architect and security auditor."
      },
      {
        "role": "user",
        "content": "Design a memory-safe Rust migration plan for a C++ video frame ring buffer, including zero-copy slices and unit tests."
      }
    ],
    "temperature": 1.0,
    "max_tokens": 16384,
    "stream": false
  }'
Option 2: Google Gemini Native Format (:generateContent & :streamGenerateContent)
curl --request POST \
  --url "https://api.poyo.ai/v1beta/models/gemini-4-argon:generateContent" \
  --header "Authorization: Bearer YOUR_POYO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "systemInstruction": {
      "parts": [
        { "text": "Provide rigorous financial and legal analysis with explicit citations." }
      ]
    },
    "contents": [
      {
        "role": "user",
        "parts": [
          { "text": "Compare the working capital adjustments and indemnification caps across these merger agreement clauses." }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "maxOutputTokens": 32768,
      "topP": 0.95
    }
  }'
Für Streaming im nativen Gemini-Format ersetzen Sie :generateContent durch :streamGenerateContent?alt=sse.
Häufig gestellte Fragen (FAQ)
Wie lautet die genaue Modell-ID für Gemini 4 Argon auf PoYo?
Verwenden Sie gemini-4-argon sowohl für /v1/chat/completions als auch für /v1beta/models/gemini-4-argon:generateContent.
Werden Thinking-Tokens separat abgerechnet?
Gemäß Googles Abrechnungsmodell zählen interne Reasoning-Tokens (Thinking) zu den Output-Tokens und werden auf PoYo mit $8.00 pro 1M Tokens (1.600 Credits) berechnet.
Wie kann ich starten?
Erstellen Sie Ihren API-Schlüssel im PoYo Dashboard, testen Sie Prompts im Gemini 4 Argon Playground oder entdecken Sie weitere Modelle im PoYo AI Chat API Katalog.