
À retenir
- Fable 5.2 convient aux tâches les plus difficiles ; GPT-6.1 Sol, aux tâches à grand volume. Sur l’Artificial Analysis Intelligence Index, Fable 5.2 obtient 65 et GPT-6.1 Sol 55 en effort maximal, et Sol accomplit chaque tâche de l’index pour une fraction du coût.
- Prix officiels au token : $8 / $40 par million de tokens en entrée/sortie pour Fable 5.2 et $2 / $10 pour Sol en contexte court, soit un écart de 4×.
- Un tarif unique sur PoYo. Au-delà de 272K tokens d’entrée, OpenAI facture toute la requête Sol à $4 / $15. Sur PoYo, GPT-6.1 Sol coûte $1.60 / $8 sur toute sa fenêtre de contexte, et Fable 5.2 $6.40 / $32 sur toute sa fenêtre de 1M tokens.
- Fable 5.2 consacre davantage de raisonnement à chaque tâche. Artificial Analysis a mesuré $26.54 par tâche de l’index pour Fable 5.2 en effort maximal, contre $1.27 pour Sol.
- Fable 5.2 atteint vite de bons scores. En effort
low, il obtient 54, tout près des 55 de Sol enmax, et termine une tâche de l’index en 5.8 minutes contre 23.3. - Vous cherchez « GPT-5.6 Sol vs Fable 5 » ? C’était le duel de juillet 2026. Les deux gammes ont évolué depuis ; la section ci-dessous traite séparément de l’ancien duo.
Claude Fable 5.2 ou GPT-6.1 Sol : vue d’ensemble
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| Développeur | Anthropic | OpenAI |
| ID du modèle dans l’API | claude-fable-5-2 | gpt-6.1-sol |
| Sortie | 9 novembre 2026 | 29 septembre 2026 |
| Gamme | Haut de gamme d’Anthropic, au-dessus d’Opus | Gamme Sol d’OpenAI, entre GPT-6 Astra et GPT-6 Luna |
| Fenêtre de contexte | 1M tokens | 1 050 000 tokens (entrée maximale de 922 000) |
| Sortie maximale | 128K tokens | 128K tokens |
| Entrée → sortie | Texte et images → texte | Texte et images → texte |
| Réglage du raisonnement | output_config.effort | reasoning.effort |
| Niveaux d’effort | De low à max, high par défaut | De low à max, medium par défaut |
| Date limite des connaissances | Juin 2026 | 30 avril 2026 |
| Entrée / sortie officielles (par 1M) | $8 / $40 | $2 / $10 (entrée ≤272K) $4 / $15 (entrée >272K) |
| Lecture du cache officielle (par 1M) | $0.20 | $0.10 (≤272K) / $0.20 (>272K) |
| Entrée / sortie sur PoYo (par 1M) | $6.40 / $32 | $1.60 / $8 |
| Points de terminaison PoYo | /v1/messages, /v1/chat/completions | /v1/responses, /v1/chat/completions |
GPT-5.6 Sol vs Fable 5 : quelles versions comparez-vous ?
La plupart des pages bien classées sur « GPT-5.6 Sol vs Fable 5 » ont été rédigées en juillet 2026, lorsque ces deux modèles étaient les plus récents. Depuis, chaque gamme a livré de nouvelles versions :
| Modèle | Développeur | Sortie | Entrée / sortie officielles au lancement (par 1M, contexte court) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 9 juin 2026 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 9 juillet 2026 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 1er septembre 2026 | $10 / $50 |
| GPT-6 Sol | OpenAI | 22 septembre 2026 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 29 septembre 2026 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 9 novembre 2026 | $8 / $40 |
GPT-5.6 Sol vs Claude Fable 5 : le duel de juillet 2026
À son lancement, GPT-5.6 Sol coûtait deux fois moins cher que Fable 5 en entrée et 40% de moins en sortie ($5 / $30 contre $10 / $50, avec une entrée en cache à $0.50 contre $1). Les tests indépendants de ce mois-là donnaient un verdict partagé :
| Test | Protocole | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo : trois plans de conception de systèmes | Kilo Code CLI, les deux en raisonnement Max, notation selon une grille rédigée à l’avance | Meilleur score sur les trois tâches, après avoir relu et révisé lui-même chaque plan ; 52 min 53 s par plan en moyenne ; $13.57 au total | Plans jugés les plus faciles à mettre en œuvre par les testeurs ; 15 min 27 s par plan en moyenne ; $12.02 au total |
| Composio : Golden Eval, 47 workflows d’outils multi-applications | Fable 5 dans Claude Code ; Sol dans Codex CLI en high | 45 sur 47 réussis (95.7%) ; 223 779 tokens et 79.6 s par tâche en moyenne | 47 sur 47 réussis (100%) ; 276 957 tokens et 84.4 s par tâche en moyenne |
| Analytics Vidhya : application web, analyse de données, présentation pour investisseurs | Mêmes prompts, nouvelles conversations, raisonnement par défaut | Qualité comparable, avec un temps d’exécution environ deux fois plus long | Qualité comparable et exécutions plus rapides ; le choix de l’auteur pour les travaux longs et complexes confiés en une seule fois |
La tendance de juillet : GPT-5.6 Sol convenait à la planification et à la programmation pour un prix au token plus bas, et prenait plus de temps pour vérifier son propre travail ; Fable 5 convenait aux longs workflows d’outils et rédigeait des plans faciles à mettre en œuvre.
Ces résultats concernent les modèles de juillet, qui forment désormais la génération précédente. Depuis, l’écart de prix s’est creusé en faveur de Sol : Fable 5.2 coûte 4× plus cher que GPT-6.1 Sol au token, alors que Fable 5 coûtait 2× plus que GPT-5.6 Sol en entrée et environ 1.7× plus en sortie. La suite de cet article compare le duo actuel. Sur PoYo, GPT-5.6 Sol est disponible via la Responses API pour les intégrations déjà optimisées pour lui.
Ce que les deux modèles ont en commun, et ce qui les distingue
Points communs :
- Environ 1M tokens de contexte et 128K tokens de sortie par requête.
- Entrée texte et image, sortie texte.
- Cinq niveaux d’effort, de
lowàmax. Chaque éditeur calibre ses propres niveaux : comparez donc les résultats plutôt que les libellés. - Mise en cache des prompts, streaming et sorties structurées.
Différences :
- Effort par défaut. Fable 5.2 utilise
highpar défaut ; Sol,medium. Définissez l’effort explicitement dans vos tests comparatifs pour que les deux tournent au niveau voulu. - Réglages de la réflexion. Fable 5.2 réfléchit toujours de façon adaptative et accepte
tool_choiceavec la valeurautoounone. Sol se configure viareasoning.effort, et ses outils hébergés (recherche web, recherche de fichiers, interpréteur de code, shell hébergé, application de correctifs, utilisation d’un ordinateur, MCP, recherche d’outils) passent par la Responses API d’OpenAI. - Date limite des connaissances. Juin 2026 pour Fable 5.2 ; 30 avril 2026 pour Sol.
- Conservation des données. Sur l’API d’Anthropic, Fable 5.2 fonctionne avec une conservation des données de 30 jours.
Tarifs : 4× au token, 2× sur les prompts longs
Tarifs officiels (USD par 1M de tokens)
| Facturation | Claude Fable 5.2 | GPT-6.1 Sol, entrée ≤272K | GPT-6.1 Sol, entrée >272K |
|---|---|---|---|
| Entrée | $8.00 | $2.00 | $4.00 |
| Sortie | $40.00 | $10.00 | $15.00 |
| Lecture du cache | $0.20 | $0.10 | $0.20 |
| Écriture dans le cache | $10 (5 min) / $16 (1 heure) | $2.50 (30 min) / $5.00 (12 heures) | $5.00 (30 min) / $10.00 (12 heures) |
Pour les prompts de plus de 272K tokens d’entrée, OpenAI applique 2× les tarifs d’entrée et de cache et 1.5× le tarif de sortie, sur l’ensemble de la requête. Anthropic facture toute la fenêtre de 1M tokens de Fable 5.2 au tarif standard. Sur PoYo, les deux modèles appliquent un tarif unique sur toute leur fenêtre de contexte : GPT-6.1 Sol reste donc à $1.60 / $8, quelle que soit la longueur du prompt. Pour les prix de tous les modèles Claude, consultez notre guide des tarifs de l’API Claude.
Coût par requête
Ces exemples supposent que les deux modèles consomment le même nombre de tokens ; en pratique, la consommation varie selon le modèle (voir la section suivante). Les frais d’écriture dans le cache ne sont pas comptés, pour les deux modèles.
| Scénario | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Réponse de chat : 20K en entrée + 4K en sortie | Officiel : 0.02×8 + 0.004×40 = $0.32PoYo : $0.256 | Officiel : 0.02×2 + 0.004×10 = $0.08PoYo : $0.064 |
| Tâche de programmation : 100K en entrée + 10K en sortie | Officiel : 0.1×8 + 0.01×40 = $1.20PoYo : $0.96 | Officiel : 0.1×2 + 0.01×10 = $0.30PoYo : $0.24 |
| Document long : 500K en entrée + 20K en sortie | Officiel : 0.5×8 + 0.02×40 = $4.80PoYo : $3.84 | Officiel : 0.5×4 + 0.02×15 = $2.30PoYo : $0.96 |
| Session d’agent : 2M de lectures en cache + 300K de nouvelle entrée + 150K en sortie, chaque requête sous 272K | Officiel : 2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo : $7.04 | Officiel : 2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo : $1.84 |
Sur un prompt de 500K tokens, le tarif officiel de Sol en contexte long réduit l’écart de 4× à environ 2.1×. Sur PoYo, la même requête coûte $0.96 avec GPT-6.1 Sol, car PoYo facture Sol à un tarif unique, sans multiplicateur pour le contexte long.
Coût par tâche accomplie
Le prix du token ne représente que la moitié de la facture. Artificial Analysis soumet les deux modèles aux mêmes tâches de l’Intelligence Index et publie le coût :
| Effort maximal | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Coût par tâche de l’index | $26.54 | $1.27 |
| Temps par tâche de l’index | 45.3 min | 23.3 min |
| Score sur l’index | 65 | 55 |
L’écart de coût est d’environ 21×, pour un écart de prix de 4× : Fable 5.2 consacre beaucoup plus de raisonnement à chaque tâche, d’où ses scores plus élevés, tandis que Sol termine les tâches avec bien moins de tokens. Sur vos charges de travail réelles, comparez la facture totale par tâche acceptée en plus du prix au token.
Benchmarks
Même protocole : l’Artificial Analysis Intelligence Index
Artificial Analysis évalue les deux modèles avec les mêmes tâches et le même environnement de test : ses chiffres sont donc directement comparables. Intelligence Index v5.0.1, relevé le 14 novembre 2026 :
| Effort | Score de Fable 5.2 | Score de GPT-6.1 Sol | Temps par tâche, Fable 5.2 | Temps par tâche, Sol |
|---|---|---|---|---|
low | 54 | 35 | 5.8 min | 2.0 min |
medium | 56 | 46 | 7.7 min | 4.6 min |
high | 62 | 50 | 16.2 min | 7.9 min |
xhigh | 62 | 52 | 27.9 min | 10.7 min |
max | 65 | 55 | 45.3 min | 23.3 min |
Comment lire ce tableau :
- Fable 5.2 obtient un meilleur score à chaque niveau, de 10 à 19 points, ce qui convient aux travaux où la qualité de la réponse compte avant tout.
- Fable 5.2 en
lowobtient un score proche de Sol enmax(54 contre 55) en quatre fois moins de temps. - Sol atteint ses scores à faible coût : $1.27 par tâche de l’index en effort maximal, ce qui convient aux usages à grand volume et aux budgets serrés.
- Fable génère les tokens plus vite : environ 94–102 tokens de sortie par seconde, contre 47–49 pour Sol.
- Artificial Analysis marque ses exécutions de Fable 5.2 « Default Fallback », ce qui signifie que le mécanisme de repli d’Anthropic en cas de refus était activé pendant les tests.
Résultats de lancement d’Anthropic
Le tableau de Fable 5.2 publié par Anthropic le compare à GPT-6 Astra, le haut de gamme d’OpenAI. Chaque modèle a tourné à son effort maximal disponible, sauf mention contraire :
| Benchmark | Ce qu’il mesure | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | Programmation agentique | 49.1% (xhigh) | 42.8% |
| FrontierSWE v2 | Génie logiciel | 69.9% | 65.5% |
| AutomationBench | Processus métier | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | Science agentique | 74.6% | 68.1% |
| OSWorld 2.1 (offline set, partial) | Utilisation d’un ordinateur | 89.3% | 79.5% |
| Remote Labor Index | Missions réelles rémunérées | 41.3% (high) | 20.8% |
| Humanity's Last Exam (avec outils) | Raisonnement difficile | 74.2% | 57.2% |
| Chartography (sans outils) | Raisonnement sur graphiques | 73.4% | 71.0% |

Score sur FrontierCode 2.0 en fonction du coût par tâche à chaque niveau d’effort. Graphique issu des supports de lancement de Claude Fable 5.2 publiés par Anthropic.
Résultats de lancement d’OpenAI
OpenAI a lancé GPT-6.1 Sol le 29 septembre 2026, six semaines avant Fable 5.2, et l’a comparé à ses propres modèles GPT-6. OpenAI le destine à la programmation complexe, à l’utilisation d’un ordinateur et au travail professionnel, avec des capacités proches de GPT-6 Astra pour un cinquième de son prix au token ($2 / $10 contre $10 / $50). Ses évaluations de lancement couvrent le génie logiciel, la compréhension de documents, l’automatisation des processus métier et l’utilisation d’un ordinateur.
Chaque éditeur exécute les benchmarks dans son propre environnement et sa propre version de test : comparez donc les scores au sein du tableau d’un même éditeur, et appuyez-vous sur l’index d’Artificial Analysis ci-dessus pour une comparaison directe.
Lequel choisir ?
| Votre charge de travail | Commencez par | Pourquoi |
|---|---|---|
| Chat, extraction, routage à grand volume | GPT-6.1 Sol en medium (ou un modèle plus petit) | Traite les tâches courtes pour un quart du prix au token de Fable |
| Programmation courante et boucles d’agent à budget maîtrisé | GPT-6.1 Sol | Conçu pour la programmation et le travail d’agent, à $2 / $10 au tarif officiel et $1.60 / $8 sur PoYo |
| Raisonnement le plus difficile, recherche, longues exécutions autonomes | Fable 5.2 | 65 contre 55 sur l’Intelligence Index ; devance GPT-6 Astra sur tout le tableau d’Anthropic |
| Problèmes difficiles où l’attente coûte cher | Fable 5.2 en low ou medium | Score proche du maximum de Sol en quatre fois moins de temps |
| Utilisation d’un ordinateur, graphiques, documents visuels denses | Fable 5.2 | 89.3% sur OSWorld 2.1 et 73.4% sur Chartography dans le tableau d’Anthropic |
| Prompts dépassant régulièrement 272K tokens | GPT-6.1 Sol sur PoYo pour le coût, Fable 5.2 pour la profondeur | Sur PoYo, les deux gardent un tarif unique sur toute la fenêtre : $1.60 / $8 pour Sol, $6.40 / $32 pour Fable |
| Projet bâti sur les outils hébergés d’OpenAI (shell, recherche web, MCP) | GPT-6.1 Sol | Ces outils fonctionnent nativement via la Responses API |
| Besoin de la qualité Claude à un prix plus bas | Claude Opus 5.5 | $4 / $20 ; consultez Claude Fable 5.2 ou Opus 5.5 |
Les longues exécutions autonomes conviennent à Fable 5.2 : ses agents ont conçu ce prototype de système d’exploitation, présenté ici sur un ordinateur portable. Vidéo issue des supports de lancement de Claude Fable 5.2 publiés par Anthropic.
Un routage pragmatique : envoyez le trafic courant à GPT-6.1 Sol en medium, notez les types de tâches qui gagnent à un raisonnement plus approfondi, puis orientez-les vers Fable 5.2 en medium. Au bout d’une semaine, comparez le coût par tâche acceptée plutôt que les prix des tokens. Pour l’option Claude de milieu de gamme face à Sol, consultez GPT-6.1 Sol ou Claude Opus 5.5.
Utiliser les deux sur PoYo
PoYo permet d’utiliser simplement les deux modèles :
- Une seule clé d’API pour Fable 5.2, GPT-6.1 Sol et tous les autres modèles de chat, d’image, de vidéo et d’audio.
- Paiement à l’usage, facturé au token en crédits, sans abonnement.
- Les deux formats d’API : Messages d’Anthropic, ainsi que Chat Completions et Responses d’OpenAI.
- Un tarif unique par modèle sur toute la fenêtre de contexte, 20% sous chaque tarif officiel en contexte court :
| Facturation (par 1M de tokens) | Claude Fable 5.2 sur PoYo | GPT-6.1 Sol sur PoYo |
|---|---|---|
| Entrée | $6.40 | $1.60 |
| Sortie | $32.00 | $8.00 |
| Lecture du cache | $0.16 | $0.08 |
| Écriture dans le cache | $8.00 (5 min) / $12.80 (1 heure) | $2.00 |
Fable 5.2 au format Messages d’Anthropic :
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Examine ce diff à la recherche de bugs de concurrence : ..."}]
  }'
GPT-6.1 Sol via la Responses API :
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "Examine ce diff à la recherche de bugs de concurrence : ..."
  }'
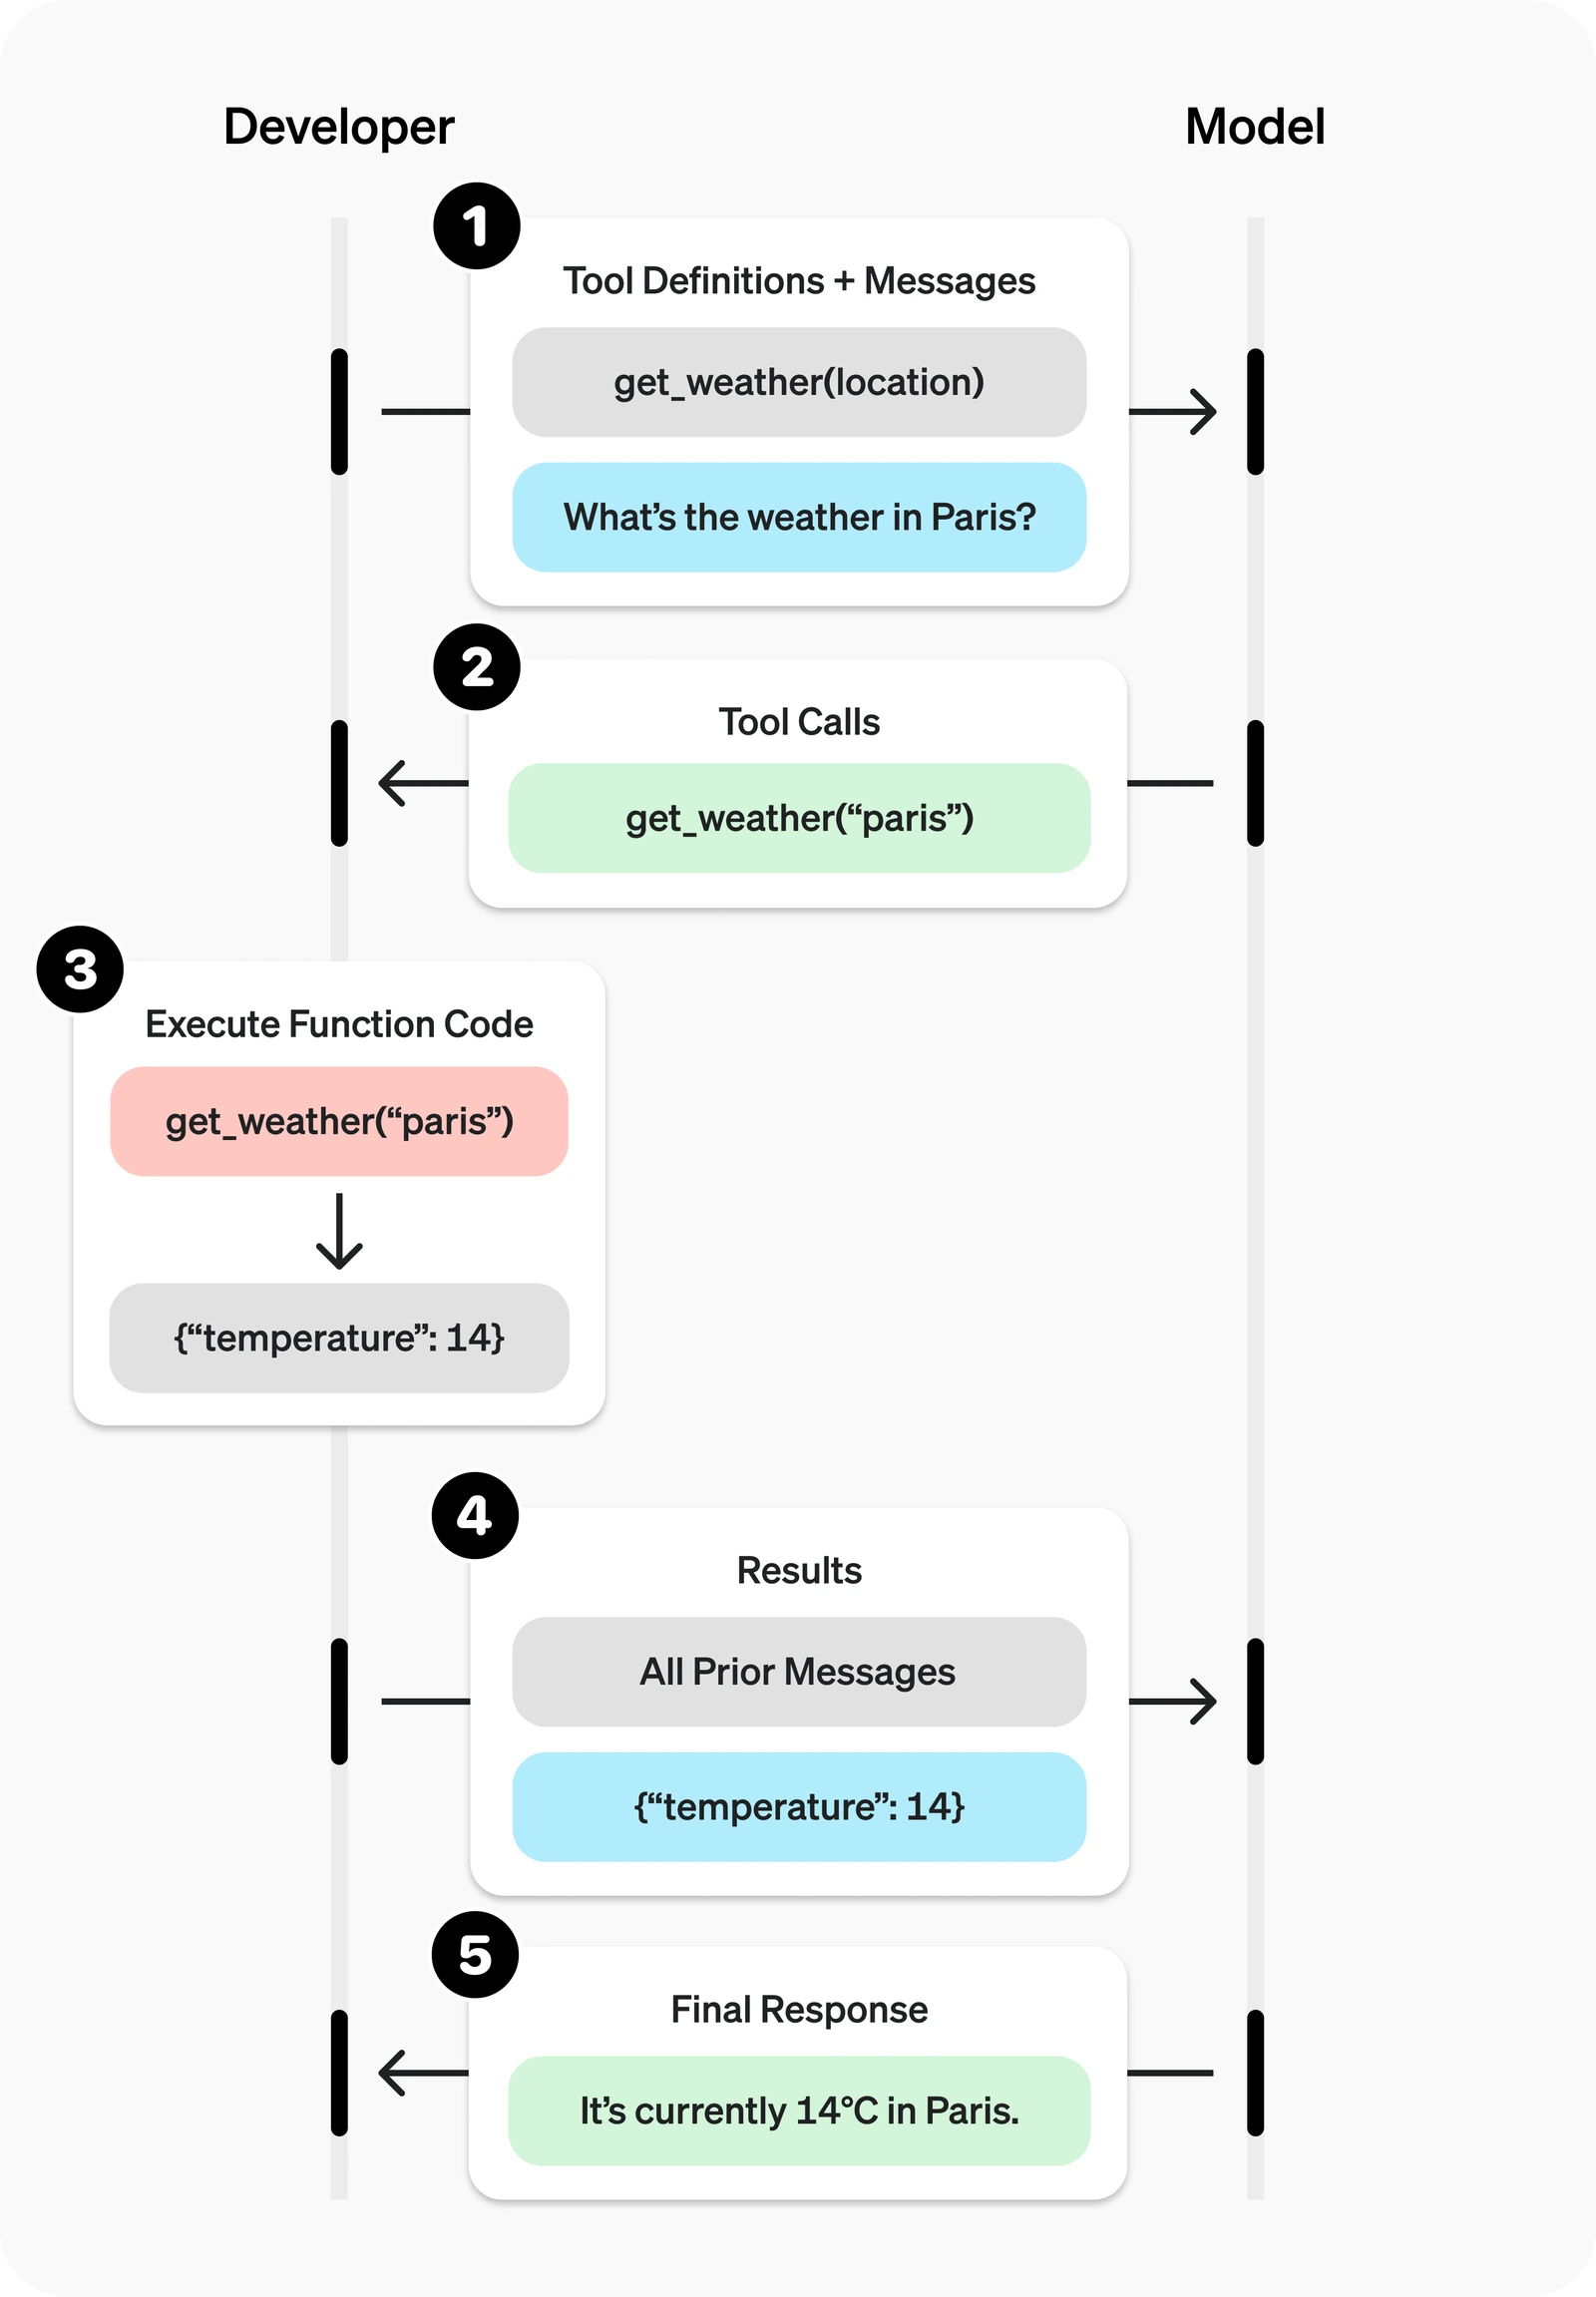
La boucle d’appel de fonctions qu’utilise GPT-6.1 Sol pour le travail avec des outils. Schéma issu de la documentation officielle d’OpenAI.
Pour un test A/B des deux modèles sur un même chemin de code, envoyez claude-fable-5-2 et gpt-6.1-sol à /v1/chat/completions en ne modifiant que le champ model. Pour la configuration des SDK, l’effort et le cache avec Fable, consultez notre guide de l’API Claude Fable 5.2 ; pour les limites et les outils de Sol, consultez le guide des fonctionnalités de GPT-6.1 Sol.
Pages des modèles : Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6.
FAQ
Fable 5 est-il meilleur que GPT-5.6 Sol ?
Chacun convenait à des travaux différents. Lors des tests de juillet 2026, Fable 5 a réussi les 47 workflows d’outils multi-applications de Composio (GPT-5.6 Sol en a réussi 45), tandis que GPT-5.6 Sol a obtenu le meilleur score sur les trois tâches de planification de conception de systèmes de Kilo, pour un prix au token plus bas. Dans la génération actuelle, Fable 5.2 obtient 65 et GPT-6.1 Sol 55 sur l’Artificial Analysis Intelligence Index, Sol coûtant une fraction du prix par tâche.
GPT Astra sera-t-il meilleur que Fable ?
GPT-6 Astra est déjà disponible, à $10 / $50 par million de tokens. Dans le tableau de lancement de Fable 5.2 publié par Anthropic, Fable 5.2 obtient un meilleur score que GPT-6 Astra sur chaque benchmark où les deux ont été testés, par exemple 74.6% contre 68.1% sur Terminal-Bench-Science 0.1 et 89.3% contre 79.5% sur OSWorld 2.1. Il s’agit des propres exécutions d’Anthropic : testez les deux sur vos tâches avant de décider.
GPT-5.6 Luna est-il meilleur ?
Luna est la gamme GPT-5.6 la plus petite et la plus abordable, conçue pour les tâches rapides à grand volume, tandis que Sol convient aux tâches plus difficiles. Choisissez Luna pour le débit et le coût, Sol pour la profondeur. Dans la génération actuelle, GPT-6 Luna est affiché à $0.10 / $0.50 par million de tokens.
GPT-5.6 Sol vaut-il le coup ?
GPT-5.6 Sol appartient à la génération précédente. Pour les nouveaux projets, GPT-6.1 Sol est le modèle Sol actuel d’OpenAI, à $2 / $10 par million de tokens en contexte court, ou $1.60 / $8 sur PoYo sur toute sa fenêtre de contexte. GPT-5.6 Sol reste un bon choix pour les intégrations déjà optimisées pour lui.
Claude Fable 5.2 est-il meilleur que GPT-6.1 Sol ?
Pour la capacité maximale, c’est Fable 5.2 qu’il faut choisir : il obtient de 10 à 19 points de plus à chaque niveau d’effort sur l’Artificial Analysis Intelligence Index. Pour le coût, c’est GPT-6.1 Sol : il coûte quatre fois moins cher au token et, en effort maximal, environ vingt fois moins cher par tâche de l’index.
Lequel est le moins cher, Fable 5.2 ou GPT-6.1 Sol ?
GPT-6.1 Sol. Les prix officiels sont de $2 / $10 par million de tokens en entrée/sortie, contre $8 / $40 pour Fable 5.2. Au-delà de 272K tokens d’entrée, OpenAI fait passer Sol à $4 / $15 pour toute la requête, tandis que Fable reste à $8 / $40. Sur PoYo, Sol reste à $1.60 / $8 quelle que soit la longueur du prompt.
Lequel est le meilleur pour la programmation ?
Les deux éditeurs publient leurs résultats de programmation sur des benchmarks différents. Anthropic annonce 49.1% pour Fable 5.2 sur FrontierCode 2.0, devant GPT-6 Astra, et OpenAI a conçu GPT-6.1 Sol pour la programmation complexe, pour un cinquième du prix au token d’Astra. Un choix par défaut raisonnable : Sol pour la programmation courante à grand volume et Fable 5.2 pour les modifications importantes et de longue durée. Testez les deux sur un échantillon de vos propres tickets.
Les deux modèles ont-ils une fenêtre de contexte de 1M tokens ?
Oui, à peu de chose près. Fable 5.2 dispose d’une fenêtre de 1M tokens. GPT-6.1 Sol dispose d’une fenêtre de 1 050 000 tokens, avec jusqu’à 922 000 tokens d’entrée. Les deux écrivent jusqu’à 128K tokens de sortie par requête.