





01
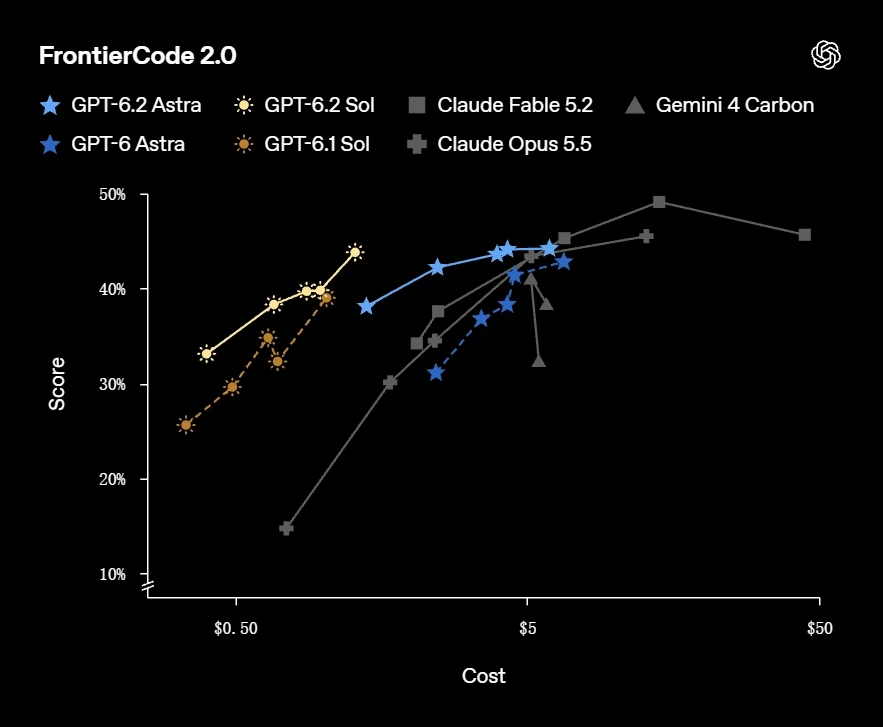
Kodowanie w granicach 0,5 punktu od Astra za jedną piątą kosztu
Zmiana w kodzie pomaga tylko wtedy, gdy spełnia standard, który maintainer zaakceptuje do scalenia. FrontierCode 2.0 od Cognition sprawdza dokładnie to na prawdziwych bazach kodu. OpenAI podaje, że w tym benchmarku GPT-6.2 Sol ustępuje modelowi GPT-6.2 Astra nie więcej niż o 0,5 punktu przy około jednej piątej kosztu, przy czym oba modele pracują na maksymalnym poziomie wnioskowania, więc zespoły mogą uzyskać jakość kodowania zbliżoną do Astra w znacznie większej liczbie zadań.
- Wprowadzanie zmian w prawdziwych, istniejących bazach kodu
- Celowanie w standardy, jakich maintainerzy wymagają przy scalaniu
- Wykonywanie większej liczby zadań kodowania w tym samym budżecie