
Model Gemini 4 Argon (gemini-4-argon) od Google DeepMind jest już dostępny w API PoYo. Po raz pierwszy pokazano go zaufanym specjalistom od cyberbezpieczeństwa w programie Fairwind 30 września 2026 r., a w październiku 2026 r. trafił do użytkowników na całym świecie. Argon to model rozumowania klasy frontier nowej generacji, oparty na rzadkiej architekturze Mixture-of-Experts (MoE). Zbudowano go z myślą o głębokim, wieloetapowym wykonywaniu zadań w inżynierii oprogramowania, finansach, analizie prawnej, badaniach naukowych i defensywnym cyberbezpieczeństwie.
Dla programistów najważniejsza zmiana w architekturze to pierwszy w branży jednolity limit 1 000 000 tokenów na wejście i wyjście — maksymalna długość odpowiedzi w jednej trajektorii rośnie z 64 000 do 1 000 000 tokenów. W PoYo możesz już dziś wywołać gemini-4-argon w cenie $1.60 za 1 mln tokenów wejściowych, $8.00 za 1 mln tokenów wyjściowych i $0.16 za 1 mln tokenów wejściowych z cache. Stawki za wejście i wyjście są o 20% niższe od startowych stawek standardowych Google, czyli $2.00 / $10.00 (stawka Google za wejście z cache wynosi $0.10 do 30 listopada 2026 r.).
Najważniejsze dane techniczne
| Specyfikacja | Gemini 4 Argon (gemini-4-argon) |
|---|---|
| Dostawca i architektura | Google DeepMind · transformer z rzadką mieszanką ekspertów (MoE) |
| ID modelu w API PoYo | gemini-4-argon |
| Jednolite okno kontekstu | 1 000 000 tokenów (wejście i wyjście łącznie) |
| Maksymalna liczba tokenów wyjściowych | Do 1 000 000 tokenów (wobec 64K w Gemini 3.x) |
| Natywne modalności wejściowe | Tekst, obrazy, audio, wideo i dokumenty PDF |
| Modalność wyjściowa | Tekst (w tym tokeny rozumowania i ustrukturyzowany kod) |
| Granica wiedzy | marzec 2026 |
| Obsługiwane endpointy PoYo | POST /v1/chat/completions (zgodny z OpenAI)POST /v1beta/models/gemini-4-argon:generateContent i :streamGenerateContent (natywny format Gemini) |
Cennik API Gemini 4 Argon: oficjalny Google vs PoYo
Google wprowadziło Gemini 4 Argon w startowej stawce standardowej $2.00 za milion tokenów wejściowych i $10.00 za milion tokenów wyjściowych (po 30 listopada 2026 r. stawki mają wzrosnąć do $4.00 / $20.00). PoYo wycenia wejście i wyjście o 20% poniżej tych stawek startowych, w modelu płatności za użycie opartym na kredytach (200 kredytów = $1.00 USD):
| Licznik tokenów | Standard Google (oficjalny) | Cena API PoYo (USD) | Kredyty PoYo / 1 mln tokenów | Oszczędność |
|---|---|---|---|---|
| Tokeny wejściowe | $2.00 / 1 mln | $1.60 / 1 mln | 320 kredytów | 20% taniej |
| Tokeny wyjściowe (w tym rozumowanie) | $10.00 / 1 mln | $8.00 / 1 mln | 1600 kredytów | 20% taniej |
| Odczyt z cache | $0.10 / 1 mln | $0.16 / 1 mln | 32 kredyty | — |
Przykładowe koszty rzeczywistych obciążeń
Ponieważ Gemini 4 Argon potrafi w jednym przebiegu wygenerować ponad 100 tys. tokenów rozumowania i odpowiedzi, to tokeny wyjściowe odpowiadają za największą część kosztu zadania. Oto porównanie PoYo z cennikiem oficjalnym dla trzech typowych obciążeń produkcyjnych:
- Refaktoryzacja repozytorium obejmująca wiele plików (150 tys. tokenów wejścia i 50 tys. wyjścia, w tym rozumowanie):
- Standard Google:
0.15 × $2.00 + 0.05 × $10.00= $0.80 za przebieg - API PoYo:
0.15 × $1.60 + 0.05 × $8.00= $0.64 za przebieg (128 kredytów)
- Standard Google:
- Firmowa analiza due diligence finansowa/prawna z korpusem w cache (400 tys. tokenów wejścia z cache, 50 tys. nowego wejścia i 25 tys. wyjścia):
- Standard Google:
0.40 × $0.10 + 0.05 × $2.00 + 0.025 × $10.00= $0.39 za przebieg - API PoYo:
0.40 × $0.16 + 0.05 × $1.60 + 0.025 × $8.00= $0.344 za przebieg (68,8 kredytu)
- Standard Google:
- Intensywna pętla agenta (10 mln tokenów wejścia i 3 mln wyjścia miesięcznie):
- Standard Google: $50.00 / miesiąc
- API PoYo: $40.00 / miesiąc (8000 kredytów)
Aby przetestować gemini-4-argon interaktywnie lub sprawdzić aktualne progi cenowe, wejdź na stronę modelu Gemini 4 Argon w PoYo.
Benchmarki: Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5
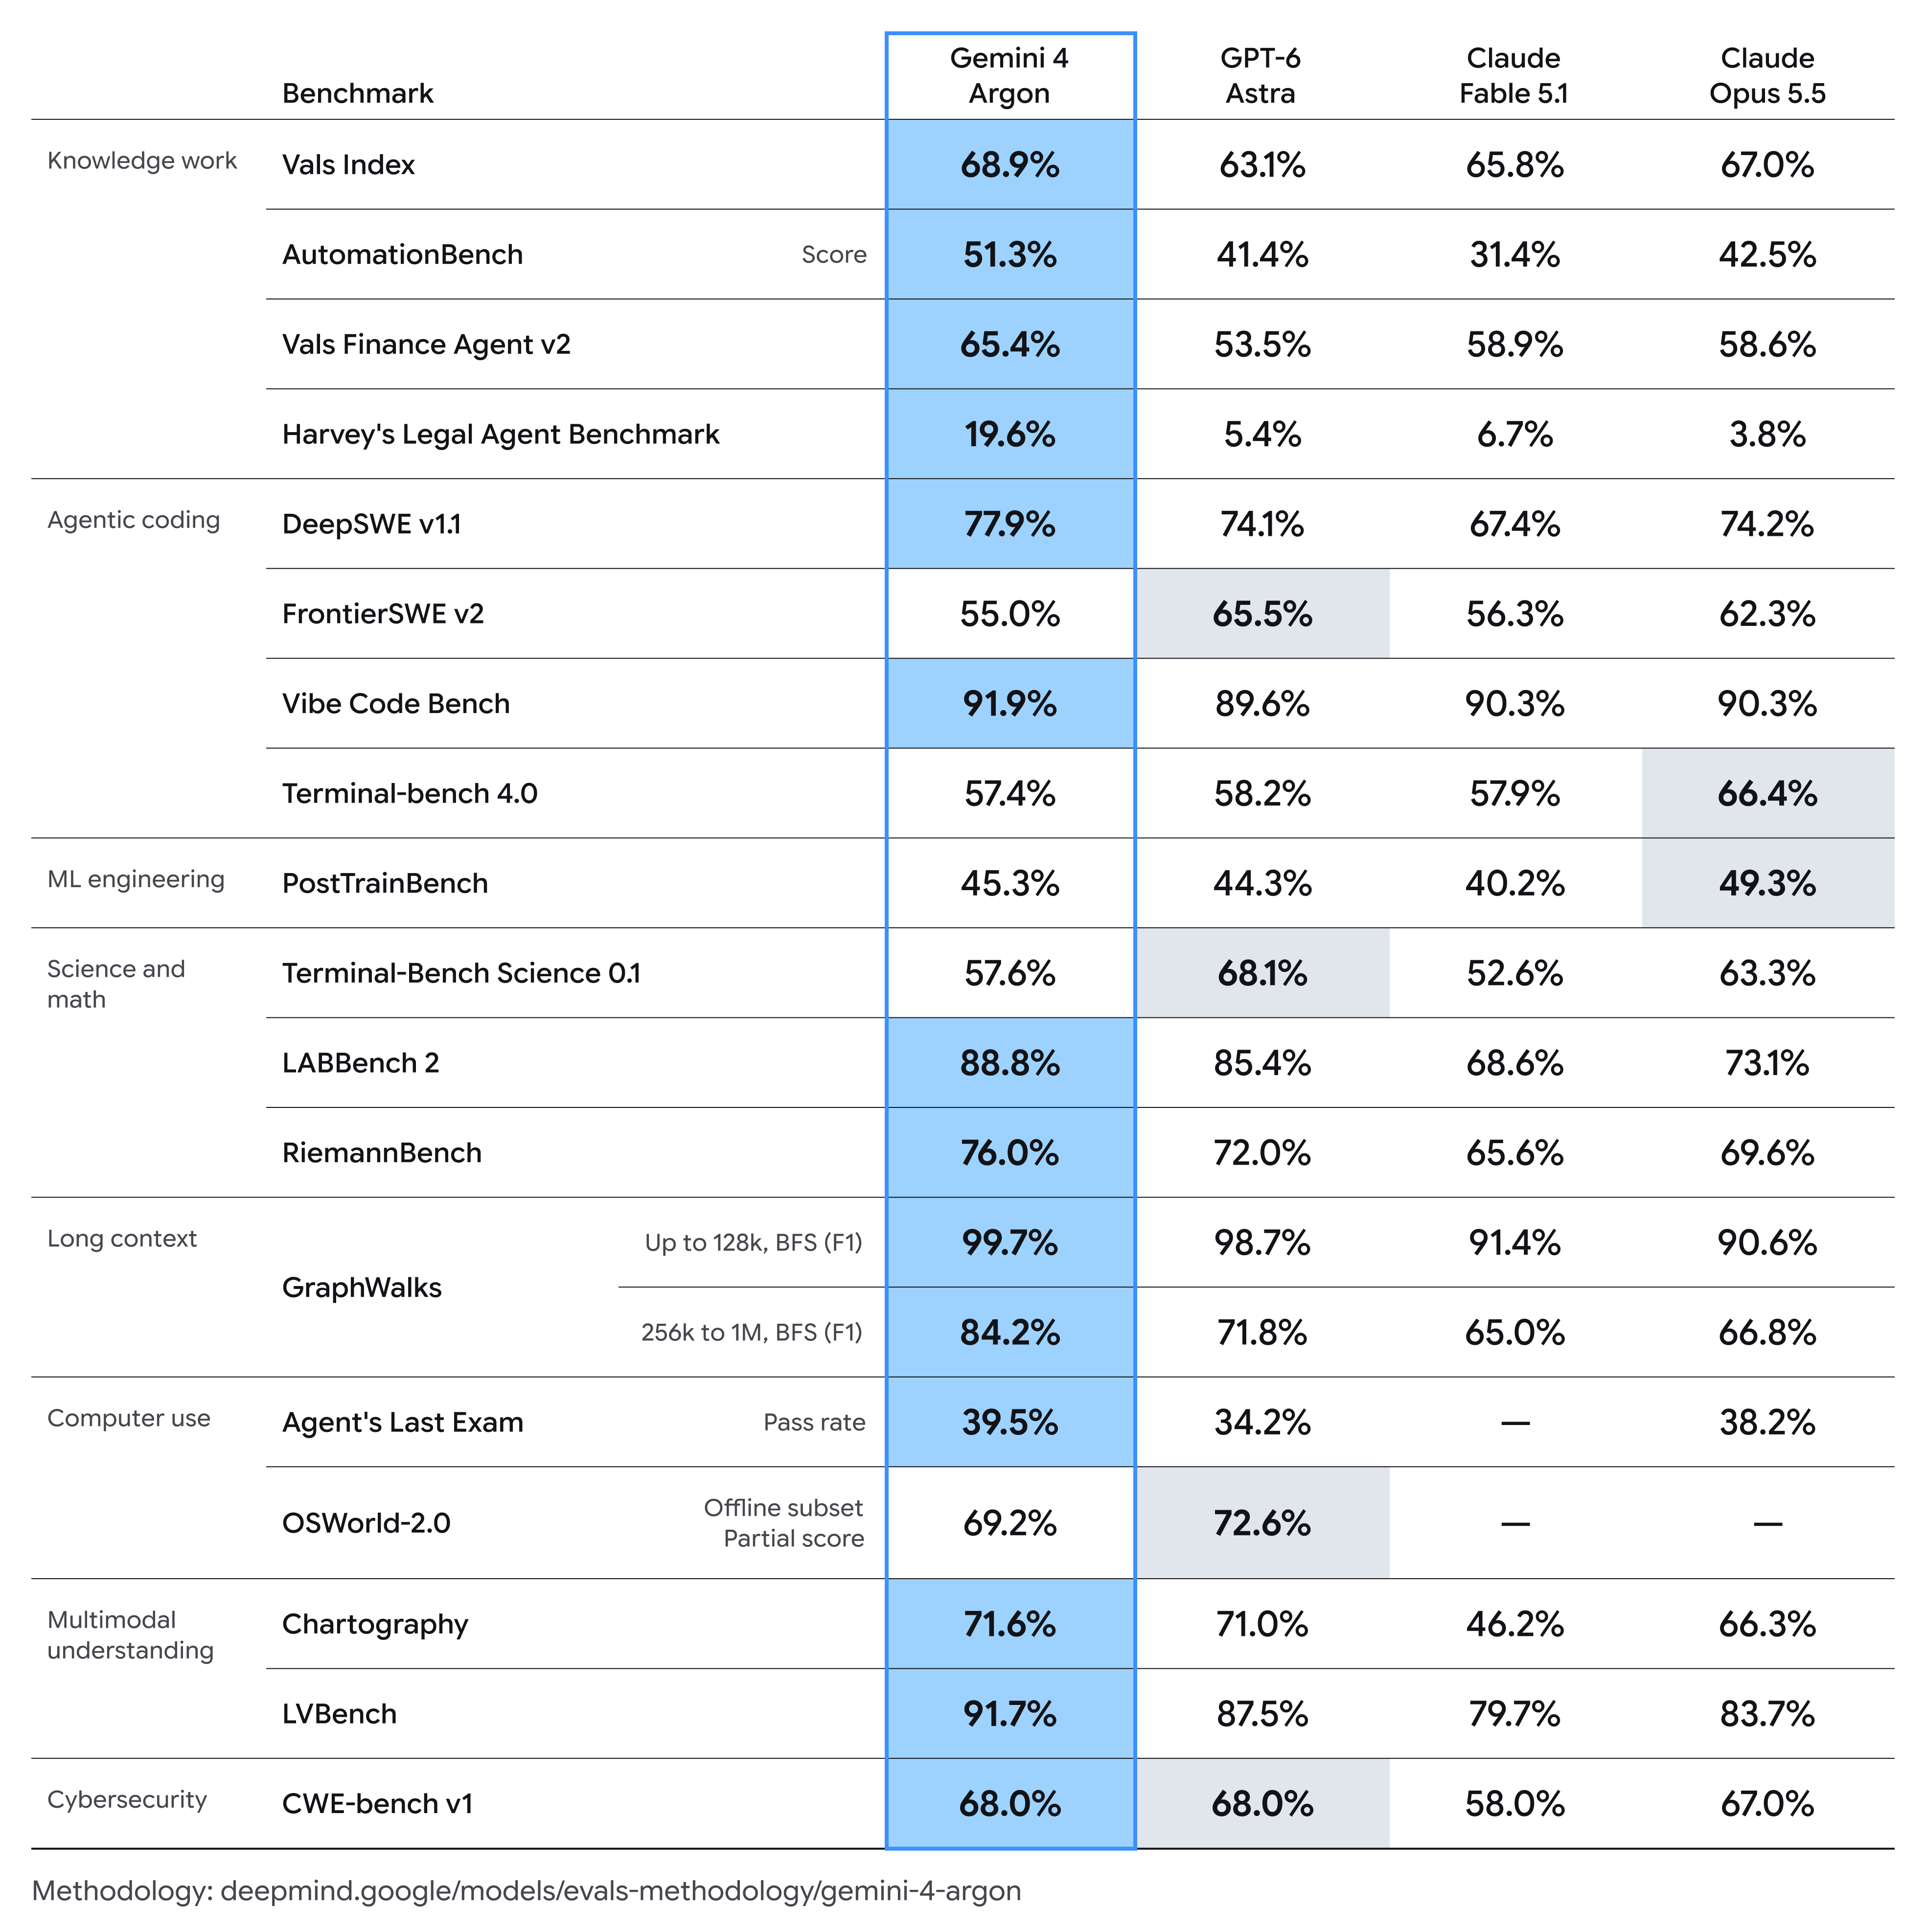
W ocenach z karty modelu Google DeepMind z października 2026 r. Gemini 4 Argon prowadzi w 13 z 18 opublikowanych benchmarków i remisuje w 1, w porównaniu z GPT-6 Astra, Claude Opus 5.5 i Claude Fable 5.1:
| Kategoria | Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|
| Praca z wiedzą | Vals Index (ważony PKB) | 68,9% | 63,1% | 67,0% | 65,8% |
| AutomationBench (Zapier) | 51,3% | 41,4% | 42,5% | 31,4% | |
| Vals Finance Agent v2 | 65,4% | 53,5% | 58,6% | 58,9% | |
| Harvey's Legal Agent Benchmark | 19,6% | 5,4% | 3,8% | 6,7% | |
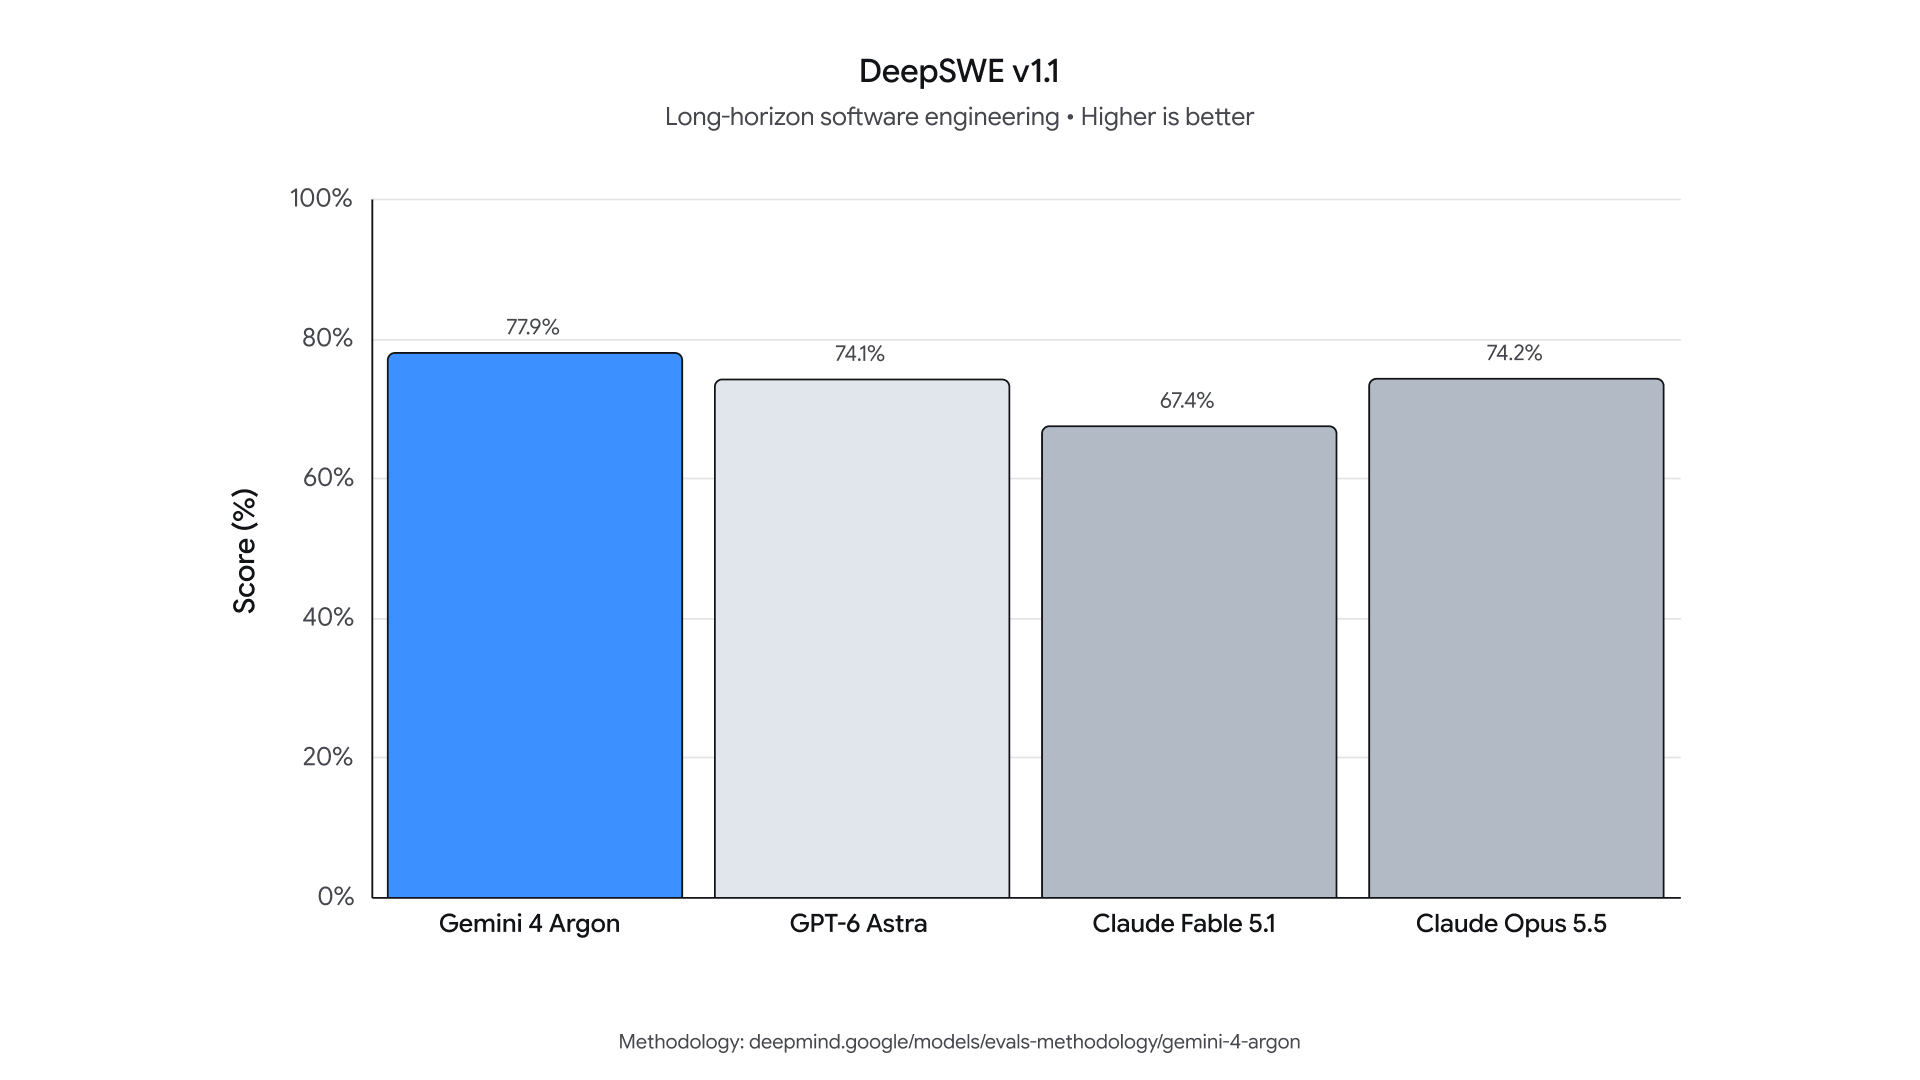
| Kodowanie agentowe | DeepSWE v1.1 | 77,9% | 74,1% | 74,2% | 67,4% |
| Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% | |
| FrontierSWE v2 | 55,0% | 65,5% | 62,3% | 56,3% | |
| Terminal-Bench 4.0 | 57,4% | 58,2% | 66,4% | 57,9% | |
| Inżynieria ML | PostTrainBench | 45,3% | 44,3% | 49,3% | 40,2% |
| Nauka i matematyka | LABBench 2 | 88,8% | 85,4% | 73,1% | 68,6% |
| RiemannBench | 76,0% | 72,0% | 69,6% | 65,6% | |
| Terminal-Bench Science 0.1 | 57,6% | 68,1% | 63,3% | 52,6% | |
| Długi kontekst | GraphWalks (≤128K, BFS F1) | 99,7% | 98,7% | 90,6% | 91,4% |
| GraphWalks (256K–1M, BFS F1) | 84,2% | 71,8% | 66,8% | 65,0% | |
| Obsługa komputera | Agent's Last Exam (odsetek zaliczonych) | 39,5% | 34,2% | 38,2% | — |
| OSWorld-2.0 (częściowy, offline) | 69,2% | 72,6% | — | — | |
| Multimodalność | LVBench (długie wideo) | 91,7% | 87,5% | 83,7% | 79,7% |
| Chartography | 71,6% | 71,0% | 66,3% | 46,2% | |
| Cyberbezpieczeństwo | CWE-bench v1 | 68,0% | 68,0% | 67,0% | 58,0% |
Najważniejsze wnioski dla routingu modeli
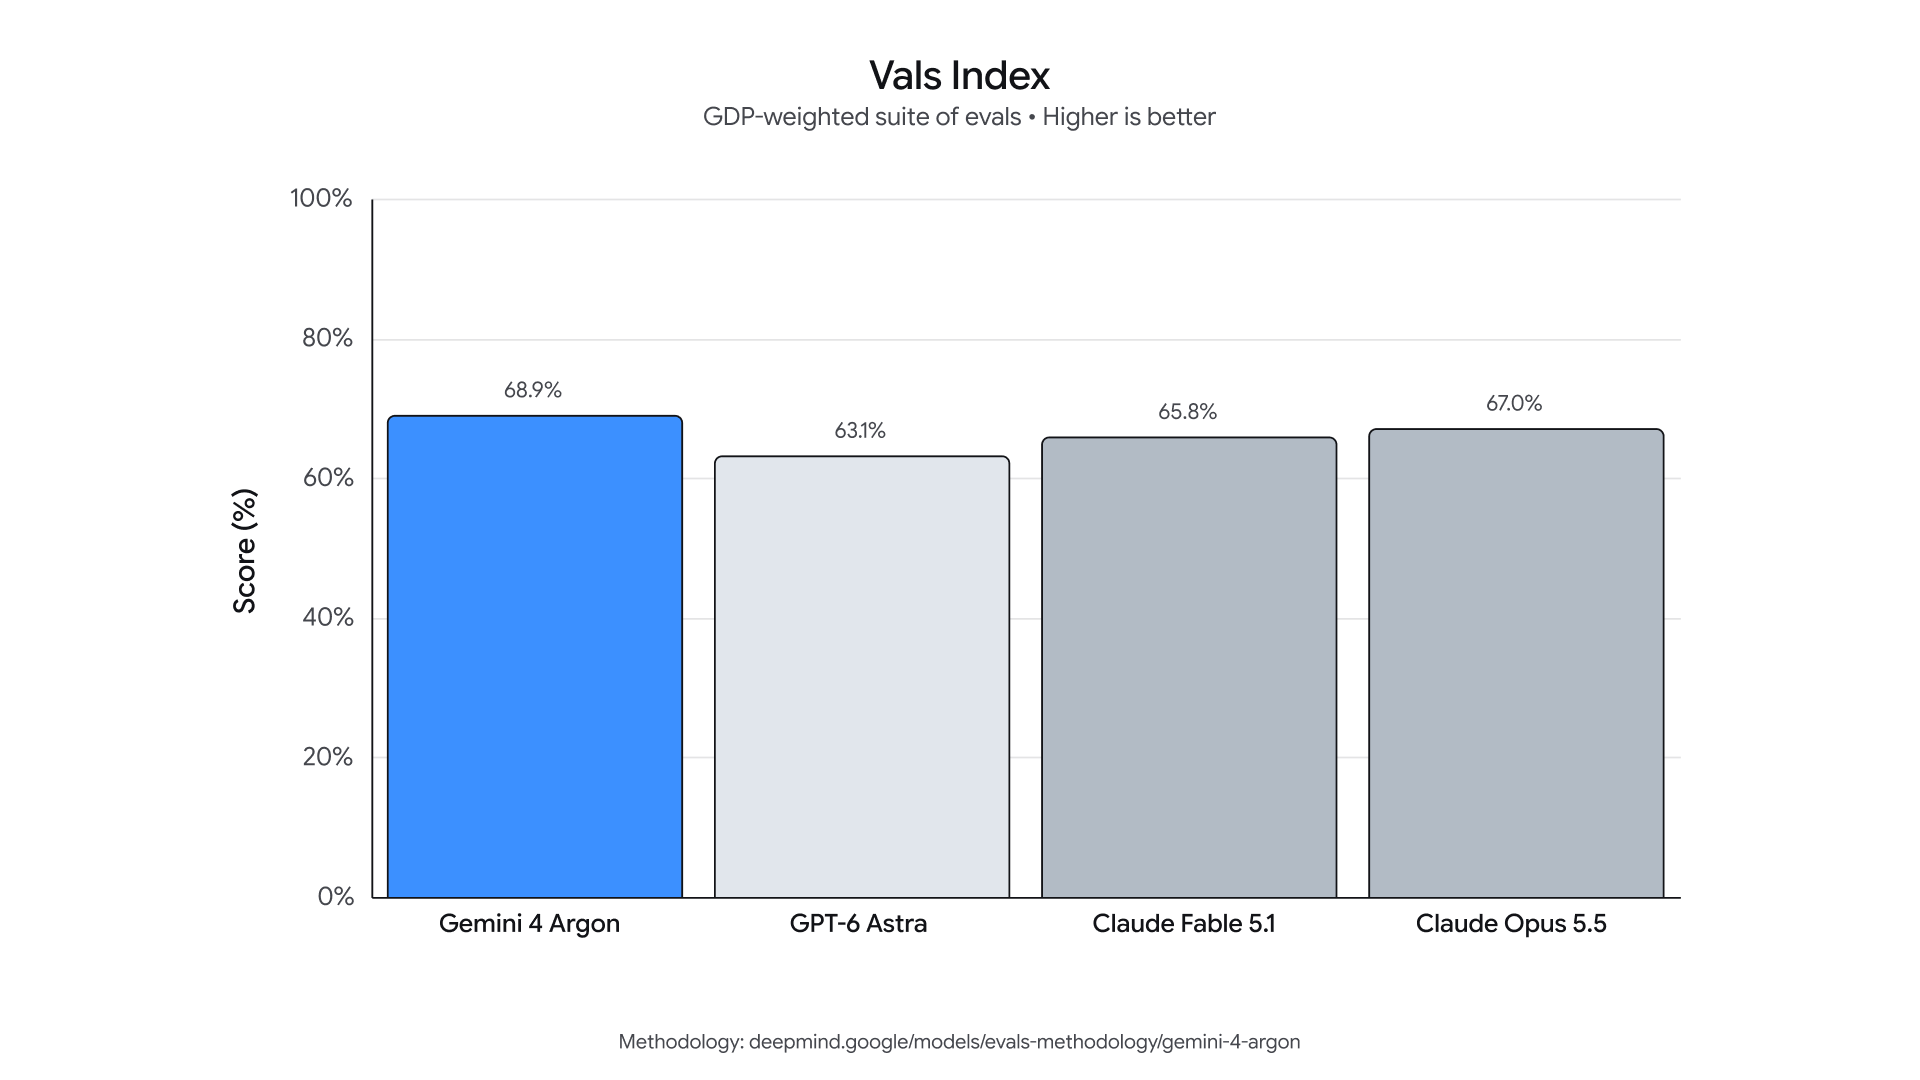
- Gdzie Gemini 4 Argon wygrywa zdecydowanie: długotrwała refaktoryzacja repozytoriów (DeepSWE v1.1: 77,9%), rozumowanie na ultradługim kontekście od 256K do 1 mln tokenów (GraphWalks: 84,2% wobec 66,8% u Opus 5.5), ustrukturyzowane procesy firmowe (AutomationBench: 51,3%), synteza prawna i finansowa (Harvey: 19,6%, Vals Finance: 65,4%) oraz multimodalna analiza długich nagrań wideo (LVBench: 91,7%).
- Gdzie przewagę mają Claude Opus 5.5 lub GPT-6 Astra: interaktywne wykonywanie poleceń w powłoce (Terminal-Bench 4.0, gdzie Claude Opus 5.5 osiąga 66,4% wobec 57,4% u modelu Argon) oraz wyspecjalizowane zestawy testowe SWE i naukowe (FrontierSWE v2 i Terminal-Bench Science 0.1, gdzie prowadzi GPT-6 Astra).
- Stosunek ceny do wydajności: przy stawkach $1.60 / $8.00 w PoYo Gemini 4 Argon kosztuje o 50% mniej za token niż Claude Opus 5.5 ($3.20 / $16.00 w PoYo) i o 80% mniej niż GPT-6 Astra ($8.00 / $40.00 w PoYo). Mieści się w tym samym przedziale cenowym tokenów co GPT-6.1 Sol i Claude Sonnet 5.5, a oferuje flagowe rozumowanie klasy frontier.
Co wyróżnia Gemini 4 Argon w produkcji?
1. Jednolite okno 1 mln tokenów wejścia i wyjścia dla nieprzerwanych trajektorii
Wcześniejsze modele Gemini ograniczały wyjście do 64K tokenów, przez co agenci kodujący i badawczy musieli obcinać duże diffy albo sklejać odpowiedzi z kilku tur. Dzięki wspólnej puli 1 mln tokenów dla wejścia i wyjścia Argon może przeznaczyć ponad 100 000 tokenów na wewnętrzny łańcuch rozumowania (chain-of-thought) i nadal zwrócić w jednej odpowiedzi kompletne migracje kodu obejmujące wiele plików, formalne dowody matematyczne w Lean albo wyczerpujące audyty zgodności.
W Google inżynierowie wykorzystali model Argon do wydzielenia 6 mln linii starszego kodu funkcji przeglądarki z 40-milionowego repozytorium Chromium, przepisania 32 tys. linii dekodowania wideo SIMD w libgav1 na bezpieczny Rust (działający 2,7 raza szybciej niż poprzedni port w Rust) oraz przyspieszenia przepustowości wnioskowania vLLM dla Gemma 4 E2B 2,85 raza na GPU A100.
2. Defensywne cyberbezpieczeństwo i odporność na prompt injection
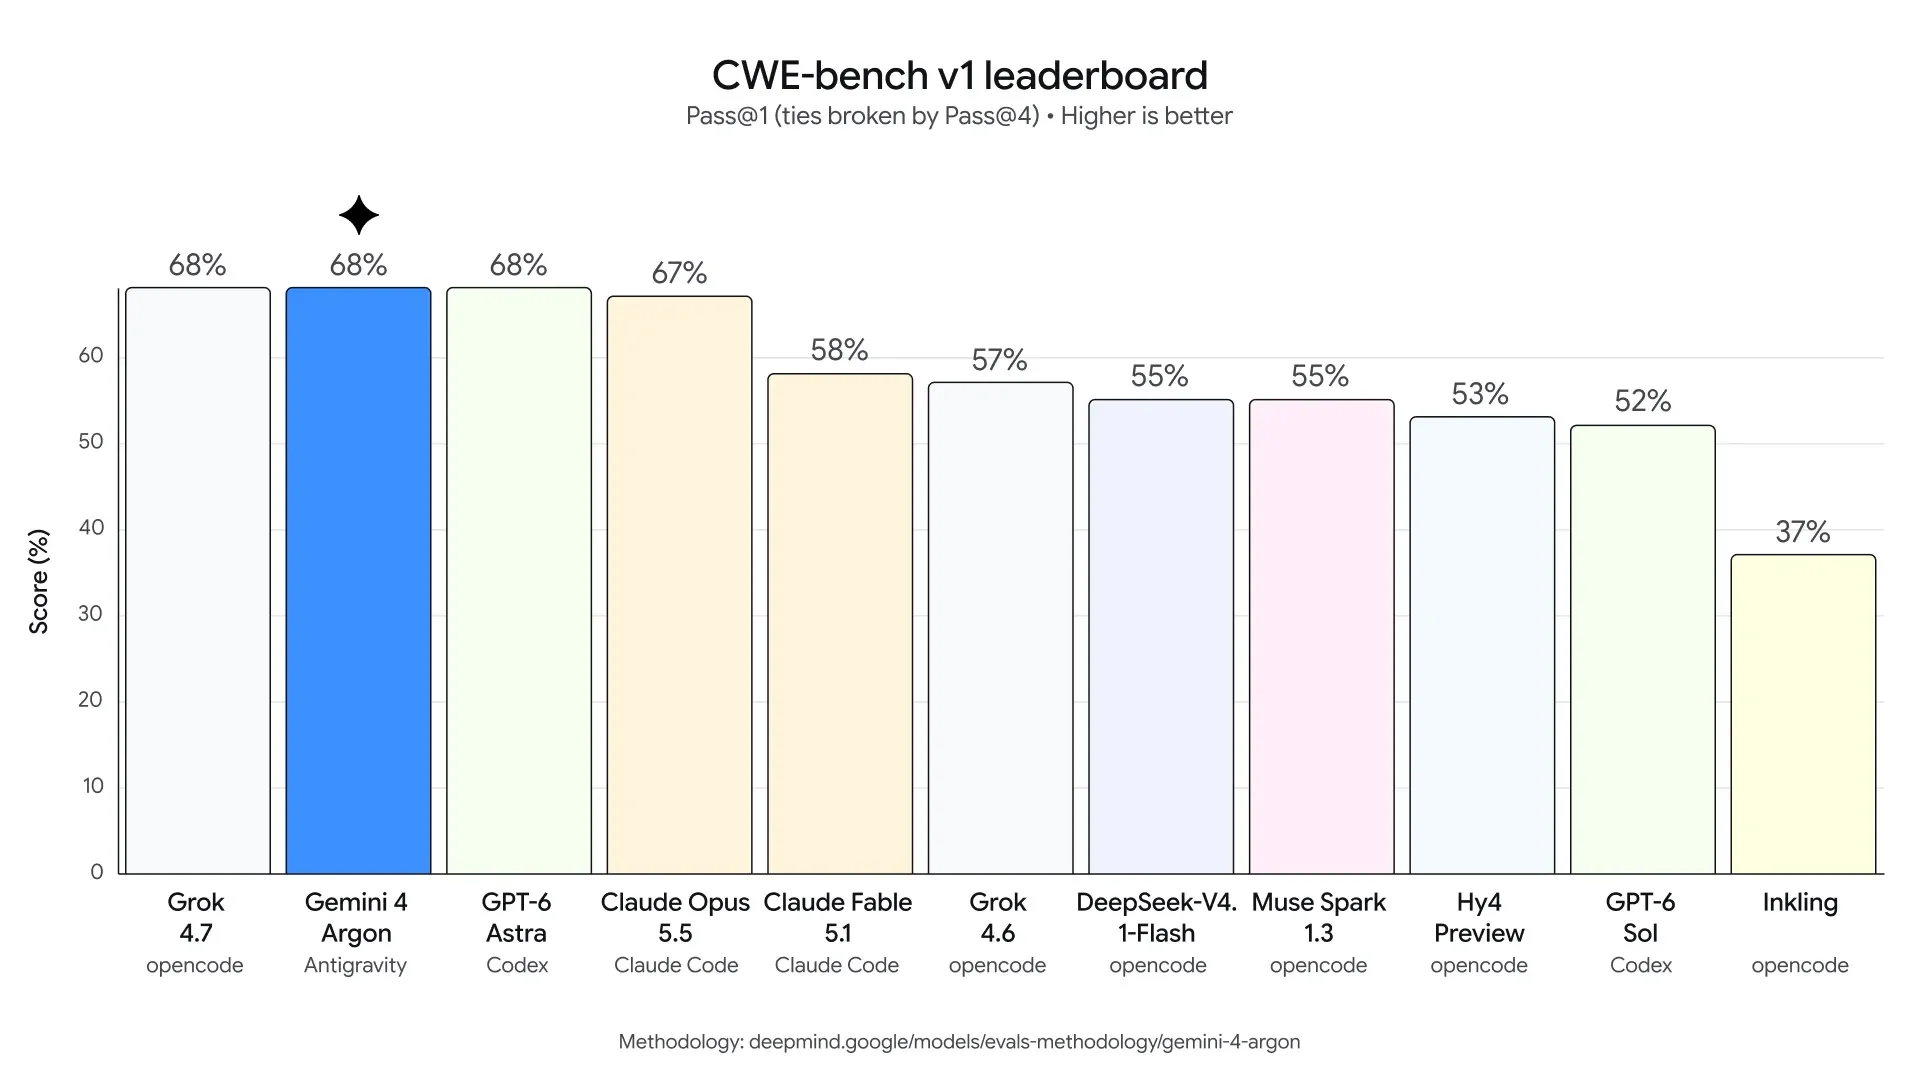
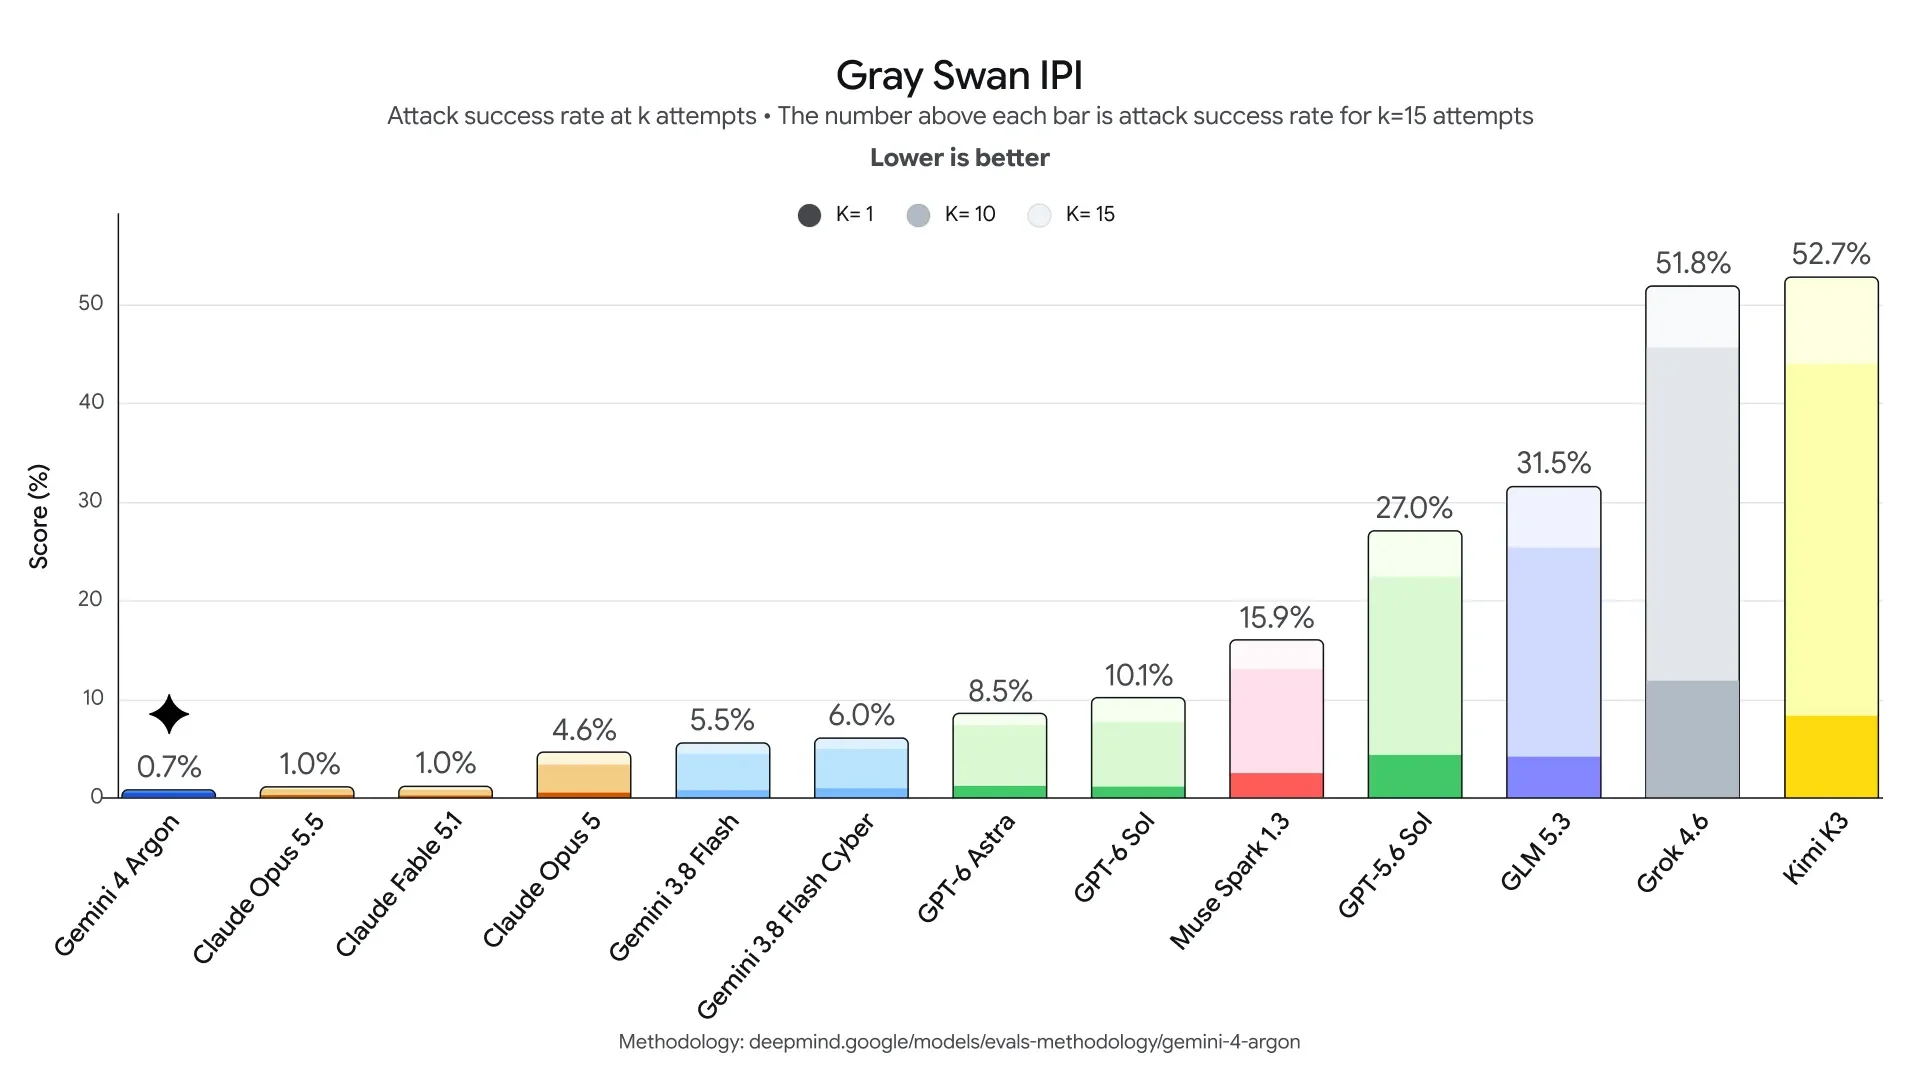
Argon został wytrenowany dla zespołów bezpieczeństwa w programie Fairwind Google i wdrożony w inicjatywie Scan for Good firmy Wiz. Dzieli pierwsze miejsce w CWE-bench v1 (68,0%) i wykrywa wieloetapowe łańcuchy podatności w 20 językach programowania. Dla agentów firmowych, które przeglądają niezaufane strony lub analizują zewnętrzne pliki PDF, osiąga w benchmarku Indirect Prompt Injection (IPI) firmy Gray Swan 0,7% skuteczności ataków przy 15 adaptacyjnych próbach — to najniższy odsetek przejęć wśród modeli klasy frontier.
3. Natywna multimodalność oraz rozumowanie przestrzenne 3D i naukowe
W odróżnieniu od modeli obsługujących tylko tekst i obrazy Argon natywnie przyjmuje tekst, obrazy w wysokiej rozdzielczości, audio, długie wideo i pliki PDF. Uzyskuje 87% w Embodied Reasoning (ERQA) i 91,7% w LVBench, co otwiera drogę do robotyki w podejściu „Video-to-Sim-to-Real", trójwymiarowych rekonstrukcji archeologicznych na podstawie 50 GB archiwów LiDAR i CAD oraz 2,3 raza szybszego przewidywania struktury cząsteczek w chemii kwantowej (xTB).
Jak wywołać API Gemini 4 Argon w PoYo
PoYo obsługuje zarówno OpenAI Chat Completions (/v1/chat/completions), jak i natywny format Google Gemini (/v1beta/models/gemini-4-argon:generateContent oraz :streamGenerateContent) przy użyciu jednego klucza API PoYo.
Opcja 1: Chat Completions zgodne z OpenAI (POST /v1/chat/completions)
Użyj istniejącego SDK OpenAI dla Pythona lub Node albo cURL, ustawiając bazowy adres URL na https://api.poyo.ai/v1, a model na gemini-4-argon:
curl --request POST \
  --url https://api.poyo.ai/v1/chat/completions \
  --header "Authorization: Bearer YOUR_POYO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "gemini-4-argon",
    "messages": [
      {
        "role": "system",
        "content": "You are a principal systems architect and security auditor."
      },
      {
        "role": "user",
        "content": "Design a memory-safe Rust migration plan for a C++ video frame ring buffer, including zero-copy slices and unit tests."
      }
    ],
    "temperature": 1.0,
    "max_tokens": 16384,
    "stream": false
  }'
Opcja 2: natywny format Google Gemini (:generateContent i :streamGenerateContent)
Aby korzystać z natywnych części multimodalnych, systemInstruction i generationConfig, wywołaj bezpośrednio endpoint w natywnym formacie Gemini:
curl --request POST \
  --url "https://api.poyo.ai/v1beta/models/gemini-4-argon:generateContent" \
  --header "Authorization: Bearer YOUR_POYO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "systemInstruction": {
      "parts": [
        { "text": "Provide rigorous financial and legal analysis with explicit citations." }
      ]
    },
    "contents": [
      {
        "role": "user",
        "parts": [
          { "text": "Compare the working capital adjustments and indemnification caps across these merger agreement clauses." }
        ]
      }
    ],
    "generationConfig": {
      "temperature": 1.0,
      "maxOutputTokens": 32768,
      "topP": 0.95
    }
  }'
Aby uzyskać odpowiedzi strumieniowe w natywnym formacie Gemini, zamień :generateContent na :streamGenerateContent?alt=sse.
Najczęstsze pytania
Jakie jest dokładne ID modelu Gemini 4 Argon w PoYo?
Użyj gemini-4-argon zarówno w /v1/chat/completions, jak i w /v1beta/models/gemini-4-argon:generateContent.
Czy tokeny rozumowania są rozliczane osobno?
Zgodnie ze specyfikacją rozliczeń Google użycie tokenów wyjściowych obejmuje wewnętrzne tokeny rozumowania (thinking) i jest rozliczane według stawki wyjściowej PoYo, czyli $8.00 za 1 mln tokenów (1600 kredytów). Ustaw odpowiednio max_tokens lub maxOutputTokens, aby ograniczyć koszty rozumowania w rutynowych zadaniach.
Jak zacząć?
Wygeneruj klucz API w sekcji Dashboard PoYo, przetestuj prompty na żywo na stronie Gemini 4 Argon Playground albo przejrzyj wszystkie modele czatu klasy frontier w katalogu API czatu AI w PoYo.