
要点
- 最も難しい作業にはFable 5.2、大量処理にはGPT-6.1 Sol。 Artificial Analysis Intelligence Indexでは、max effortでFable 5.2が65、GPT-6.1 Solが55を記録し、Solはインデックスのタスクを1件あたりわずかなコストでこなします。
- 公式のトークン単価: 入力/出力100万トークンあたり、Fable 5.2は$8 / $40、Solは短いコンテキストで$2 / $10と、4倍の差があります。
- PoYoでは一律料金。 OpenAIは入力が272Kトークンを超えると、Solのリクエスト全体を$4 / $15に引き上げます。PoYoでは、GPT-6.1 Solはコンテキストウィンドウ全体で$1.60 / $8、Fable 5.2は1Mのウィンドウ全体で$6.40 / $32です。
- Fable 5.2はタスクごとにより多くの推論を投入する。 Artificial Analysisの測定では、max effortでのインデックスのタスクあたりのコストは、Fable 5.2が$26.54、Solが$1.27でした。
- Fable 5.2は短時間で高いスコアに届く。
loweffortで54を記録し、maxのSolの55に迫ります。インデックスのタスク1件にかかる時間は、Solの23.3分に対して5.8分です。 - 「GPT-5.6 Sol vs Fable 5」で検索した方へ。 それは2026年7月の対決です。両シリーズとも世代が進んでおり、旧世代の組み合わせは下のセクションで別に取り上げています。
Claude Fable 5.2とGPT-6.1 Solの概要
| Claude Fable 5.2 | GPT-6.1 Sol | |
|---|---|---|
| 開発元 | Anthropic | OpenAI |
| APIモデルID | claude-fable-5-2 | gpt-6.1-sol |
| リリース日 | 2026年11月9日 | 2026年9月29日 |
| 位置づけ | Anthropicの最上位ティア(Opusより上) | OpenAIのSolティア(GPT-6 AstraとGPT-6 Lunaの間) |
| コンテキストウィンドウ | 1Mトークン | 1,050,000トークン(最大入力922,000) |
| 最大出力 | 128Kトークン | 128Kトークン |
| 入力 → 出力 | テキストと画像 → テキスト | テキストと画像 → テキスト |
| 推論の制御 | output_config.effort | reasoning.effort |
| effortレベル | low〜max、デフォルトはhigh | low〜max、デフォルトはmedium |
| ナレッジカットオフ | 2026年6月 | 2026年4月30日 |
| 公式の入力 / 出力(100万トークンあたり) | $8 / $40 | $2 / $10(入力≤272K) $4 / $15(入力>272K) |
| 公式のキャッシュ読み取り(100万トークンあたり) | $0.20 | $0.10(≤272K) / $0.20(>272K) |
| PoYoの入力 / 出力(100万トークンあたり) | $6.40 / $32 | $1.60 / $8 |
| PoYoのエンドポイント | /v1/messages、/v1/chat/completions | /v1/responses、/v1/chat/completions |
GPT-5.6 SolとFable 5:どのバージョン同士を比べるのか
「GPT-5.6 Sol vs Fable 5」で上位に表示されるページの多くは、この2つが最新モデルだった2026年7月に書かれたものです。その後、どちらのシリーズも新しいバージョンをリリースしています。
| モデル | 開発元 | リリース日 | リリース時の公式の入力 / 出力(100万トークンあたり、短いコンテキスト) |
|---|---|---|---|
| Claude Fable 5 | Anthropic | 2026年6月9日 | $10 / $50 |
| GPT-5.6 Sol | OpenAI | 2026年7月9日 | $5 / $30 |
| Claude Fable 5.1 | Anthropic | 2026年9月1日 | $10 / $50 |
| GPT-6 Sol | OpenAI | 2026年9月22日 | $2 / $10 |
| GPT-6.1 Sol | OpenAI | 2026年9月29日 | $2 / $10 |
| Claude Fable 5.2 | Anthropic | 2026年11月9日 | $8 / $40 |
GPT-5.6 SolとClaude Fable 5:2026年7月の対決
リリース時、GPT-5.6 SolはFable 5と比べて入力が半額、出力が40%安い料金でした($5 / $30対$10 / $50、キャッシュされた入力は$0.50対$1)。同月に行われた第三者のテストでは、評価が分かれました。
| テスト | 条件 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| Kilo:システム設計プラン3件 | Kilo Code CLI、両モデルともMax reasoning、事前に作成したルーブリックで採点 | 各プランを自らレビューして修正したうえで、3つのタスクすべてで最高スコア。1プランあたり平均52分53秒、合計$13.57 | テスターが最も実装しやすいと評価したプラン。1プランあたり平均15分27秒、合計$12.02 |
| Composio:Golden Eval、複数アプリにまたがるツールワークフロー47件 | Fable 5はClaude Code、SolはCodex CLI(high) | 47件中45件合格(95.7%)。タスクあたり平均223,779トークン、79.6秒 | 47件中47件合格(100%)。タスクあたり平均276,957トークン、84.4秒 |
| Analytics Vidhya:Webアプリ、データ分析、投資家向け資料 | 同じプロンプト、新しいチャット、デフォルトのreasoning | 同等の品質で、実行時間は約2倍 | 同等の品質で、実行はより速い。長く複雑な作業を一度に任せる用途で筆者が選んだモデル |
7月の傾向をまとめると、GPT-5.6 Solは安いトークン単価で計画立案やコーディングに向いており、自分の作業の確認に時間をかけていました。Fable 5は長いツールワークフローに向いており、実装しやすいプランを書きました。
これらの結果は7月のモデルについてのもので、いまでは1つ前の世代です。その後、価格差はSol有利の方向に広がりました。Fable 5はGPT-5.6 Solに対して入力が2倍、出力が約1.7倍でしたが、Fable 5.2のトークン単価はGPT-6.1 Solの4倍です。この記事では以降、現行の組み合わせを比較します。PoYoでは、GPT-5.6 Solに合わせて調整済みの連携向けに、Responses APIでGPT-5.6 Solも利用できます。
2つのモデルの共通点と相違点
共通点:
- 約1Mトークンのコンテキストと128Kの出力トークン(1リクエストあたり)。
- テキストと画像の入力、テキストの出力。
- 5段階のeffort(
low〜max)。各社が独自にレベルを調整しているため、ラベルではなく結果で比べてください。 - プロンプトキャッシュ、ストリーミング、構造化出力。
相違点:
- デフォルトのeffort。 Fable 5.2のデフォルトは
high、Solはmediumです。並べて比較するテストでは、両方が意図したレベルで動くようeffortを明示的に設定してください。 - 思考の制御。 Fable 5.2は常にアダプティブに思考し、
tool_choiceにはautoまたはnoneを指定できます。Solはreasoning.effortで設定し、ホスト型ツール(Web検索、ファイル検索、コードインタープリター、ホスト型シェル、apply patch、コンピューター操作、MCP、ツール検索)はOpenAIのResponses APIを通じて動作します。 - ナレッジカットオフ。 Fable 5.2は2026年6月、Solは2026年4月30日です。
- データ保持。 AnthropicのAPIでは、Fable 5.2は30日間のデータ保持で動作します。
料金:トークン単価は4倍、長いプロンプトでは2倍
公式料金(米ドル/100万トークン)
| 料金項目 | Claude Fable 5.2 | GPT-6.1 Sol、入力≤272K | GPT-6.1 Sol、入力>272K |
|---|---|---|---|
| 入力 | $8.00 | $2.00 | $4.00 |
| 出力 | $40.00 | $10.00 | $15.00 |
| キャッシュ読み取り | $0.20 | $0.10 | $0.20 |
| キャッシュ書き込み | $10(5分) / $16(1時間) | $2.50(30分) / $5.00(12時間) | $5.00(30分) / $10.00(12時間) |
OpenAIは入力が272Kトークンを超えるプロンプトに対し、リクエスト全体で入力とキャッシュを2倍、出力を1.5倍の料金にします。AnthropicはFable 5.2の1Mウィンドウ全体を標準料金で課金します。PoYoでは両モデルともコンテキストウィンドウ全体で一律の料金なので、GPT-6.1 Solはプロンプトがどれだけ長くても$1.60 / $8のままです。すべてのClaudeモデルの料金は、Claude API料金ガイドをご覧ください。
リクエストあたりのコスト
以下の例では、両モデルが同じ数のトークンを使うと仮定しています。実際の使用量はモデルによって異なります(次のセクションを参照)。キャッシュ書き込みの料金は両モデルとも含めていません。
| シナリオ | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| チャットの返信: 入力20K + 出力4K | 公式:0.02×8 + 0.004×40 = $0.32PoYo:$0.256 | 公式:0.02×2 + 0.004×10 = $0.08PoYo:$0.064 |
| コーディングタスク: 入力100K + 出力10K | 公式:0.1×8 + 0.01×40 = $1.20PoYo:$0.96 | 公式:0.1×2 + 0.01×10 = $0.30PoYo:$0.24 |
| 長いドキュメント: 入力500K + 出力20K | 公式:0.5×8 + 0.02×40 = $4.80PoYo:$3.84 | 公式:0.5×4 + 0.02×15 = $2.30PoYo:$0.96 |
| エージェントセッション: キャッシュ読み取り2M + 新規入力300K + 出力150K、すべてのリクエストが272K未満 | 公式:2×0.2 + 0.3×8 + 0.15×40 = $8.80PoYo:$7.04 | 公式:2×0.1 + 0.3×2 + 0.15×10 = $2.30PoYo:$1.84 |
500Kトークンのプロンプトでは、Solの公式の長文コンテキスト料金によって、差は4倍から約2.1倍に縮まります。PoYoでは、Solを長文コンテキストの倍率なしの一律料金で課金するため、同じリクエストがGPT-6.1 Solで$0.96になります。
完了タスクあたりのコスト
トークン単価は請求額の半分にすぎません。Artificial Analysisは、両モデルに同じIntelligence Indexのタスクを実行させ、そのコストを公表しています。
| max effort | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| インデックスのタスクあたりのコスト | $26.54 | $1.27 |
| インデックスのタスクあたりの時間 | 45.3分 | 23.3分 |
| インデックスのスコア | 65 | 55 |
価格差が4倍であるのに対し、コストの差は約21倍です。Fable 5.2はタスクごとにはるかに多くの推論を投入しており、それが高いスコアにつながっています。一方、Solははるかに少ないトークンでタスクを終えます。実際のワークロードでは、トークン単価とあわせて、合格したタスクあたりの請求総額を比べてください。
ベンチマーク
同一条件:Artificial Analysis Intelligence Index
Artificial Analysisは同じタスクと評価環境で両モデルを評価しているため、数値を直接比べられます。Intelligence Index v5.0.1(2026年11月14日時点):
| effort | Fable 5.2のスコア | GPT-6.1 Solのスコア | Fable 5.2のタスクあたりの時間 | Solのタスクあたりの時間 |
|---|---|---|---|---|
low | 54 | 35 | 5.8分 | 2.0分 |
medium | 56 | 46 | 7.7分 | 4.6分 |
high | 62 | 50 | 16.2分 | 7.9分 |
xhigh | 62 | 52 | 27.9分 | 10.7分 |
max | 65 | 55 | 45.3分 | 23.3分 |
表の読み方:
- Fable 5.2はすべてのレベルで10〜19ポイント上回り、回答の質が最も重要な作業に向いています。
lowのFable 5.2は、maxのSolに近いスコア(54対55)を4分の1の時間で出します。- Solは低コストでスコアを出す。 max effortでもインデックスのタスクあたり$1.27で、大量処理や予算重視の作業に向いています。
- Fableはトークンの生成が速い。 出力は毎秒約94〜102トークンで、Solの47〜49トークンを上回ります。
- Artificial AnalysisはFable 5.2の実行に「Default Fallback」と表示しています。 これは、テスト中にAnthropicの拒否時のフォールバックが有効だったことを意味します。
Anthropicの発表時の結果
AnthropicのFable 5.2の表では、OpenAIの最上位ティアであるGPT-6 Astraと比較しています。特記がない限り、各モデルとも利用可能な最高のeffortで測定しています。
| ベンチマーク | 測定対象 | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | エージェント型コーディング | 49.1%(xhigh) | 42.8% |
| FrontierSWE v2 | ソフトウェアエンジニアリング | 69.9% | 65.5% |
| AutomationBench | 業務ワークフロー | 51.4% | 41.4% |
| Terminal-Bench-Science 0.1 | エージェント型の科学研究 | 74.6% | 68.1% |
| OSWorld 2.1(offline set, partial) | コンピューター操作 | 89.3% | 79.5% |
| Remote Labor Index | 実際の有償タスク | 41.3%(high) | 20.8% |
| Humanity's Last Exam(ツールあり) | 高度な推論 | 74.2% | 57.2% |
| Chartography(ツールなし) | チャートの推論 | 73.4% | 71.0% |

effortレベルごとのFrontierCode 2.0のスコアとタスクあたりのコスト。グラフはAnthropicのClaude Fable 5.2発表資料より。
OpenAIの発表時の結果
OpenAIはFable 5.2の6週間前、2026年9月29日にGPT-6.1 Solをリリースし、自社のGPT-6モデルと比較しました。OpenAIはGPT-6.1 Solを、複雑なコーディング、コンピューター操作、専門業務向けのモデルと位置づけており、GPT-6 Astraに迫る能力をAstraの5分の1のトークン単価($2 / $10対$10 / $50)で提供するとしています。発表時の評価は、ソフトウェアエンジニアリング、ドキュメント理解、業務自動化、コンピューター操作を対象としています。
ベンチマークは各社が独自の評価環境とテストバージョンで実行しているため、スコアは1社の表の中で比べ、直接比較には上のArtificial Analysisのインデックスを使ってください。
どちらを選ぶべきか
| ワークロード | 最初に使うモデル | 理由 |
|---|---|---|
| 大量のチャット、情報抽出、ルーティング | mediumのGPT-6.1 Sol(またはより小さなモデル) | Fableの4分の1のトークン単価で短いタスクをこなす |
| 予算を抑えた日常的なコーディングとエージェントループ | GPT-6.1 Sol | コーディングとエージェント作業向けに作られており、公式で$2 / $10、PoYoでは$1.60 / $8 |
| 最も難しい推論、研究、長時間の自律実行 | Fable 5.2 | Intelligence Indexで65対55。Anthropicの表ではGPT-6 Astraを全項目でリード |
| 待ち時間のコストが大きい難しい問題 | lowまたはmediumのFable 5.2 | Solのmaxに近いスコアを4分の1の時間で出す |
| コンピューター操作、チャート、情報密度の高い視覚的ドキュメント | Fable 5.2 | Anthropicの表でOSWorld 2.1が89.3%、Chartographyが73.4% |
| 272Kトークンを超えるプロンプトが多い | コスト重視ならPoYoのGPT-6.1 Sol、深さ重視ならFable 5.2 | PoYoでは両モデルともウィンドウ全体で一律料金:Solは$1.60 / $8、Fableは$6.40 / $32 |
| OpenAIのホスト型ツール(シェル、Web検索、MCP)を前提にした構成 | GPT-6.1 Sol | これらのツールはResponses APIでネイティブに動作する |
| より低価格でClaudeの品質が欲しい | Claude Opus 5.5 | $4 / $20。Claude Fable 5.2とOpus 5.5の比較を参照 |
長時間の自律実行はFable 5.2の得意分野です。このプロトタイプのOSはFable 5.2のエージェントが構築したもので、ノートPCで動かしています。動画はAnthropicのClaude Fable 5.2発表資料より。
実用的なルーティングの例:定型的なトラフィックはmediumのGPT-6.1 Solに送り、より深い推論が効果を発揮するタスクの種類を記録して、それらをmediumのFable 5.2に振り分けます。1週間後には、トークン単価ではなく、合格したタスクあたりのコストを比べてください。中価格帯のClaudeとSolの比較は、GPT-6.1 SolとClaude Opus 5.5の比較をご覧ください。
PoYoで両方を使う
PoYoなら、両方のモデルを手軽に使えます。
- 1つのAPIキーで、Fable 5.2、GPT-6.1 Sol、その他すべてのチャット、画像、動画、音声モデルを利用できます。
- 従量課金。 クレジットでトークン単位に課金され、サブスクリプションは不要です。
- 両方のAPI形式に対応: Anthropic Messagesと、OpenAIのChat CompletionsおよびResponses。
- モデルごとに、コンテキストウィンドウ全体で一律の料金。 それぞれの公式の短いコンテキストの料金より20%安く設定されています。
| 料金項目(100万トークンあたり) | PoYoのClaude Fable 5.2 | PoYoのGPT-6.1 Sol |
|---|---|---|
| 入力 | $6.40 | $1.60 |
| 出力 | $32.00 | $8.00 |
| キャッシュ読み取り | $0.16 | $0.08 |
| キャッシュ書き込み | $8.00(5分) / $12.80(1時間) | $2.00 |
Anthropic Messages形式でFable 5.2を呼び出す例:
curl https://api.poyo.ai/v1/messages \
  -H "x-api-key: $POYO_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "このdiffに並行処理のバグがないかレビューしてください:..."}]
  }'
Responses APIでGPT-6.1 Solを呼び出す例:
curl https://api.poyo.ai/v1/responses \
  -H "Authorization: Bearer $POYO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 16000,
    "input": "このdiffに並行処理のバグがないかレビューしてください:..."
  }'
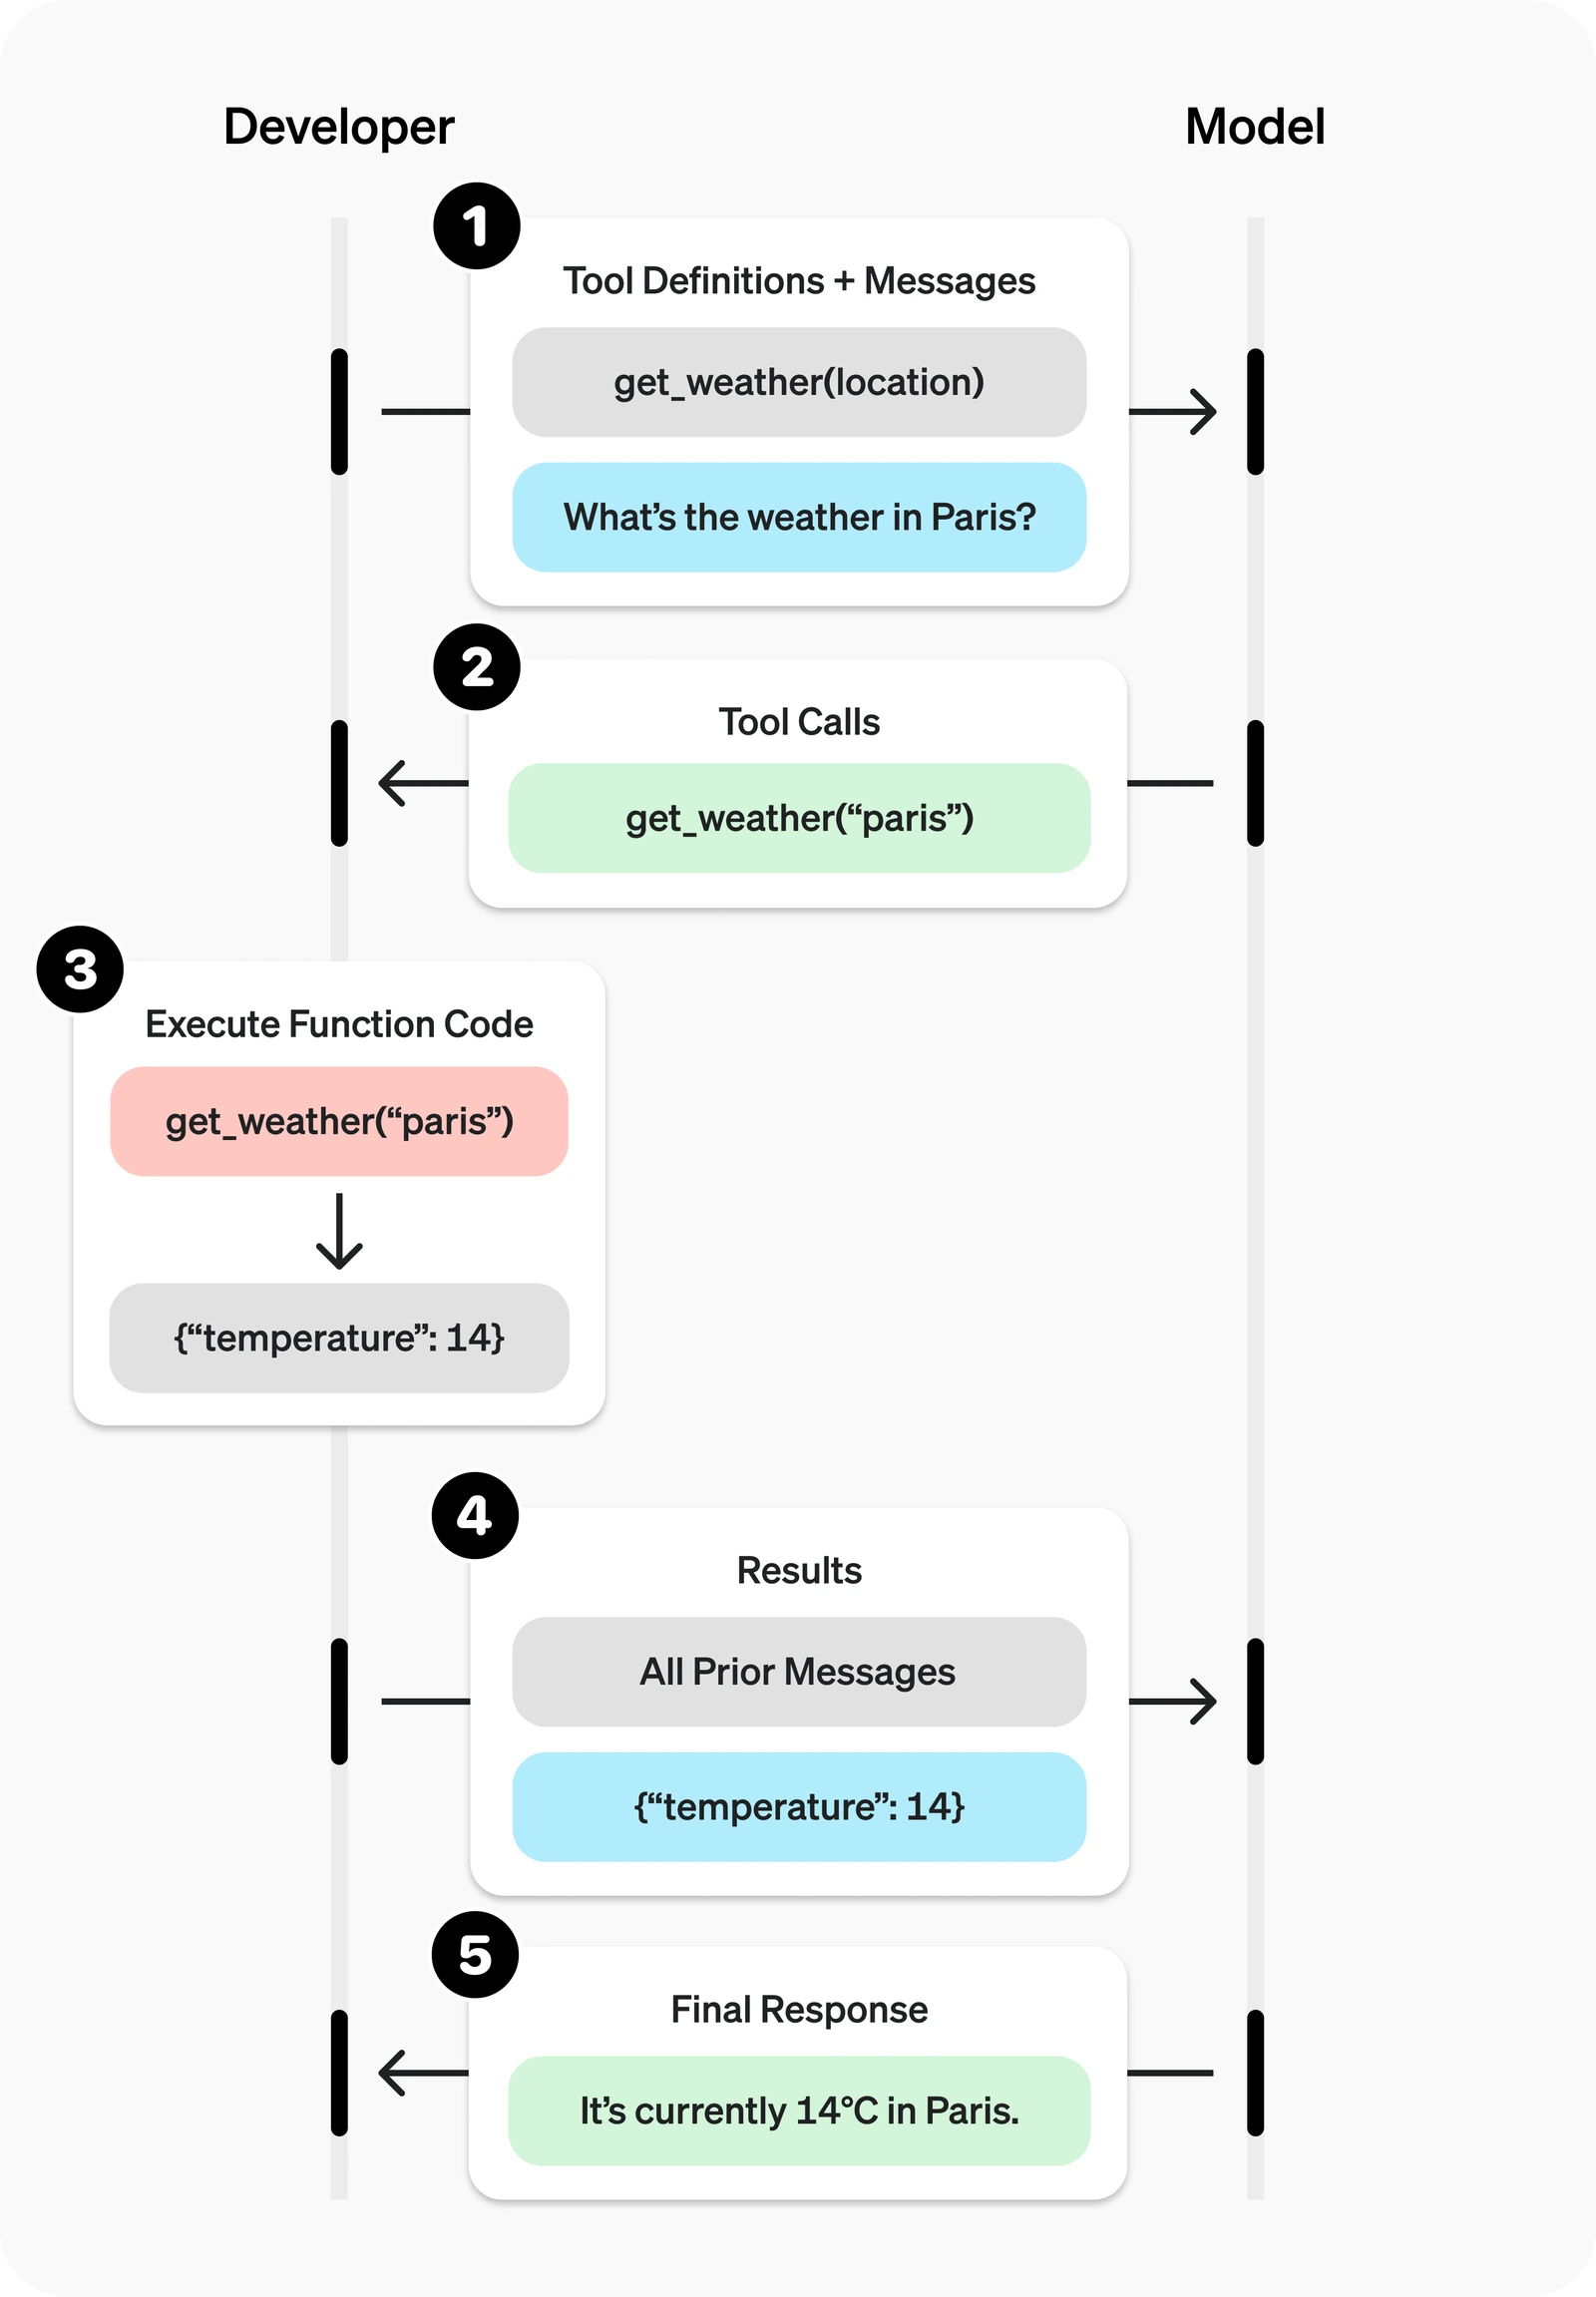
GPT-6.1 Solがツールを使う作業で用いるFunction Callingのループ。図はOpenAIの公式ドキュメントより。
1つのコードパスで両モデルをA/Bテストするには、claude-fable-5-2とgpt-6.1-solを/v1/chat/completionsに送り、modelフィールドだけを変えます。FableのSDK設定、effort、キャッシュについてはClaude Fable 5.2 APIガイドを、Solの上限とツールについてはGPT-6.1 Sol機能ガイドをご覧ください。
モデルページ:Claude Fable 5.2 · GPT-6.1 Sol · GPT-5.6
よくある質問
Fable 5はGPT-5.6 Solより優れていますか?
それぞれ得意な作業が異なりました。2026年7月のテストでは、Fable 5はComposioの複数アプリにまたがるツールワークフロー47件すべてに合格し(GPT-5.6 Solは45件)、GPT-5.6 SolはKiloのシステム設計の計画タスク3件すべてで、より安いトークン単価のまま最高スコアを記録しました。現世代では、Artificial Analysis Intelligence IndexでFable 5.2が65、GPT-6.1 Solが55を記録しており、Solはタスクあたりわずかなコストで済みます。
GPT AstraはFableより優れたモデルになりますか?
GPT-6 Astraはすでに提供されており、料金は100万トークンあたり$10 / $50です。AnthropicのFable 5.2の発表時の表では、両モデルを実行したすべてのベンチマークでFable 5.2がGPT-6 Astraを上回っています。たとえばTerminal-Bench-Science 0.1では74.6%対68.1%、OSWorld 2.1では89.3%対79.5%です。これらはAnthropic自身による測定なので、決める前に自分のタスクで両方を試してください。
GPT-5.6 Lunaは優れていますか?
LunaはGPT-5.6で最も小さく手頃なティアで、高速な大量処理向けに作られています。一方、Solはより難しいタスクに向いています。スループットとコストを重視するならLuna、深さを重視するならSolを選びましょう。現世代では、GPT-6 Lunaの定価は100万トークンあたり$0.10 / $0.50です。
GPT-5.6 Solを使う価値はありますか?
GPT-5.6 Solは1つ前の世代です。新しいプロジェクトには、OpenAIの現行SolモデルであるGPT-6.1 Solが適しています。料金は短いコンテキストで100万トークンあたり$2 / $10、PoYoではコンテキストウィンドウ全体で$1.60 / $8です。GPT-5.6 Solは、すでにこのモデルに合わせて調整済みの連携には引き続き適しています。
Claude Fable 5.2はGPT-6.1 Solより優れていますか?
能力を最大限に求めるならFable 5.2です。Artificial Analysis Intelligence Indexでは、すべてのeffortレベルで10〜19ポイント上回っています。コストを重視するならGPT-6.1 Solです。トークン単価は4分の1で、max effortではインデックスのタスクあたりのコストが約20分の1です。
Fable 5.2とGPT-6.1 Sol、どちらが安いですか?
GPT-6.1 Solです。公式料金は入力/出力100万トークンあたり$2 / $10で、Fable 5.2の$8 / $40に対して安くなっています。入力が272Kトークンを超えると、OpenAIはSolのリクエスト全体を$4 / $15に引き上げますが、Fableは$8 / $40のままです。PoYoでは、Solはプロンプトの長さにかかわらず$1.60 / $8です。
コーディングにはどちらが向いていますか?
両社はそれぞれ異なるベンチマークでコーディングの結果を報告しています。AnthropicはFable 5.2がFrontierCode 2.0で49.1%を記録し、GPT-6 Astraを上回ったと報告しています。OpenAIはGPT-6.1 Solを、Astraの5分の1のトークン単価で複雑なコーディングをこなすモデルとして作りました。大量の定型的なコーディングにはSol、大規模で長時間にわたる変更にはFable 5.2を使うのが妥当なデフォルトです。自分のチケットのサンプルで両方を試してみてください。
どちらのモデルも1Mのコンテキストウィンドウに対応していますか?
はい、おおむね同じです。Fable 5.2は1Mトークンのウィンドウを備えています。GPT-6.1 Solは1,050,000トークンのウィンドウで、入力は最大922,000トークンです。どちらも1リクエストあたり最大128Kの出力トークンを生成できます。