
01
複雑なコーディングとソフトウェアエンジニアリング
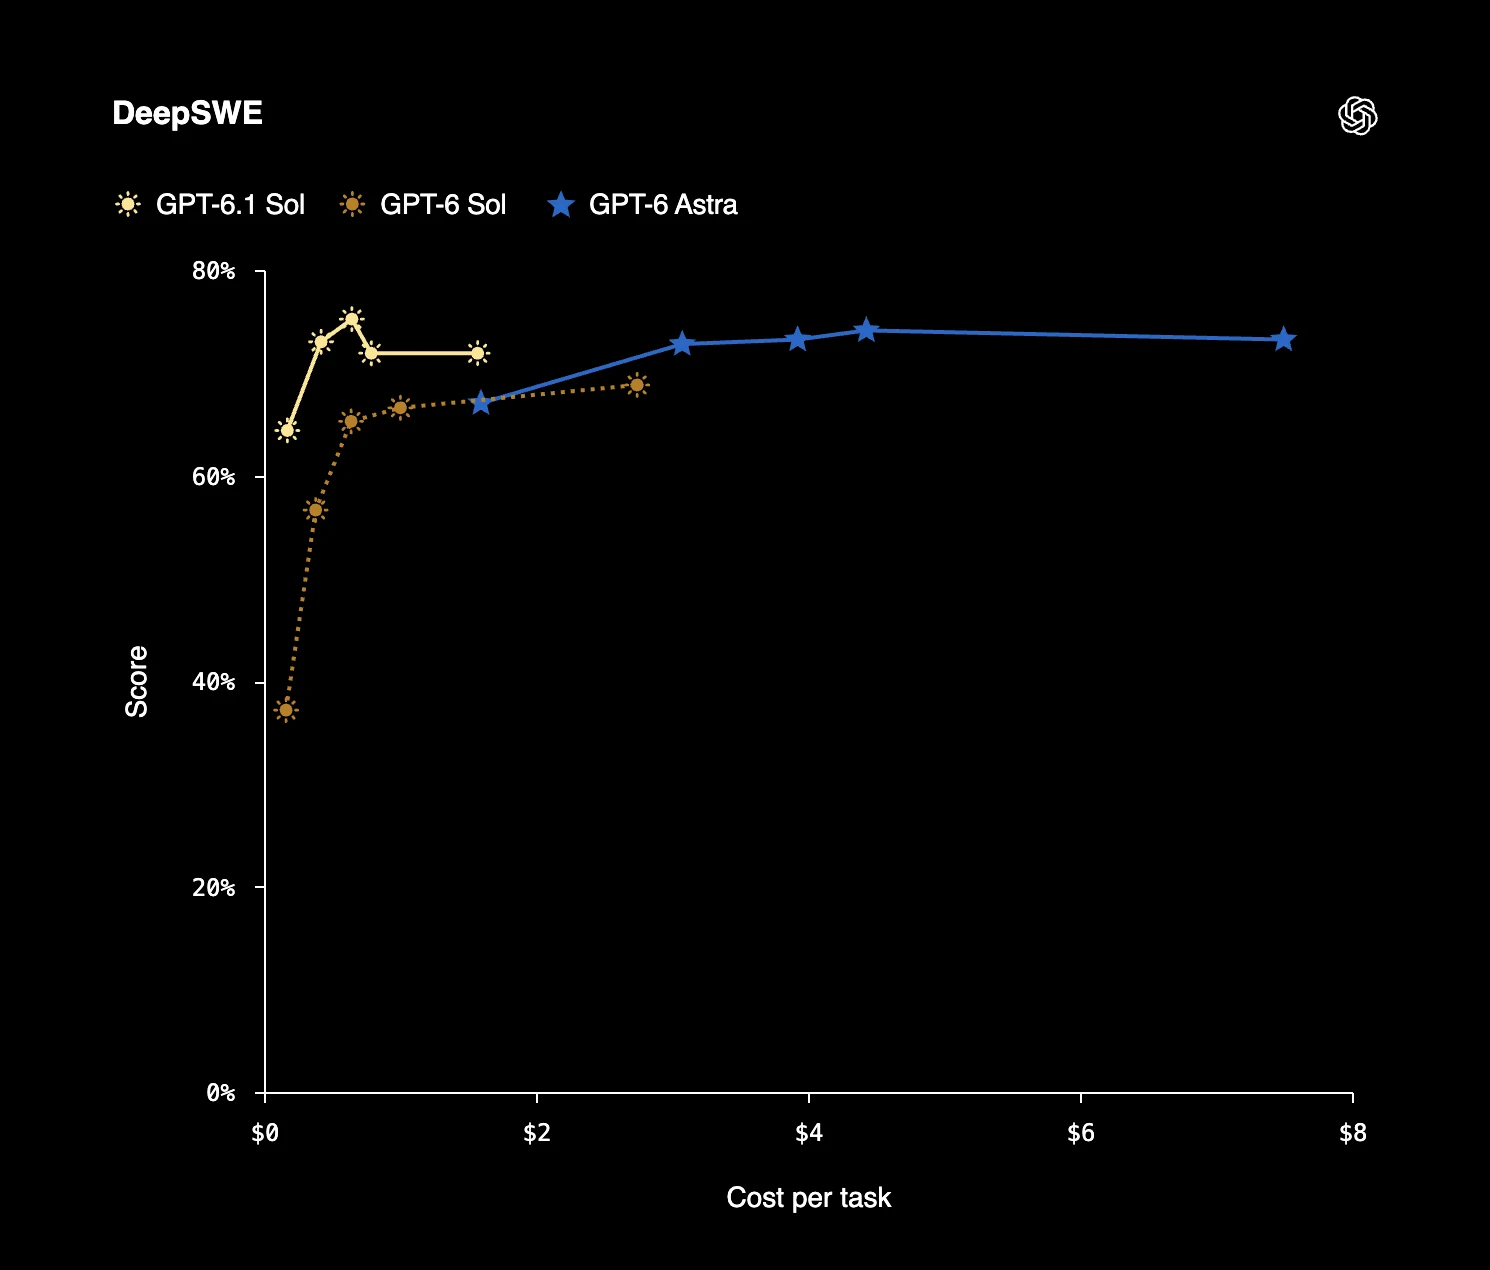
GPT-6.1 Sol はコードベースの調査、障害原因の追跡、複数ファイルの編集、長期の開発タスクにおける変更の検証に対応します。OpenAI の DeepSWE v1.1 評価では GPT-6 Astra と同等の結果に達し、より低い推論レベルで GPT-6 Sol の最高スコアを 6.4 パーセントポイント上回りました。
- 複数ファイルにまたがるコードを調査
- 範囲を定めた変更を実装・検証
- 長時間稼働するコーディングエージェントを支援
コーディング、文書分析、コンピューター操作、複数ステップのエージェントを一つのモデルで
GPT-6.1 Sol は、複雑なコーディング、コンピューター操作、専門的な業務に向けた OpenAI の Sol モデルです。コードの調査、ツールの利用、詳細な文書の読解を行い、複数ステップにわたるタスクを進めるエージェントを支えます。
最大 1,050,000 トークンのコンテキストウィンドウと調整可能な推論レベルにより、開発者は大規模なコードベースや長い資料を扱えます。OpenAI は、ソフトウェアエンジニアリング、文書理解、業務自動化、コンピューター操作の評価で GPT-6 Sol を上回る結果を報告しています。
コード、文書、アプリケーションを横断して作業する開発チームとエージェントのための機能。
01
GPT-6.1 Sol はコードベースの調査、障害原因の追跡、複数ファイルの編集、長期の開発タスクにおける変更の検証に対応します。OpenAI の DeepSWE v1.1 評価では GPT-6 Astra と同等の結果に達し、より低い推論レベルで GPT-6 Sol の最高スコアを 6.4 パーセントポイント上回りました。
02
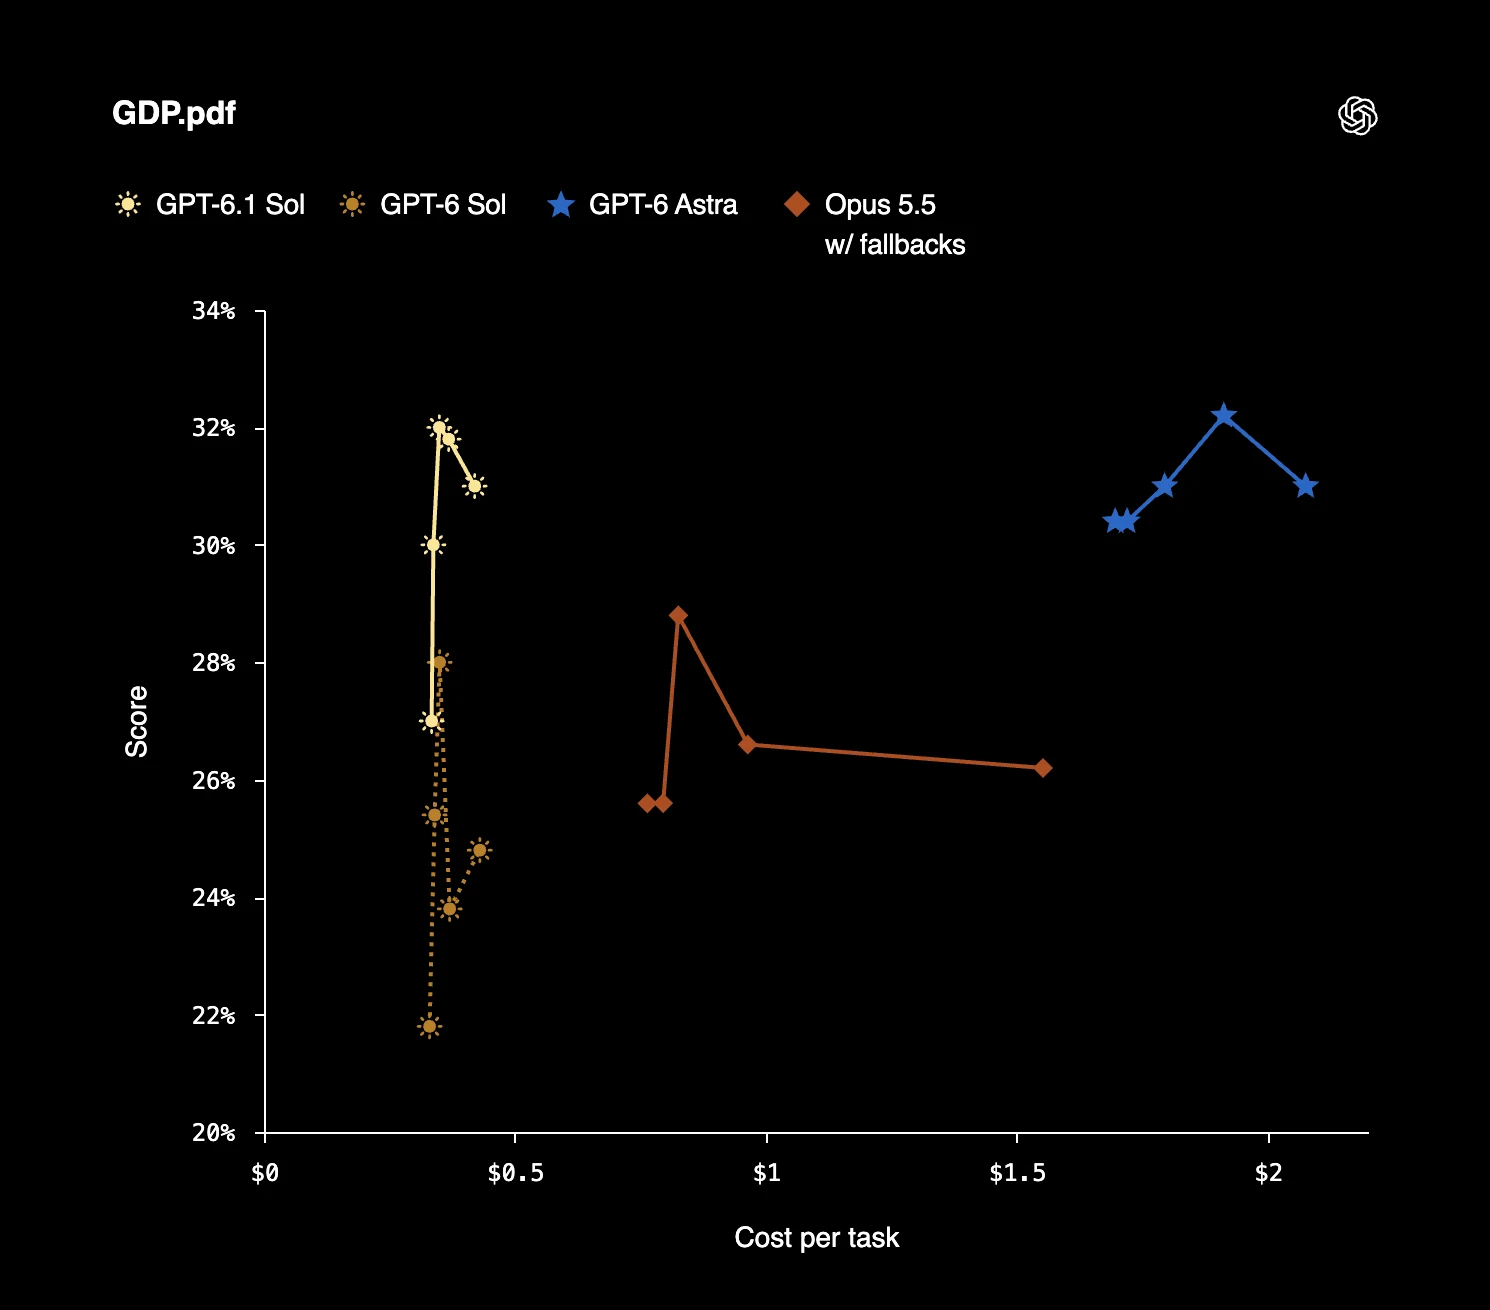
GPT-6.1 Sol は、表、グラフ、図、細かな注記を含む詳細な PDF を扱えます。多数のツールを使う複数ステップの業務フローも調整できます。OpenAI は、GDP.pdf で GPT-6 Sol を上回り、中程度の推論レベルでの AutomationBench では 4.8 ポイント改善したと報告しています。
03
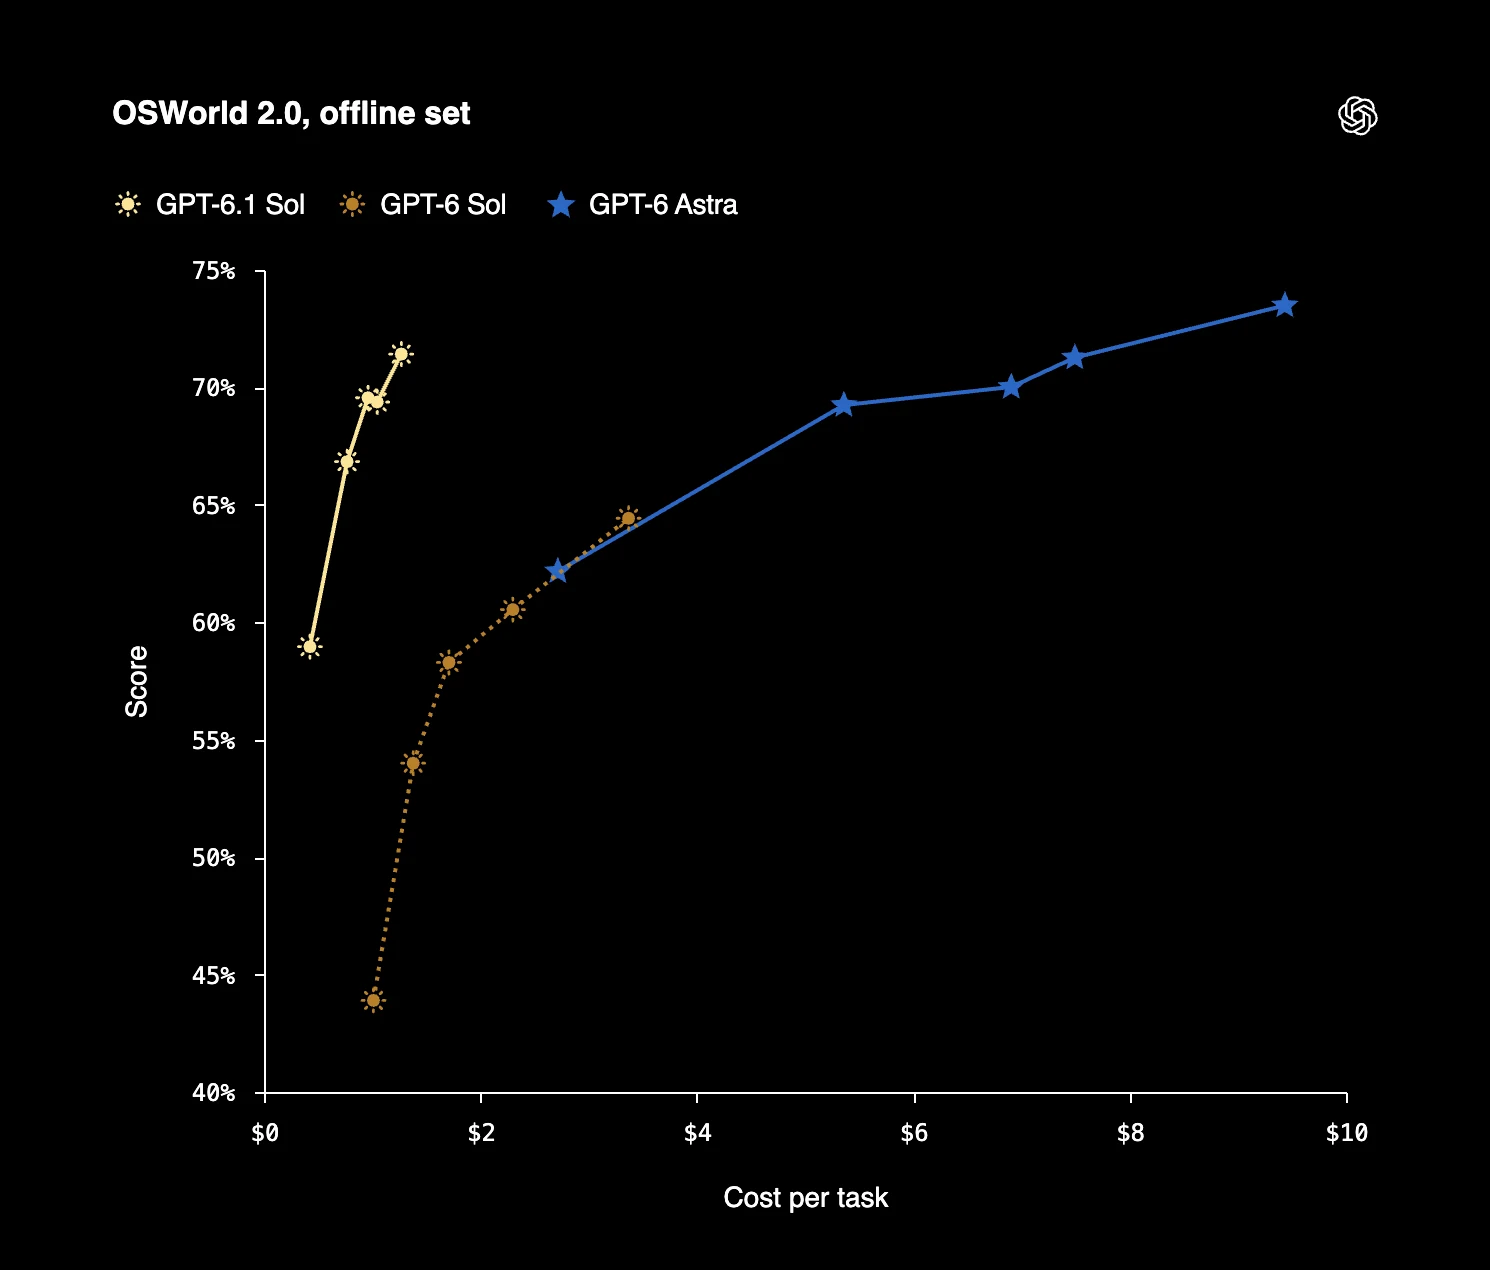
GPT-6.1 Sol は視覚的な状況を理解し、エージェントワークフローの一部としてアプリケーションの画面を操作できます。OpenAI によると、オフラインの OSWorld 2.0 評価では最大の推論レベルで GPT-6 Sol を 7 ポイント上回りました。スクリーンショットの理解、画面操作、結果の確認を一つのプロセスにつなげられます。
04
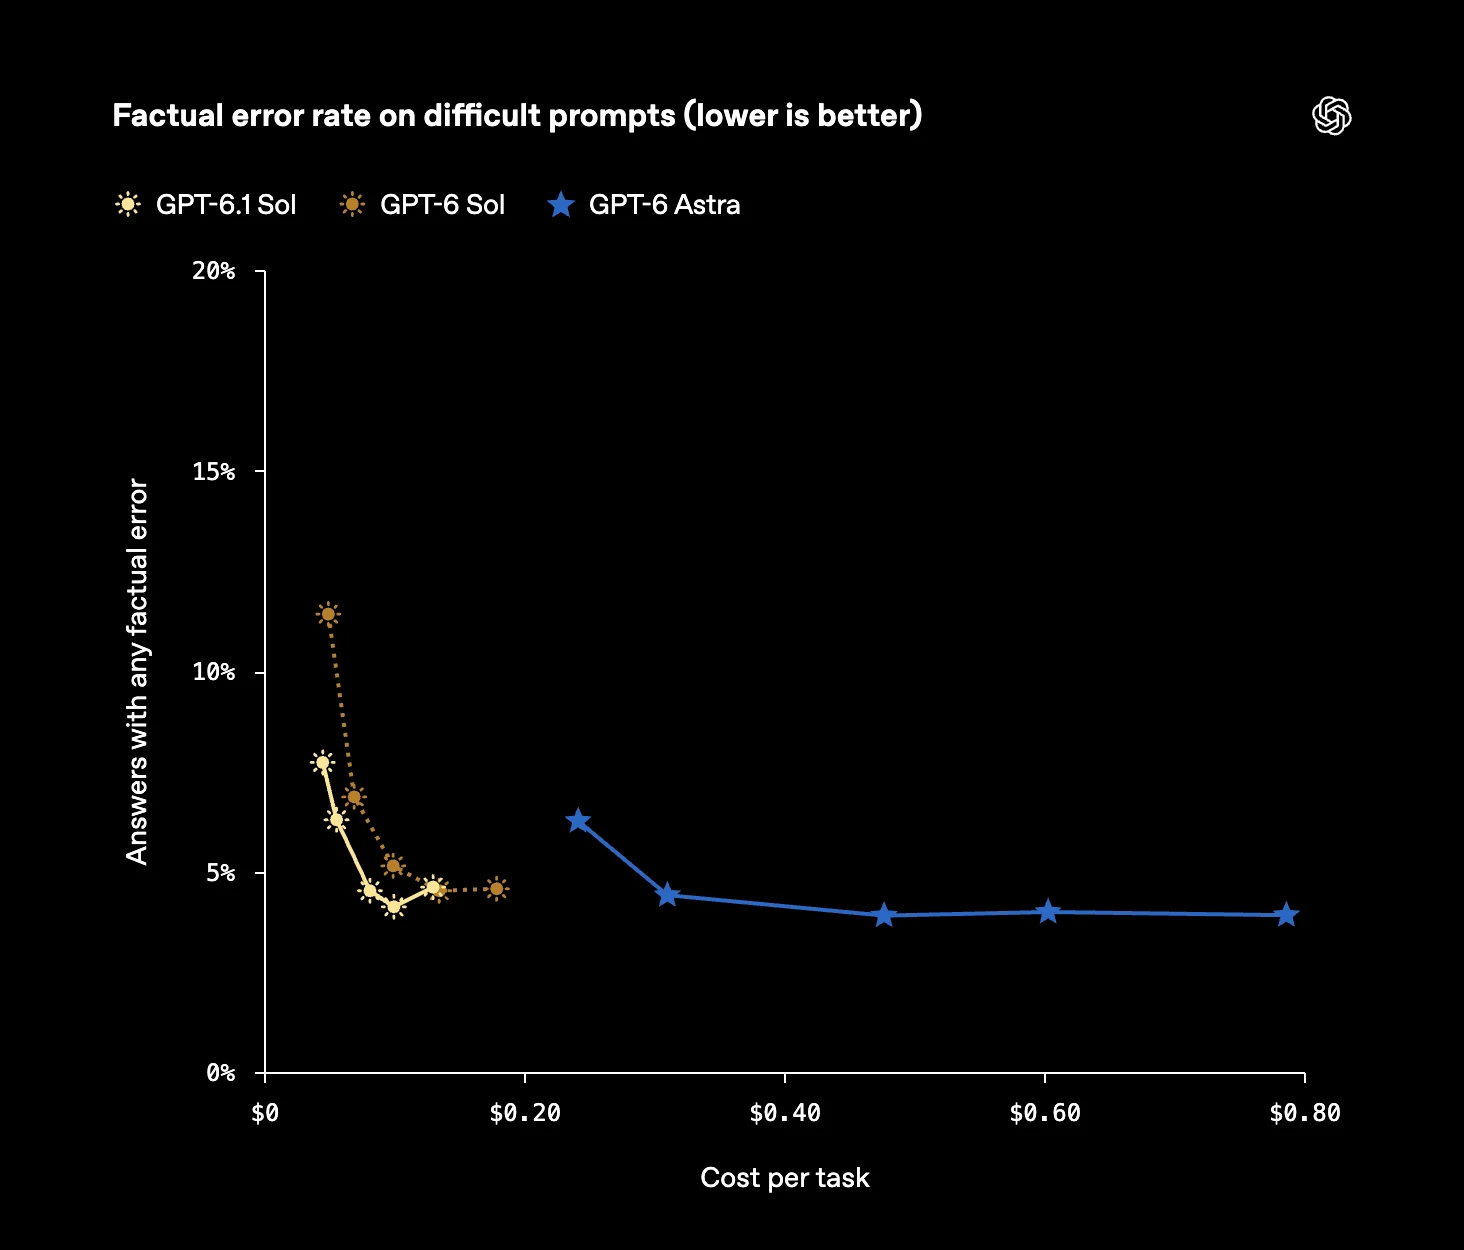
GPT-6.1 Sol は最大 1,050,000 トークンのコンテキストを受け取り、最大 128,000 トークンを出力します。開発者はタスクに応じて low、medium、high、xhigh、max の推論レベルを選択できます。OpenAI の事実の正確性に関する評価では、低い推論レベルでもより信頼できる回答を示しています。大規模なリポジトリ、長いレポート、継続的なエージェントセッションに対応します。
GPT-6.1 Sol を使ってリポジトリの調査、機能の実装、不具合の修正、複数ファイルにまたがる変更のレビューを進められます。
手順を計画し、ツールを呼び出し、結果を確認して、以前の操作を踏まえて作業を続けるエージェントを構築できます。
詳細な PDF を分析し、グラフと文章の根拠を組み合わせて、出典に基づく要約を作成できます。
スクリーンショットとアプリケーションの状態を使って画面を調べ、手順を実行し、確認できる結果を検証できます。
ツール、文書、引き継ぎをまたぐ反復可能な業務プロセスを調整し、各ステップを追跡できます。
コードと反復的な確認が必要な分析、シミュレーション、研究をターミナル上で進められます。
| 能力 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
| モデルの主な用途 | 複雑なコーディング、コンピューター操作、専門的なワークフロー | 複雑なコーディングとエージェントワークフロー | 最も要求の厳しいエンドツーエンドのタスク |
| DeepSWE v1.1 | Astra と同等。Sol の最高スコアより 6.4 パーセントポイント高い | 6.1 Sol はこのモデルの最高スコアより 6.4 パーセントポイント高い | 6.1 Sol と同等 |
| OSWorld 2.0 オフライン(最大推論レベル) | Sol より 7 パーセントポイント高く、Astra との差は 2.1 ポイント | 6.1 Sol は 7 パーセントポイント高い | 6.1 Sol より 2.1 パーセントポイント高い |
| Terminal-Bench Science 0.1(最大推論レベル) | Sol のスコアの 2 倍超 | 6.1 Sol はこの結果の 2 倍超 | 公表された最高スコア:68.1% |
| 事実誤認率(低推論レベル) | 7.7% | 11.4% | 検証された推論レベルでは 6.1 Sol との差は 1.9 パーセントポイント以内 |
| 公式料金 · 通常入力 / 100 万トークン | $2.00 | $2.00 | $10.00 |
| 公式料金 · キャッシュ入力 / 100 万トークン | $0.10 | $0.20 | $1.00 |
| 公式料金 · キャッシュ書き込み / 100 万トークン | $2.50 | $2.50 | $12.50 |
| 公式料金 · 通常出力 / 100 万トークン | $10.00 | $10.00 | $50.00 |
PoYo のほかのモデルと並べて GPT-6.1 Sol を見つけ、コーディング、文書、コンピューター操作、エージェントの機能を一か所で確認できます。
OpenAI が公開したベンチマークを使い、チームのタスクに合わせて GPT-6.1 Sol、GPT-6 Sol、GPT-6 Astra を比較できます。
長いコンテキストの入力、推論レベル、ツールの利用手順を、コーディングやエージェントのワークフローにどう組み込むか計画できます。
PoYo での GPT-6.1 Sol の提供予定を確認し、このページを統合準備に役立ててください。